预备知识
位运算知识
位运算操作是由处理器支持的底层操作,底层硬件只支持01这样的数字,因此位运算运行速度很快。尽管现代计算机处理器拥有了更长的指令流水线和更优的架构设计,使得加法和乘法运算几乎与位运算一样快,但是位运算消耗更少的资源。常用的位运算如下:
- 位与 &
(1&1=1 1&0=0 0&0=0)
- 位或 |
(1|1=1 1|0=1 0|0=0)
- 位非 ~
( ~1=0 ~0=1)
- 位异或 ^
(1^1=0 1^0=1 0^0=0)
- 有符号右移 >>
在执行右移操作时,若参与运算的数字为正数,则在高位补0;若为负数,则在高位补1。
- 无符号右移 >>>
无论参与运算的数字为正数或为负数,在执运算时,都会在高位补0。
- 左移
对于左移是没有正数跟负数这一说的,因为负数在CPU中是以补码的形式存储的,对于正数左移相当于乘以2的N次幂。
敲重点:上面的重重都是简单的只是为了引出下面的结论:
a % (Math.pow(2,n))等价于a&( Math.pow(2,n)-1)
比如a%16最终的结果一定是0~15之间的数字,而a&1111正好把a除16后的余数有效的现实出来了因为如果是1 1111这样的话最前面一位其实代表的16,也就是说二进制从倒数第五位开始只要出现了1那绝对代表的是16的倍数。
结论:位运算比除法运算在运行效率上更高,对一个数取余尽量用a&二进制数这样可以更好的提速。
ArrayList
我们知道ArrayList是一个数组队列,相当于动态数组。与Java中的基本数组相比,它的容量能动态增长。它具有以下几个重点。
- ArrayList 实际上是通过一个数组去保存数据的。当我们构造ArrayList时;若使用
默认构造函数,则ArrayList的默认容量大小JDK7=10,JDK8=0。 - 当ArrayList容量不足以容纳全部元素时,ArrayList会重新设置容量:原来容量的
1.5倍。 - ArrayList的克隆函数,即是将全部元素克隆到一个数组中。
- 克隆的底层是System.arraycopy(0,oldsrc,0,newsrc,length);
- ArrayList实现java.io.Serializable的方式。当写入到输出流时,先写入“容量”,再依次写入“每一个元素”;当读出输入流时,先读取“容量”,再依次读取“每一个元素”。
- ArrayList是线程不安全的,可以用
Vector实现线程安全级别的动态数组 初始值为10,扩容为2倍,底层用synchronized实现的!
优点:
- 根据下标遍历元素效率较高。
- 根据下标访问元素效率较高。
- 在数组的基础上封装了对元素操作的方法。
- 这样的动态数组在内地地址上是空间连续的。
- 可以自动扩容。
缺点:
- 插入和删除的效率比较低。
- 根据内容查找元素的效率较低。
- 扩容规则:每次扩容现有容量的50%。
LinkedList
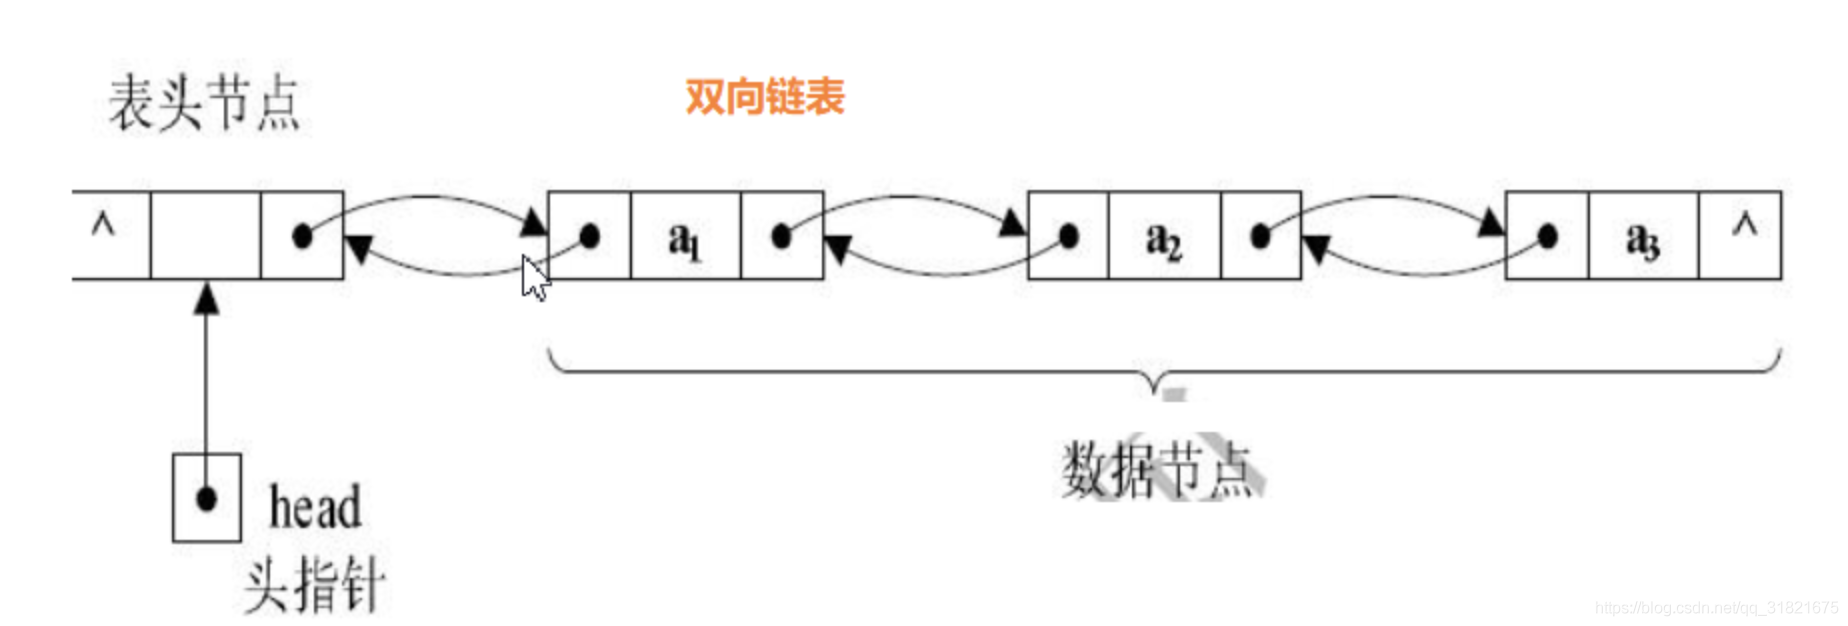
双向链表每一个节点包含三部分(data,prev,next),它不要求空间是连续的。类似于节点跟节点之间通过前后两条线串联起来的。
ArrayList和LinkedList总结:
- ArrayList是实现了基于动态数组的数据结构,LinkedList是基于链表结构。
- 对于随机访问的get和set方法,ArrayList要优于LinkedList,因为LinkedList要移动指针。
- 对于新增和删除操作add和remove,LinkedList比较占优势,因为ArrayList要移动数据。
- ArrayList使用在查询比较多,但是插入和删除比较少的情况,而LinkedList用在查询比较少而插入删除比较多的情况
RedBlackTree
首先你需要对二叉树有个了解,知道这是什么样子的一个数据组合方式,然后知道二叉树查找的时候缺点,可能发生数据倾斜。因此引入了平衡二叉树,平衡二叉树的左右节点深度之差不会超过1,查找方便构建麻烦,因此又出现了红黑树。红黑树是一种平衡的二叉查找树,是一种计算机科学中常用的数据结构,最典型的应用是实现数据的关联,例如map等数据结构的实现,红黑树重要特性是( 左节点 < 根节点 < 右节点)
红黑树有以下限制:
- 节点必须是红色或者是黑色
- 根节点是黑色的
- 所有的叶子节点是黑色的。
- 每个红色节点的两个子节点是黑色的,也就是不能存在父子两个节点全是红色
- 从任意每个节点到其每个叶子节点的所有简单路径上黑色节点的数量是相同的。
如果您对红黑树还不太了解推荐看下博主以前写的RBT
HashTable
Hash表是一种特殊的数据结构,它同数组、链表以及二叉排序树等相比较有很明显的区别,它能够快速定位到想要查找的记录,而不是与表中存在的记录的关键字进行比较来进行查找。这个源于Hash表设计的特殊性,它采用了函数映射的思想将记录的存储位置与记录的关键字关联起来,从而能够很快速地进行查找。评价函数的性能关键在于装填因子,以及如何合理的解决哈希冲突,具体的可看博主以前写的彻底搞定哈希表
HashMap源码剖析
概述
通常具备前面一些知识点的铺垫就可以很好的开展HashMap的讲解了,既然ArrayList,LinkedList,Red Black Tree各有优缺点,我们能不能集百家之长实现一个综合产物呢 === >HashMap,本文所以讲解都是基于JDK8。
HashMap的组成部分:数组 + 链表 + 红黑树。HashMap的主干是一个Node数组。Node是HashMap的基本组成单元,每一个Node包含一个key-value键值对。HashMap的时间复杂读几乎可以接近O(1)(如果出现了 哈希冲突可能会波动下),并且HashMap的空间利用率一般就是在40%左右。HashMap的大致图如下:
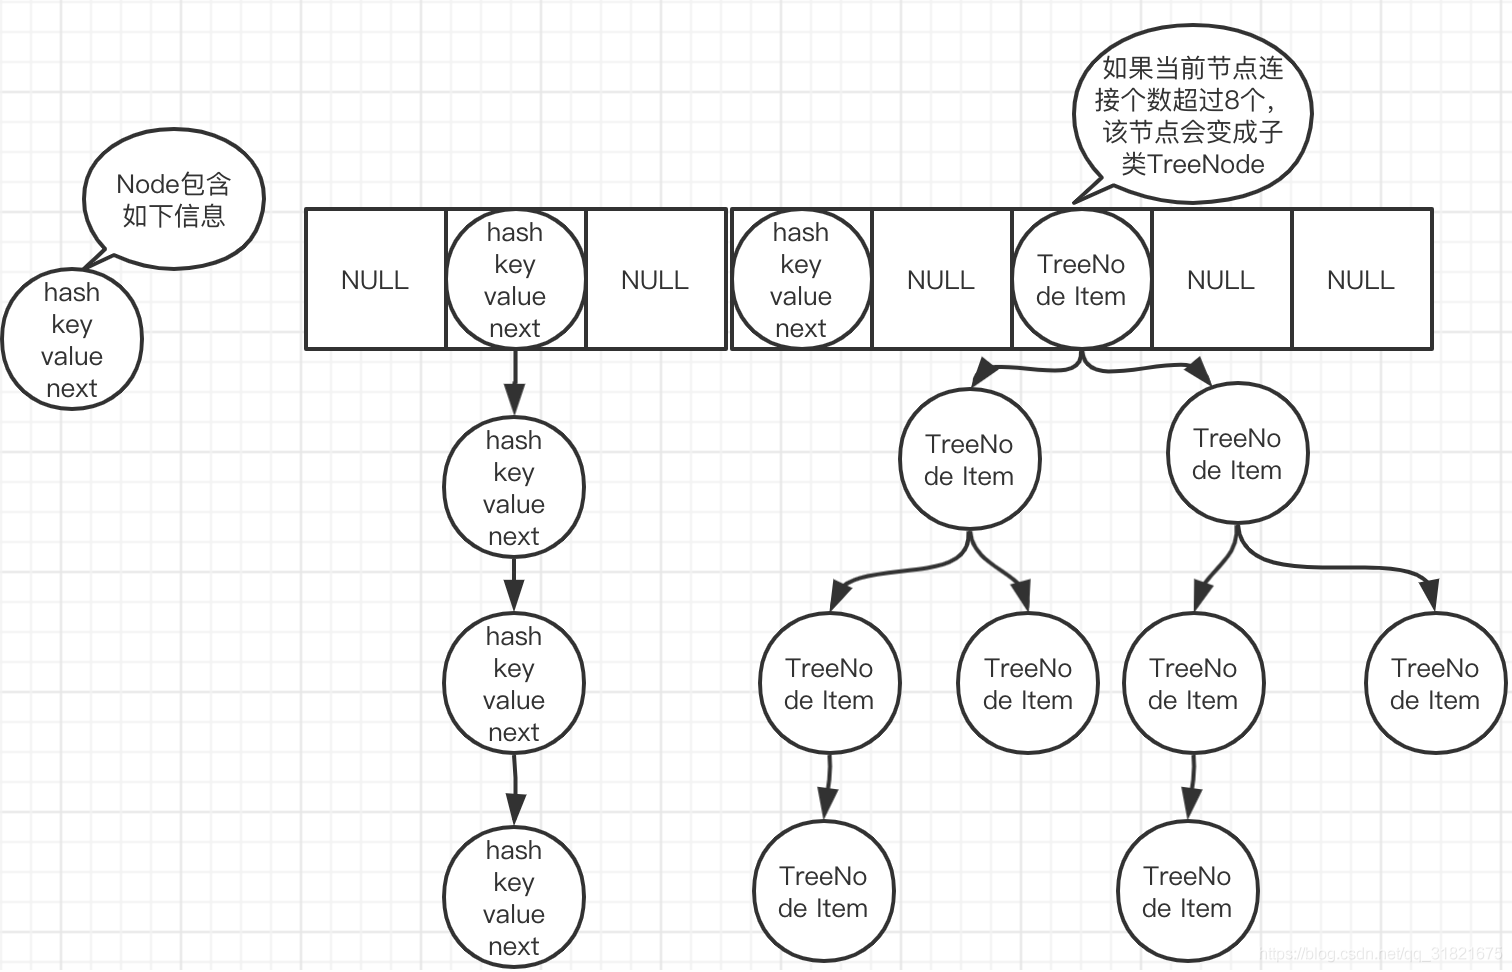
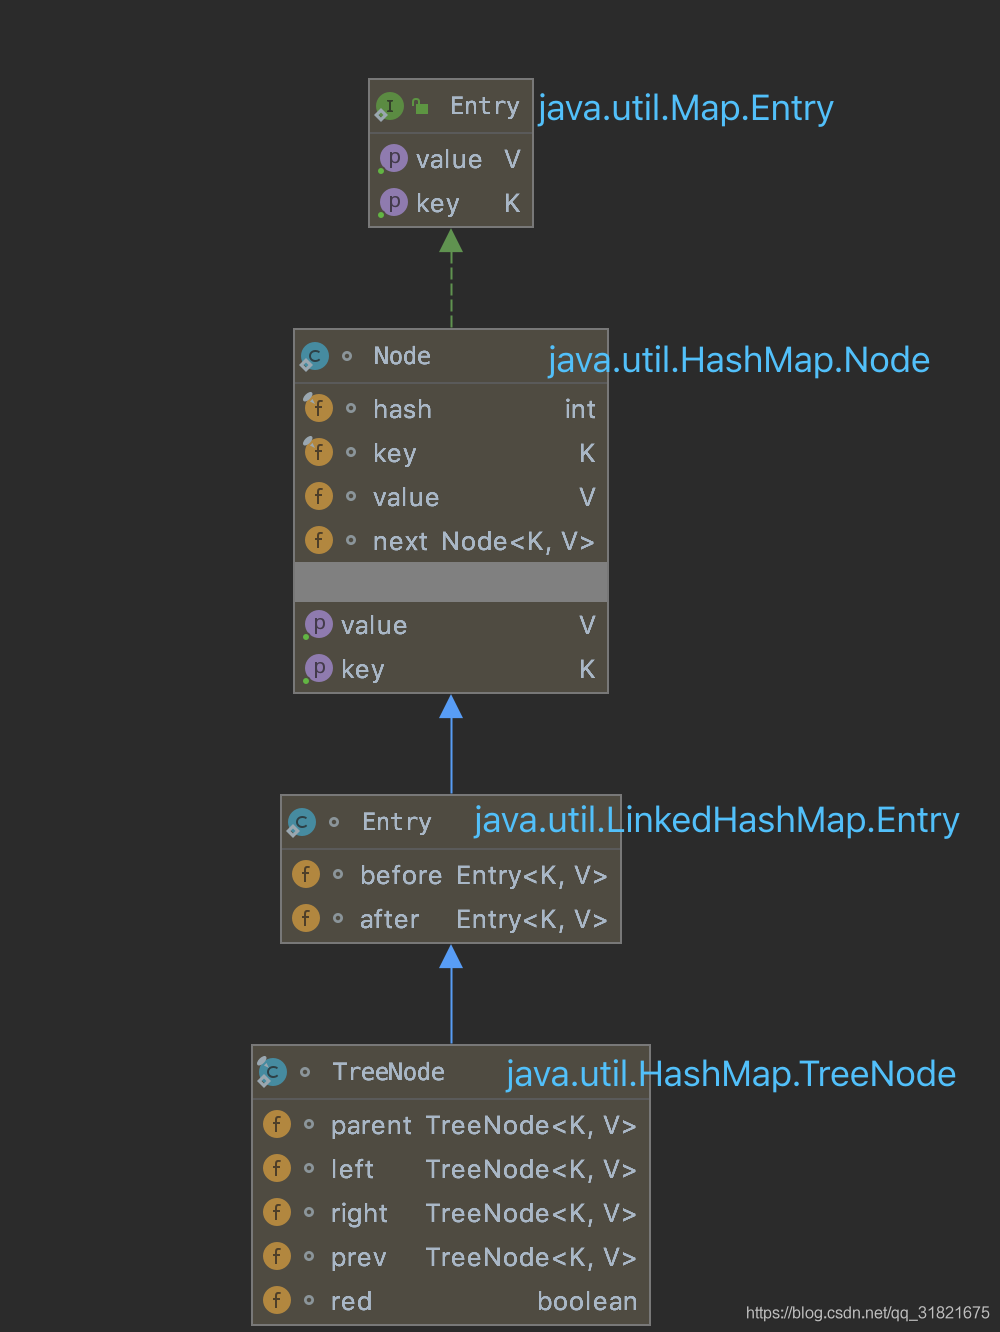
PS:其中几个重要节点关系如下:
- java.util.Map.Entry
这就是个interface定义了一些比较的接口函数。
- java.util.HashMap.Node
就是我们HashMap中存储的基本的KV。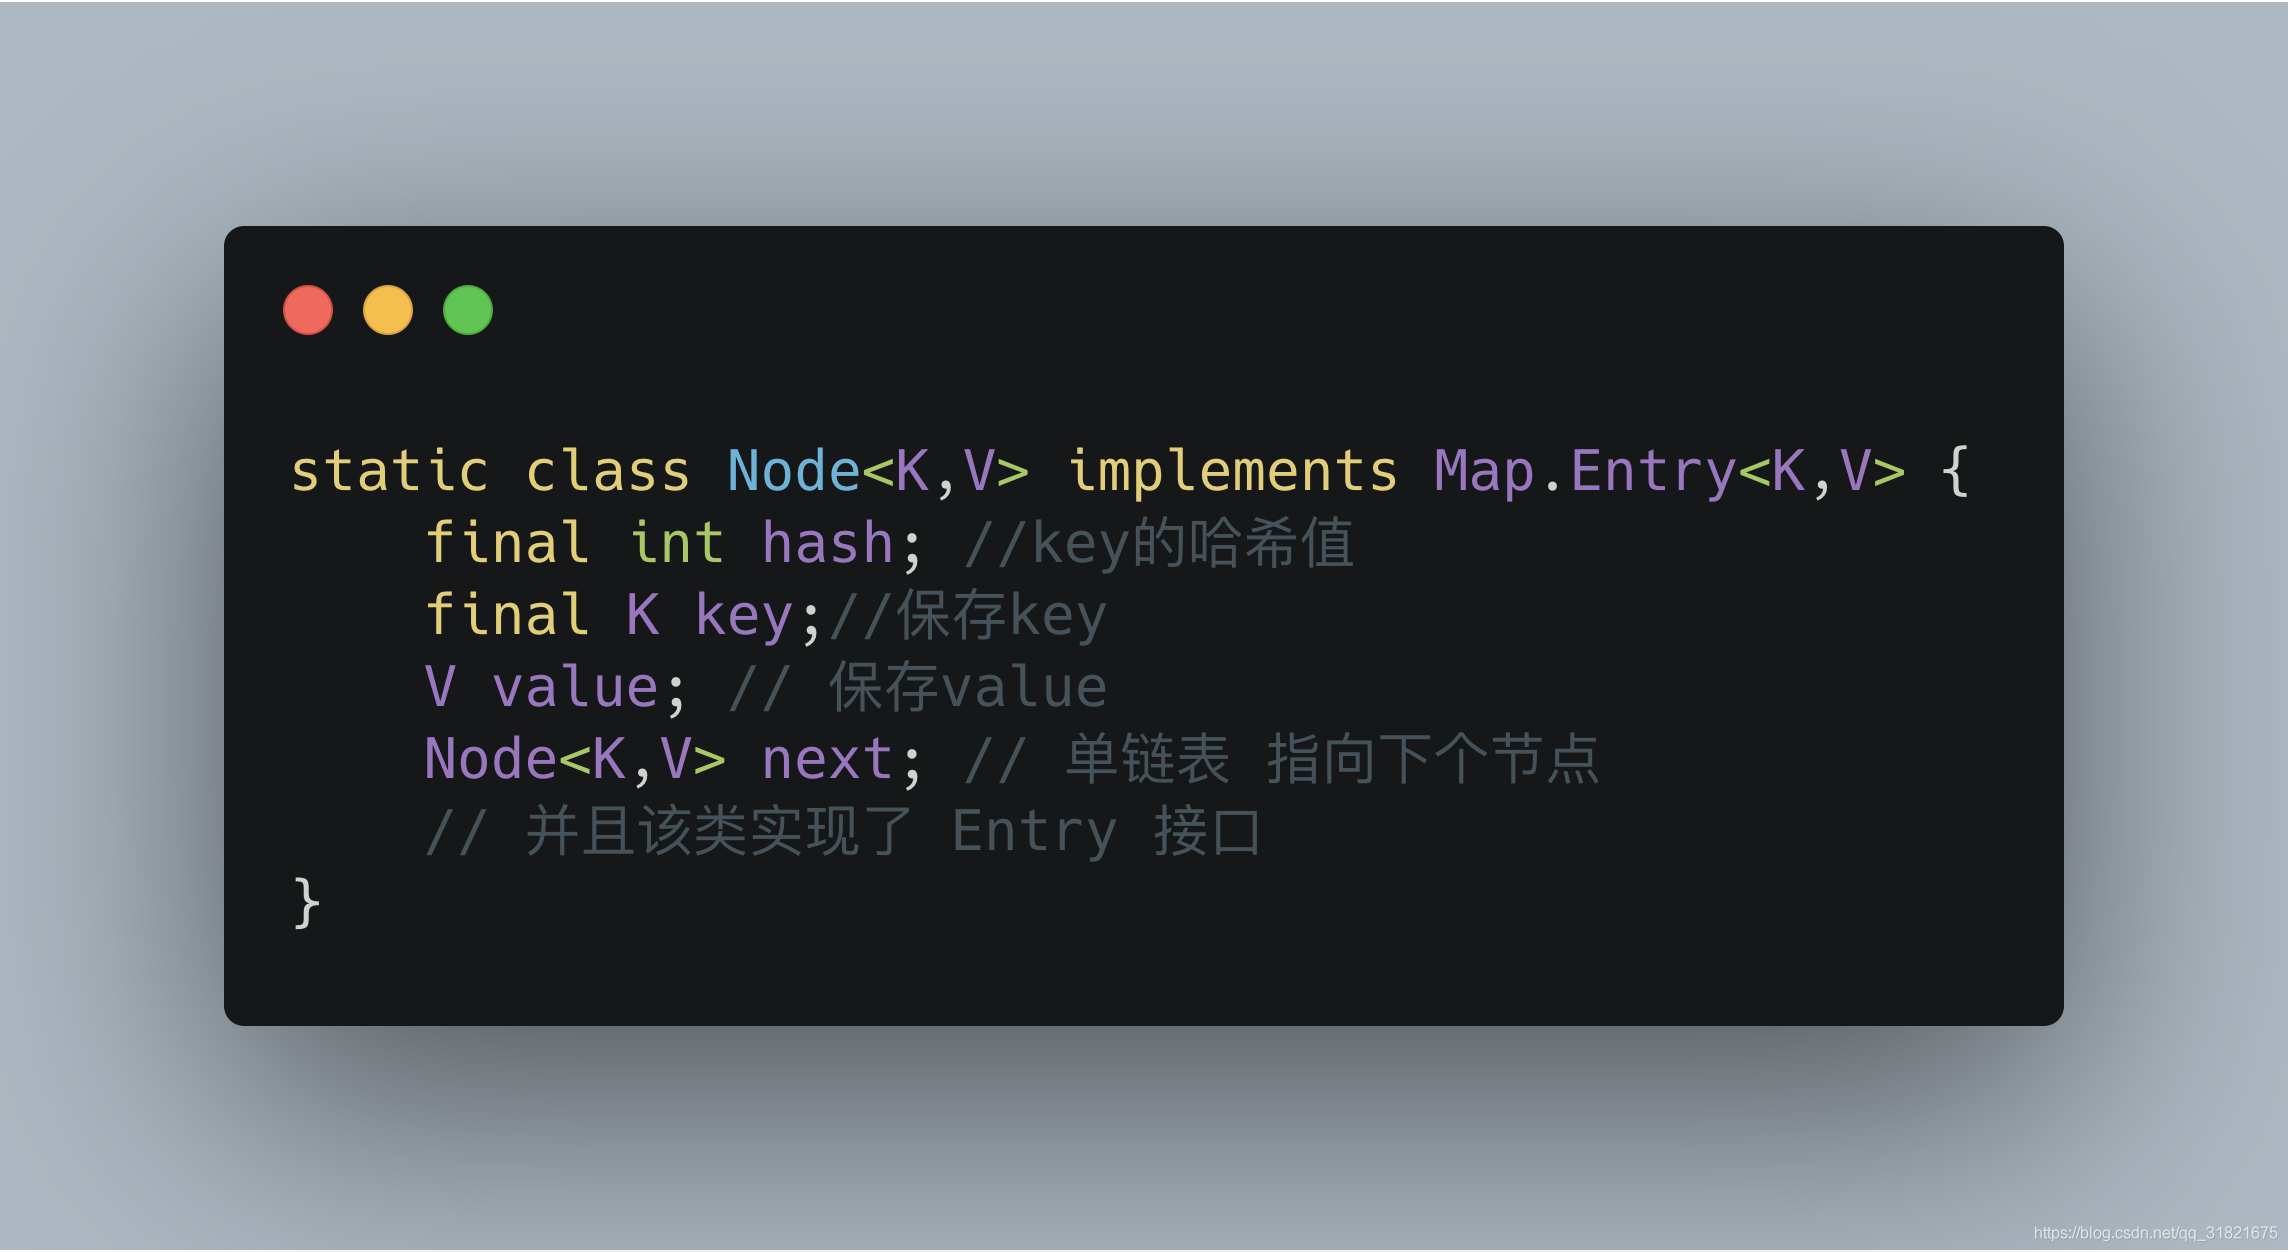
- java.util.LinkedHashMap.Enrty
Enrty这个类继承自HashMap.Node这个类,Enrty是LIinkedHashMap的一个内部类,
- java.util.HashMap.TreeNode
TreeNode的构造函数向上追溯继承了LinkedHashMap.Entry,而后者又继承了HashMap.Node。所以TreeNode既保有Node的属性,同时由于添加了prev这个前驱指针使得链表变为了双向。前三个节点跟第五个红黑树相关,第四个跟next跟双向链表相关。
数据存储的大致步骤有三步。 - 每个数据通过
HashTable里的映射函数来决定将该数据放到数组的那个地方,数组初始化时候一定是2的次幂,默认16,初始化传入的任何数字都会经过tableSizeFor调整为2次幂。 - 如果同一个数组的地方被分配到太多数据就用链表法来解决哈希冲突。
- 如果同一个节点的链表数据节点个数 >
TREEIFY_THRESHOLD=8且数组长度 >=MIN_TREEIFY_CAPACITY=64,则会将该链表进化位RedBlackTree,如果RedBlackTree中节点个数小于UNTREEIFY_THRESHOLD=6会退化为链表。
特别提醒:读HashMap源码之前需要知道它大致特性如下:
- HashMap的存取是没有顺序的
- KV均允许为NULL
- 多线程情况下该类安全,可以考虑用HashTable。
- JDk8底层是数组 + 链表 + 红黑树,JDK7底层是数组 + 链表。
- 初始容量和装载因子是决定整个类性能的关键点,轻易不要动。
- HashMap是懒汉式创建的,只有在你put数据时候才会build
- 单向链表转换为红黑树的时候会先变化为双向链表最终转换为红黑树,双向链表跟红黑树是
共存的,切记。- 对于传入的两个
key,会强制性的判别出个高低,判别高低主要是为了决定向左还是向右。- 链表转红黑树后会努力将红黑树的
root节点和链表的头节点 跟table[i]节点融合成一个。- 在删除的时候是先判断删除节点红黑树个数是否需要转链表,不转链表就跟
RBT类似,找个合适的节点来填充已删除的节点。- 红黑树的
root节点不一定跟table[i]也就是链表的头节点是同一个哦,三者同步是靠MoveRootToFront实现的。而HashIterator.remove()会在调用removeNode的时候movable=false。
重要参数
静态参数
- static final int DEFAULT_INITIAL_CAPACITY = 1 << 4
初始容量,默认容量=16,箱子的个数不能太多或太少。如果太少,很容易触发扩容,如果太多,遍历哈希表会比较慢。
- static final int MAXIMUM_CAPACITY = 1 << 30
数组的最大容量,一般情况下只要内存够用,哈希表不会出现问题
- static final float DEFAULT_LOAD_FACTOR = 0.75f
默认的负载因子。因此初始情况下,当存储的所有节点数 > (16 * 0.75 = 12 )时,就会触发扩容。
默认负载因子(0.75)在时间和空间成本上提供了很好的折衷。较高的值会降低空间开销,但提高查找成本(体现在大多数的HashMap类的操作,包括get和put)。设置初始大小时,应该考虑预计的entry数在map及其负载系数,并且尽量减少rehash操作的次数。如果初始容量大于最大条目数除以负载因子,rehash操作将不会发生。
从上面的表中可以看到当桶中元素到达8个的时候,概率已经变得非常小,也就是说用0.75作为加载因子,每个碰撞位置的链表长度超过8个是几乎不可能的。
- static final int TREEIFY_THRESHOLD = 8
这个值表示当某个箱子(数组的某个item)中,链表长度 >= 8 时,有可能会转化成树。设置为8,是系统根据泊松分布的数据分布图来设定的。
- static final int UNTREEIFY_THRESHOLD = 6
在哈希表扩容时,如果发现链表长度 <= 6,则会由树重新退化为链表。
设置为6猜测是因为时间和空间的权衡
当链表长度为6时 查询的平均长度为 n/2=3,红黑树 log(6) = 2.6
为8时 :链表 8/2=4, 红黑树 log(8)=3
- static final int MIN_TREEIFY_CAPACITY = 64
链表转变成树之前,还会有一次判断,只有数组长度大于 64 才会发生转换。这是为了避免在哈希表建立初期,多个键值对恰好被放入了同一个链表中而导致不必要的转化。
动态参数
- transient Node<K,V>[] table
HashMap的链表数组。无论我们初始化时候是否传参,它在自扩容时总是2的次幂。
- transient Set<Map.Entry<K,V>> entrySet
HashMap实例中的Entry的Set集合
- transient int size
HashMap表中存储的实例KV个数。
- transient int modCount
凡是我们做的增删改都会引发
modCount值的变化,跟版本控制功能类似,可以理解成version,在特定的操作下需要对version进行检查,适用于Fai-Fast机制。在java的集合类中存在一种
Fail-Fast的错误检测机制,当多个线程对同一集合的内容进行操作时,可能就会产生此类异常。比如当A通过iterator去遍历某集合的过程中,其他线程修改了此集合,此时会抛出
ConcurrentModificationException异常。此类机制就是通过
modCount实现的,在迭代器初始化时,会赋值expectedModCount,在迭代过程中判断modCount和expectedModCount是否一致。
- int threshold
扩容阈值 threshold = capacity * loadFactor
- final float loadFactor
可自定义的负载因子,不过一般都是用系统自带的0.75。
四种构造方法
- 默认构造方法
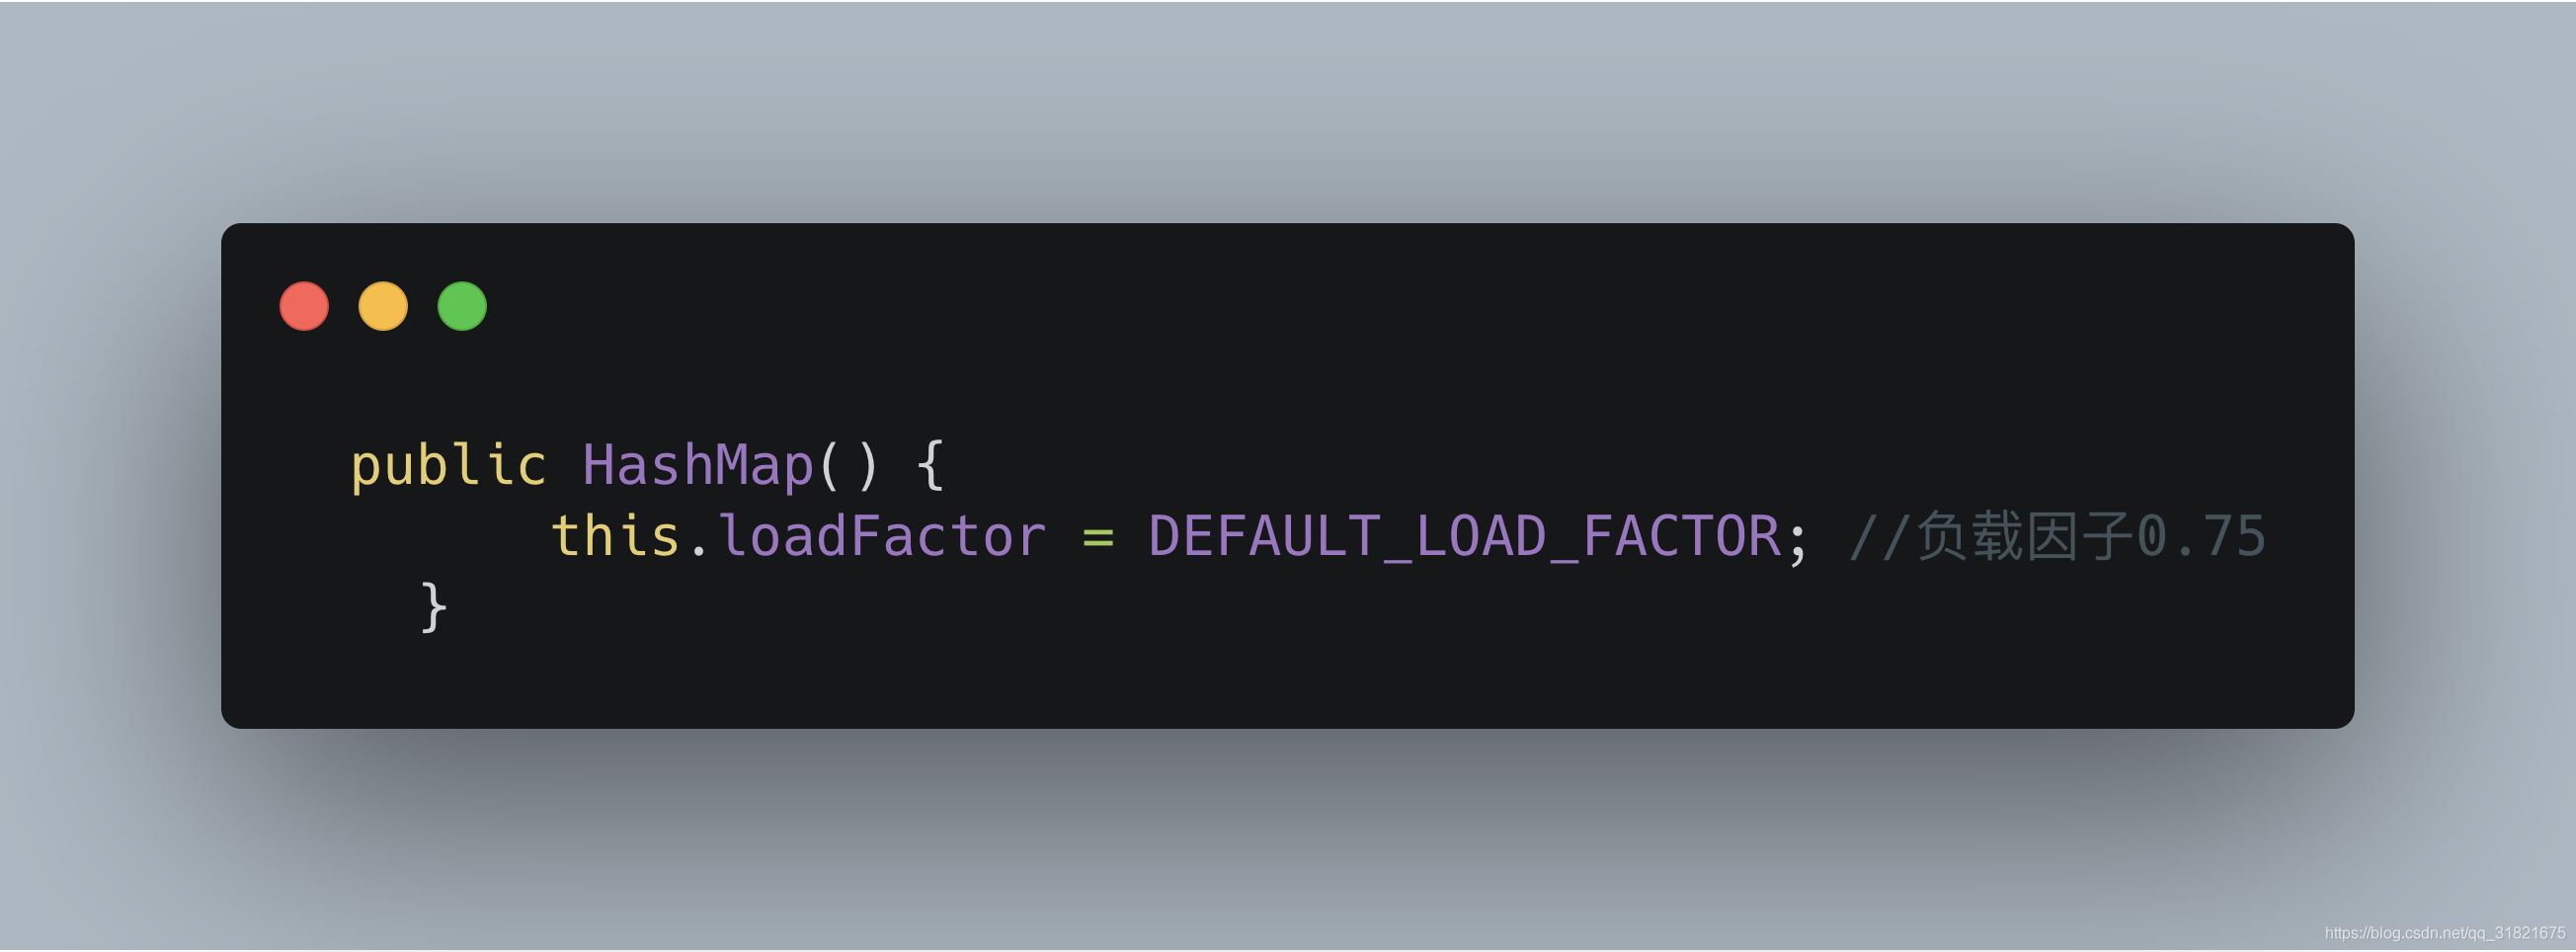
- 传入初始容量大小
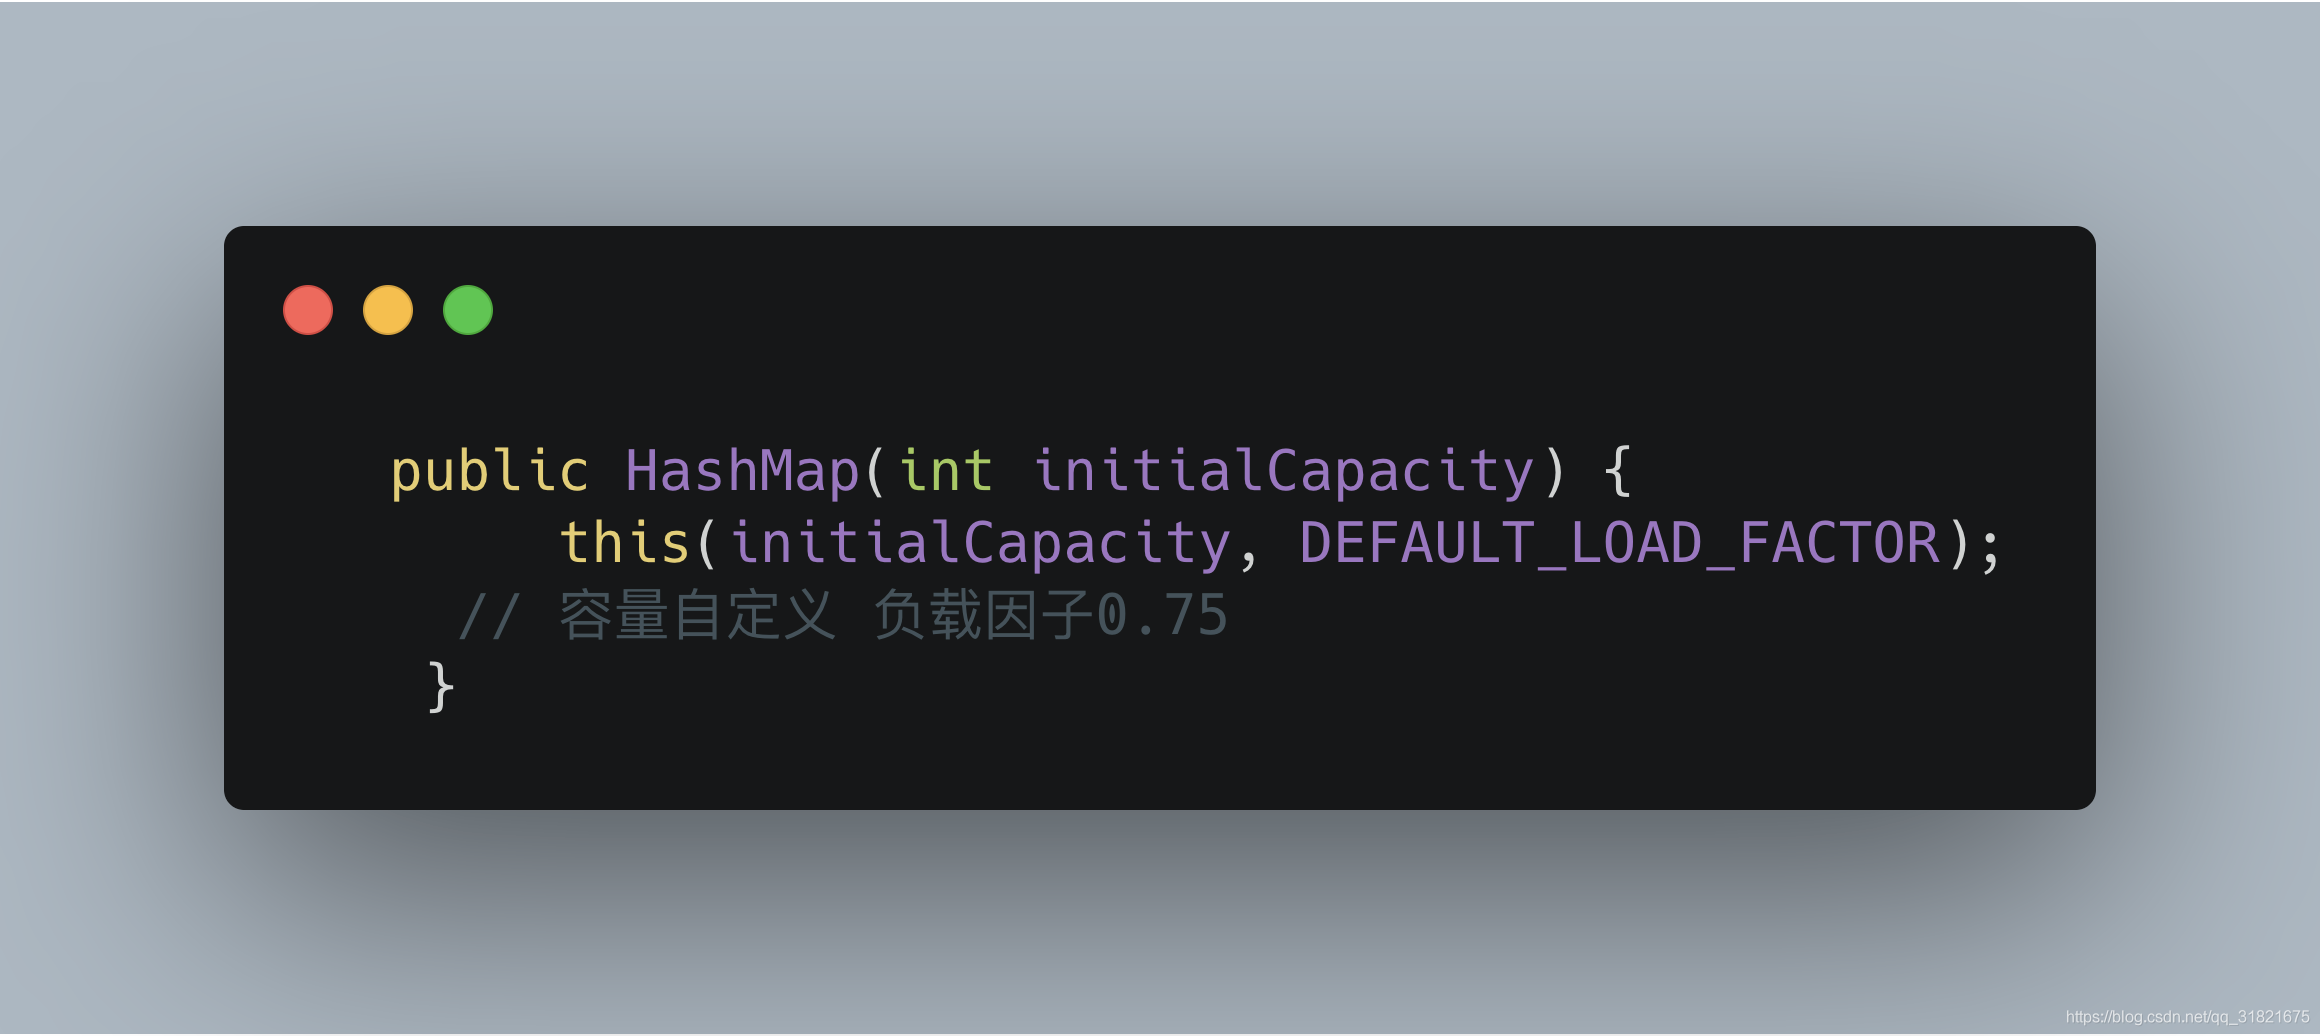
- 传入初始容量大小及负载因子
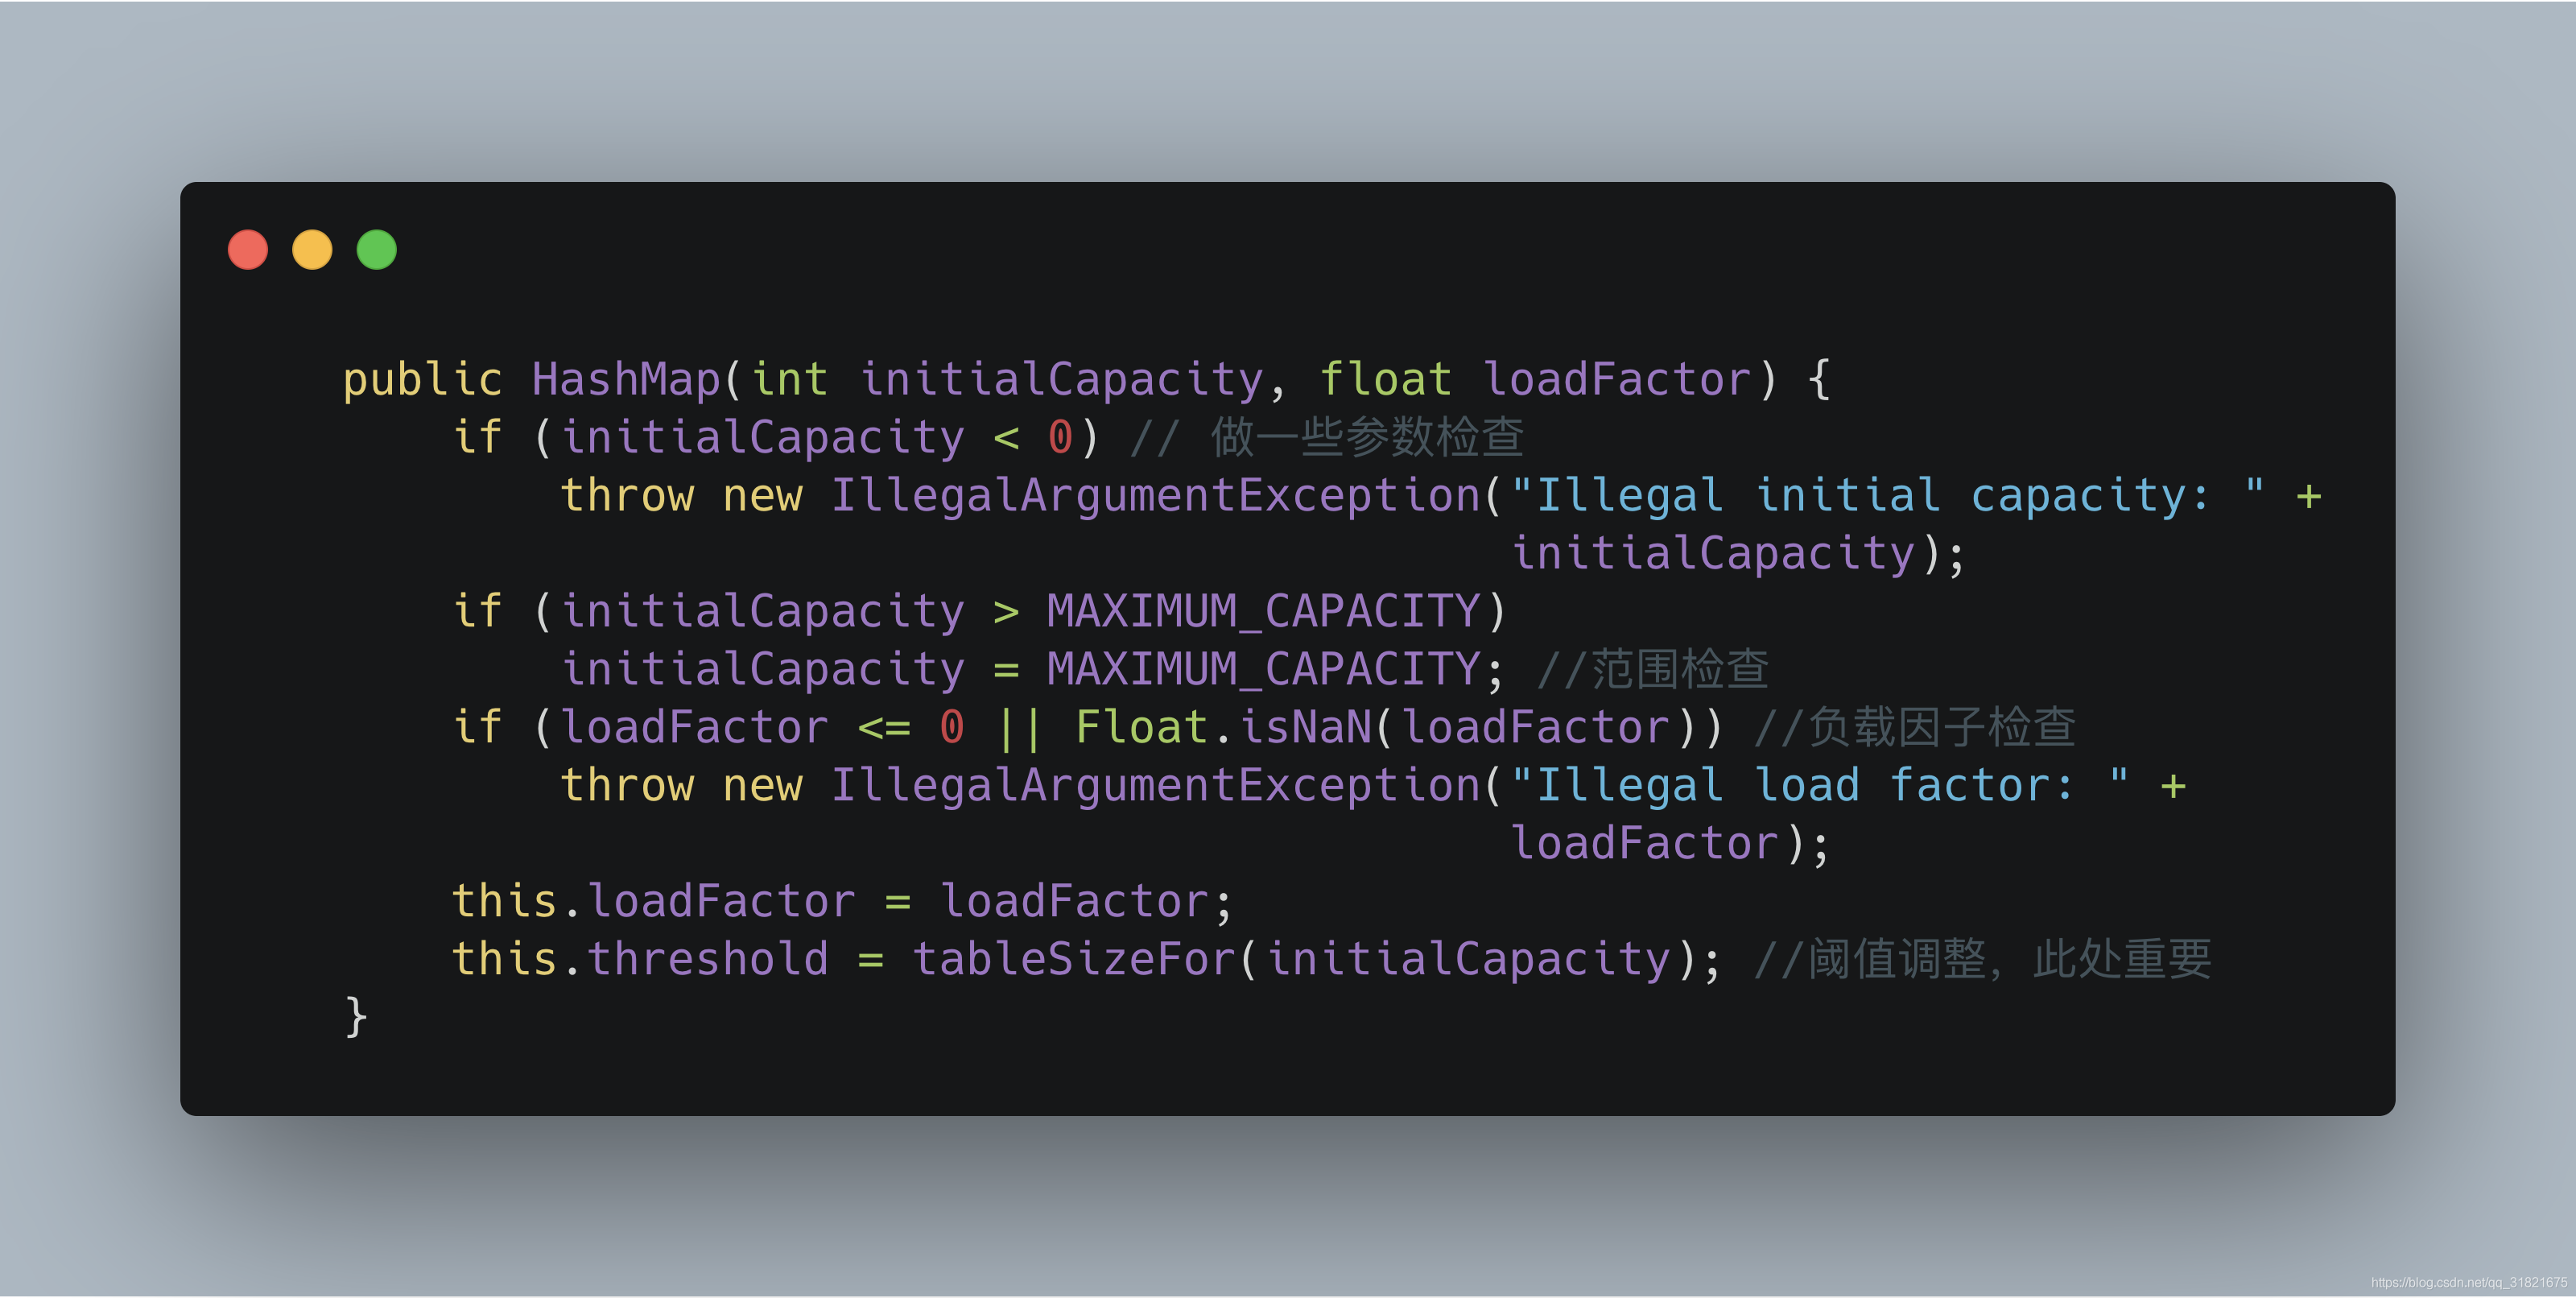
tableSizeFor:作用是返回大于输入参数且最小的2的整数次幂的数。比如10,则返回16。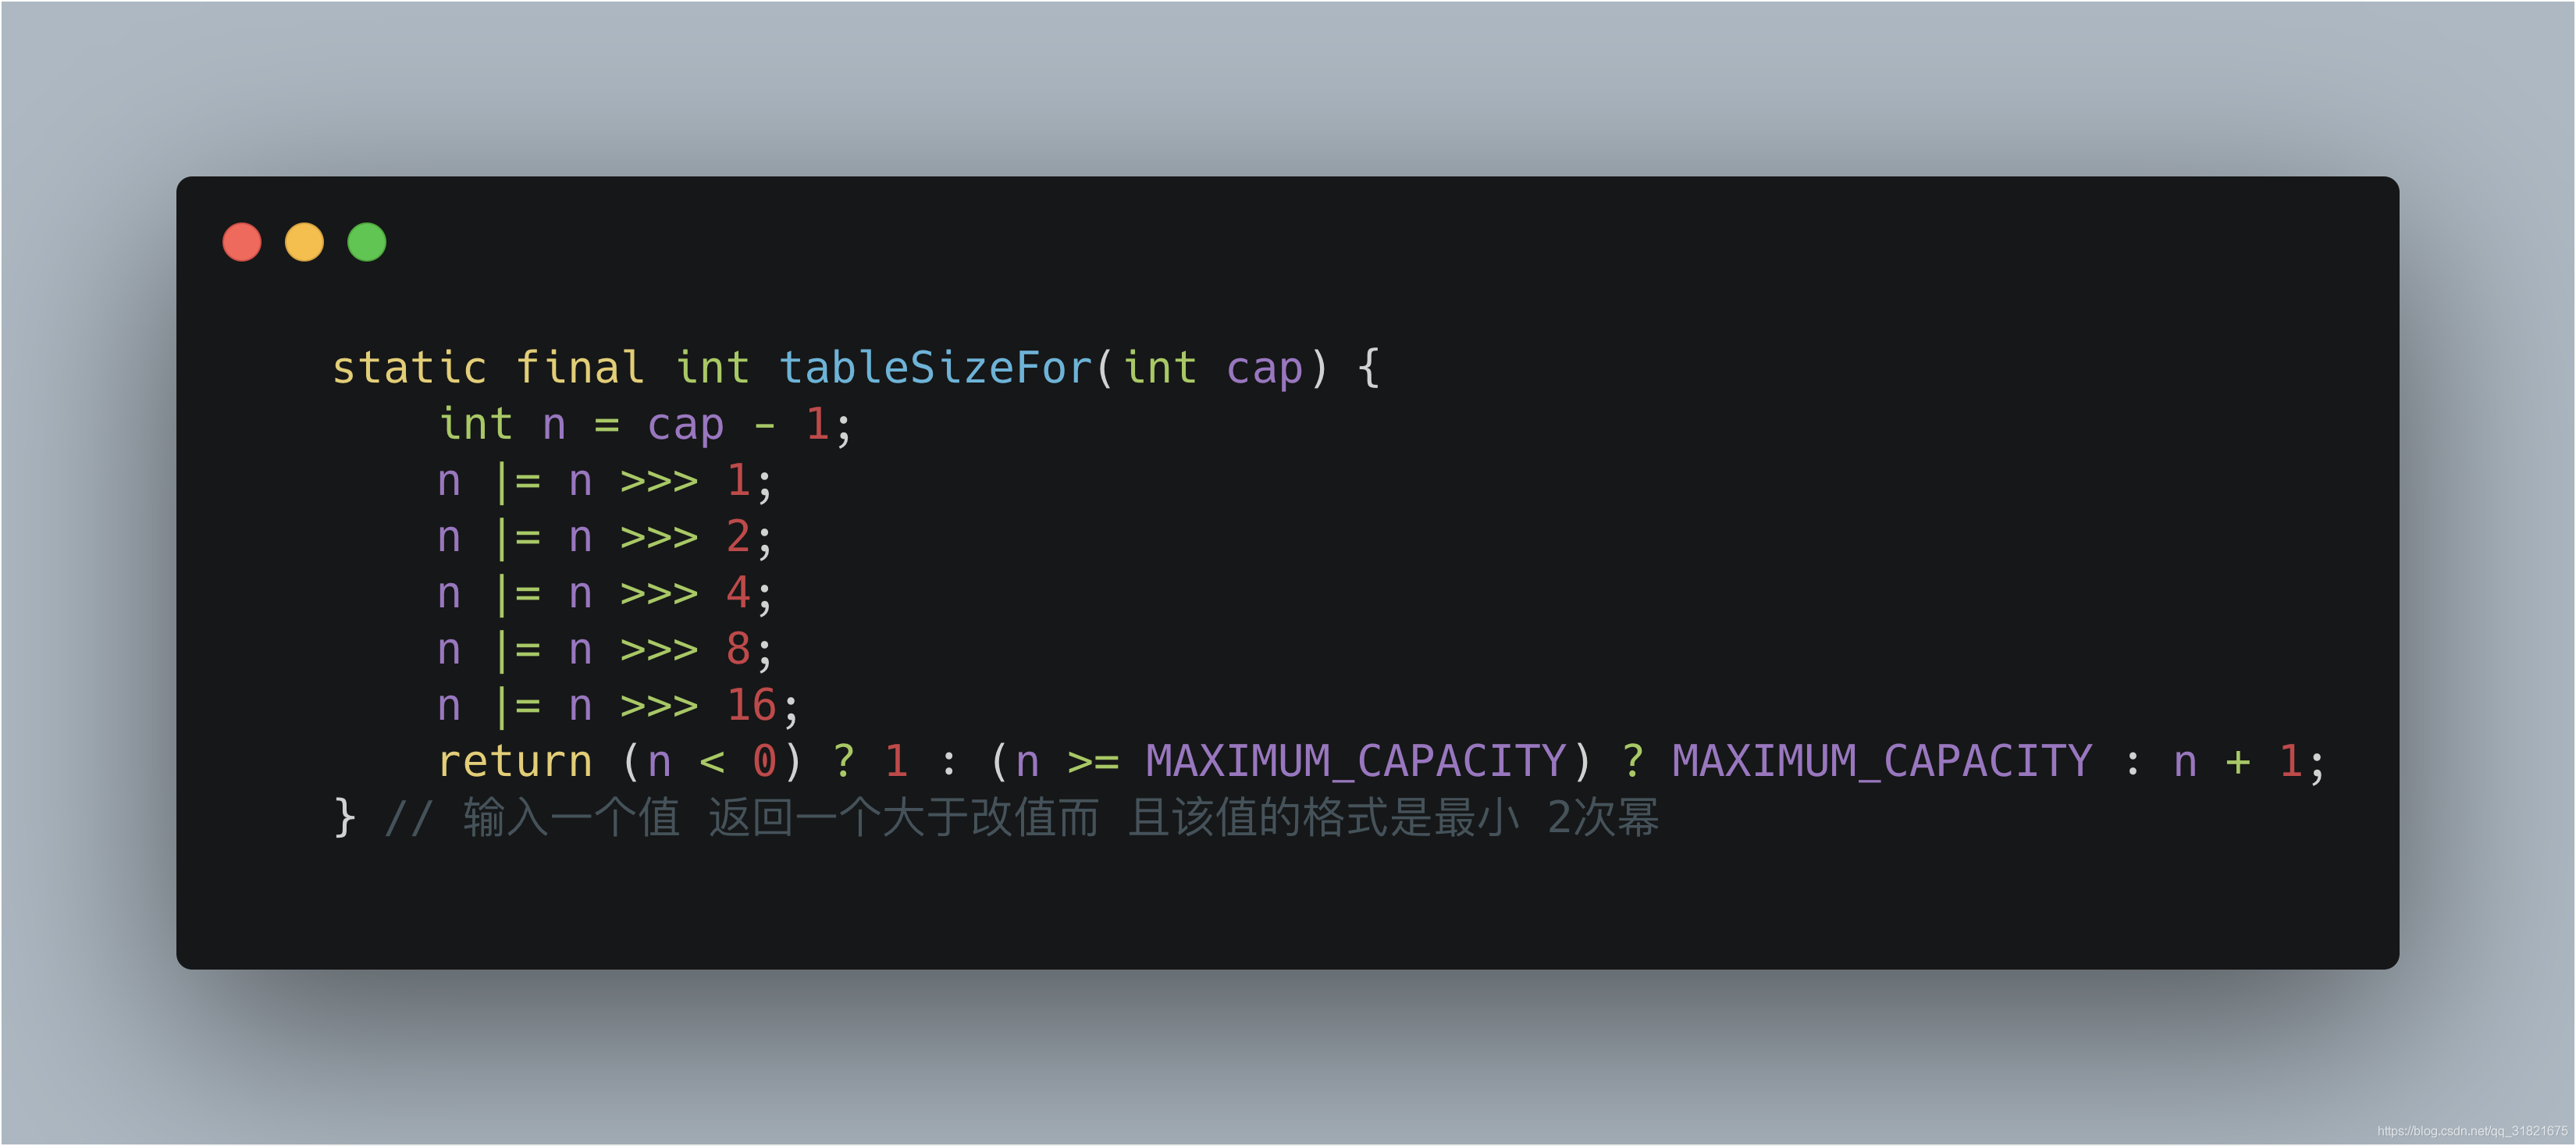
详解如下:
先来分析有关n位操作部分:先来假设n的二进制为01xxx…xxx。接着
对n右移1位:001xx…xxx,再位或:011xx…xxx
对n右移2为:00011…xxx,再位或:01111…xxx
此时前面已经有四个1了,再右移4位且位或可得8个1
同理,有8个1,右移8位肯定会让后八位也为1。
综上可得,该算法让最高位的1后面的位全变为1。最后再让结果n+1,即得到了2的整数次幂的值了。
现在回来看看第一条语句:
int n = cap - 1;
让cap-1再赋值给n的目的是另找到的目标值大于或等于原值。例如二进制1000,十进制数值为8。如果不对它减1而直接操作,将得到答案10000,即16。显然不是结果。减1后二进制为111,再进行操作则会得到原来的数值1000,这种二进制方法的效率非常高。
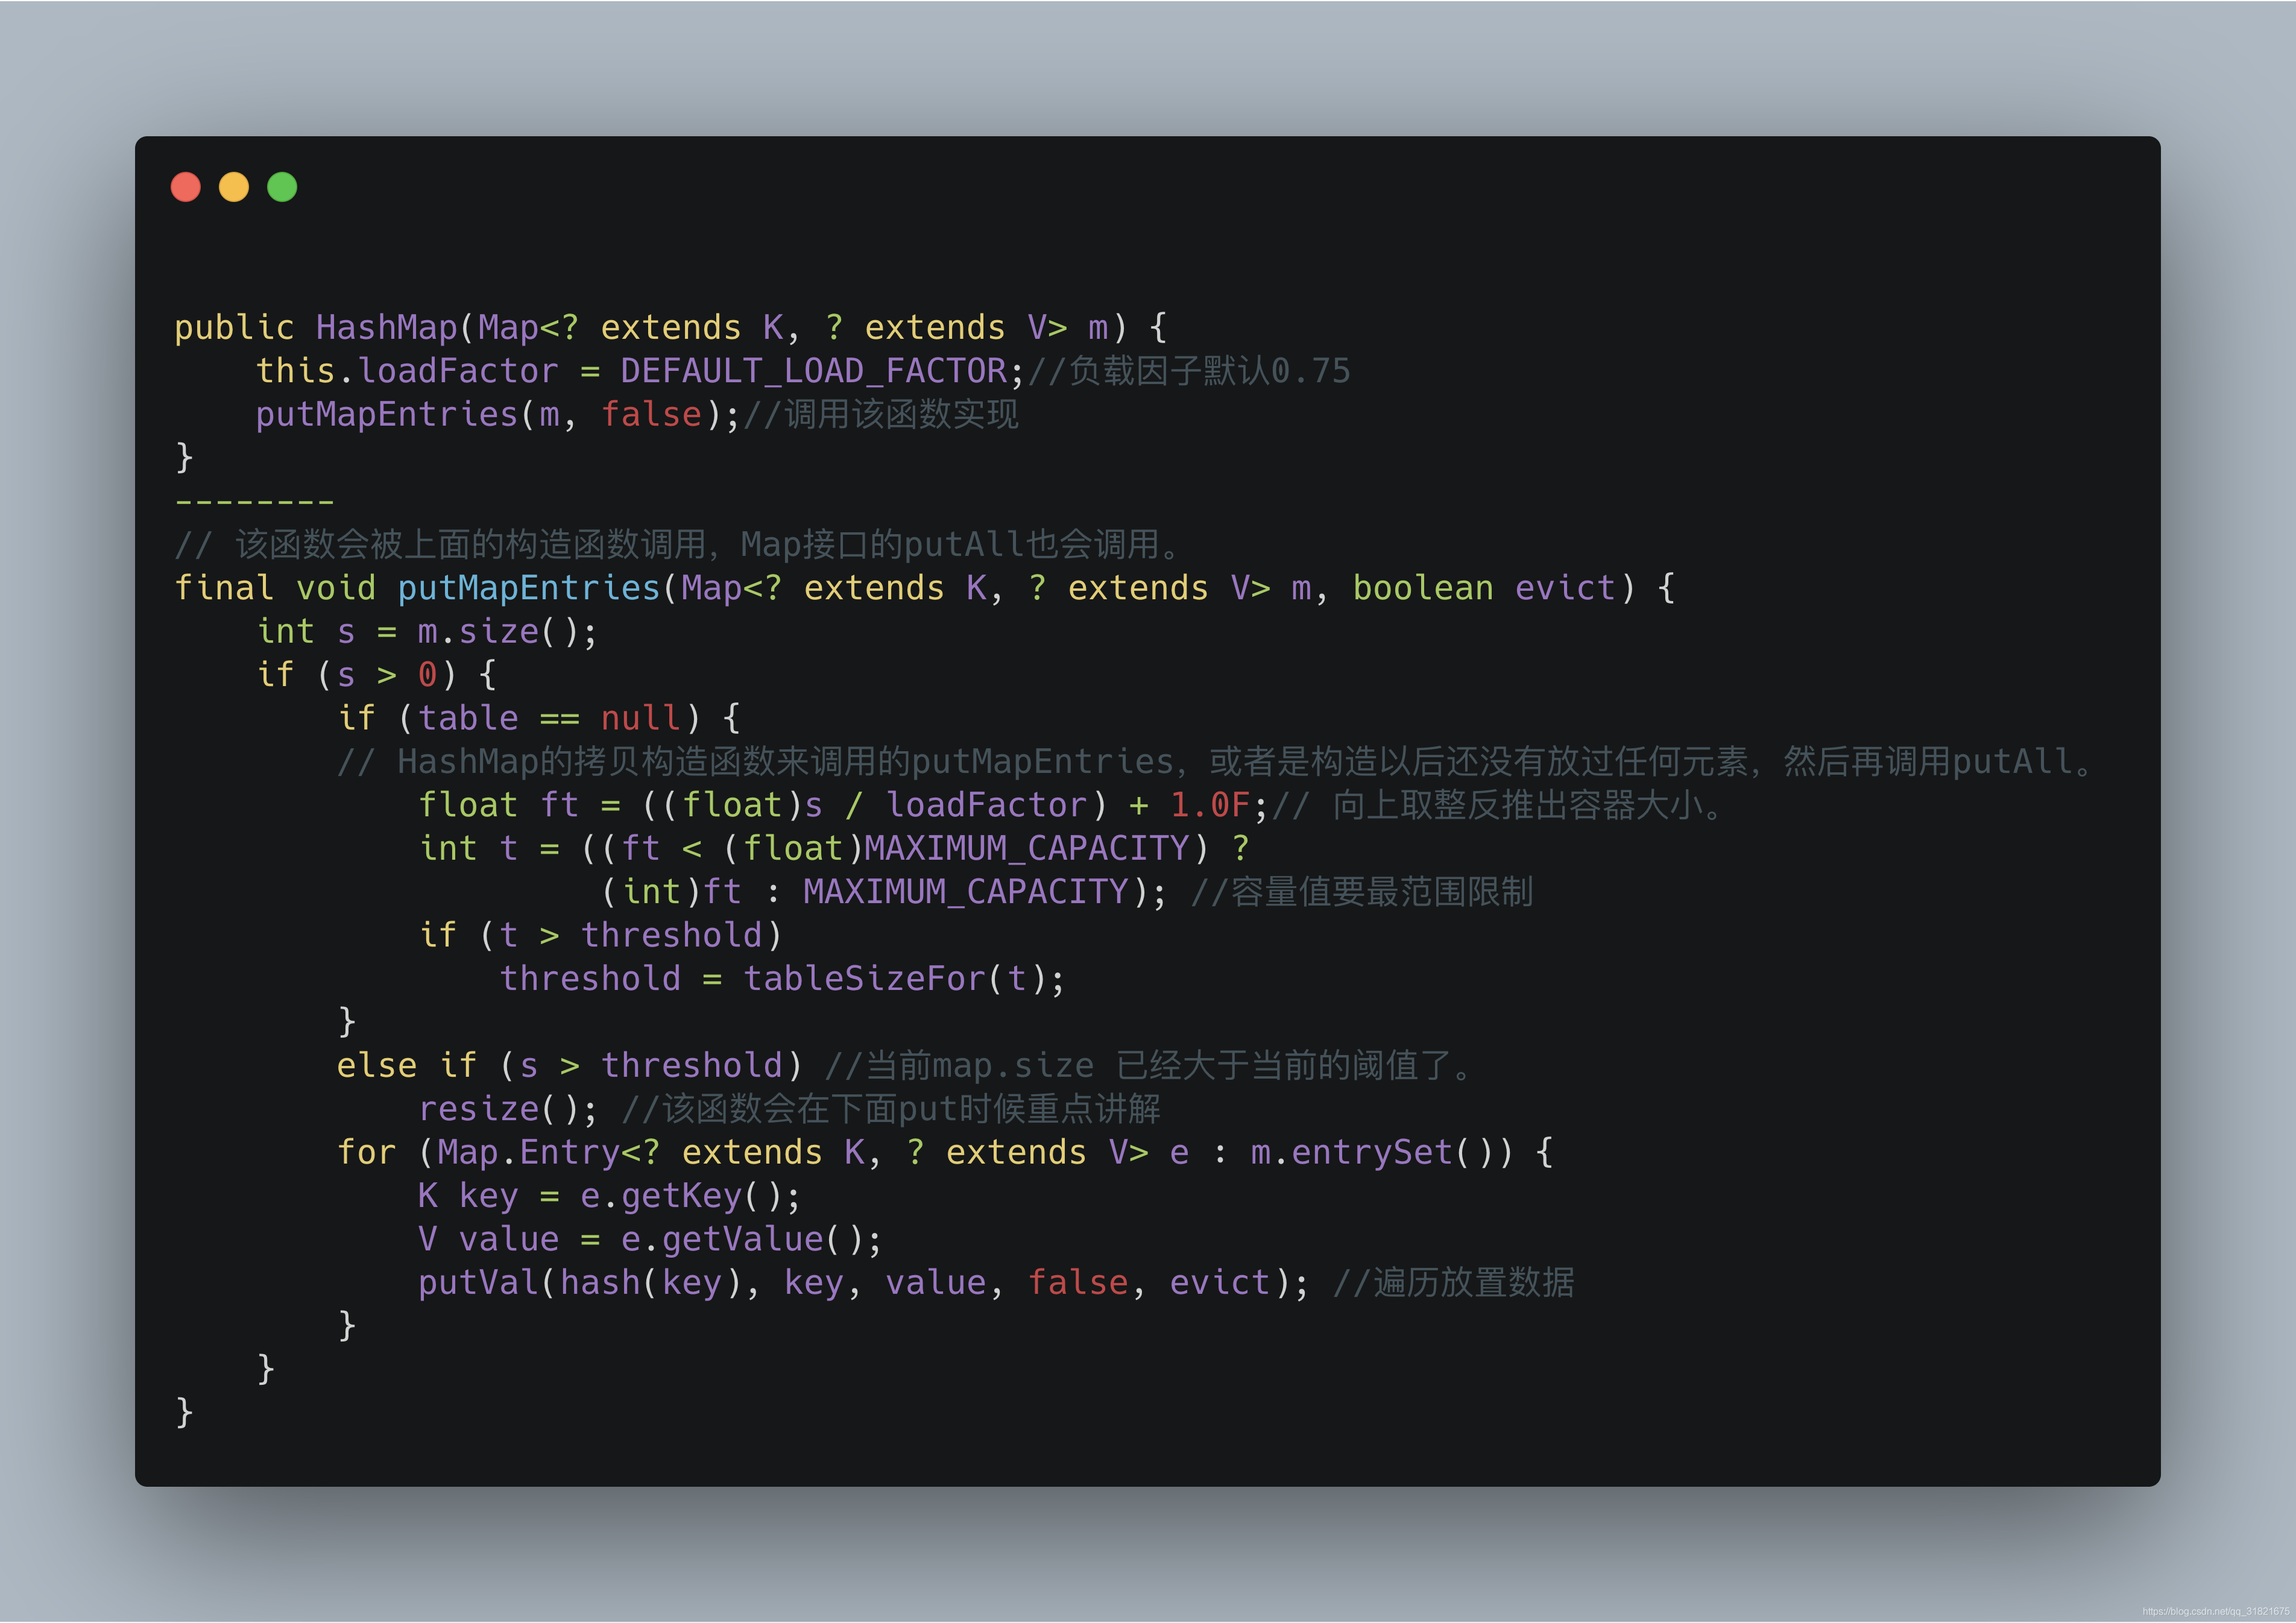
- 构造函数传入一个map
使用默认的负载因子,然后根据当前map的大小来反推需要的threshold,同时还可能会涉到resize,然后住个put到 容器中。
Hash值
无论我们put数据还是get数据都要先获得该数据在这个哈希表中对应的位置。比如put数据,它的流程分为2步。
1.先获得key对应的hash值。
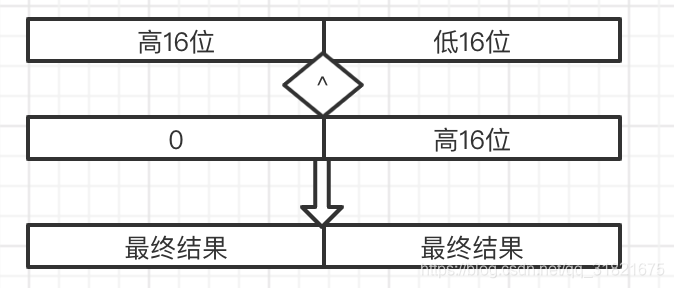
- 将该数据的hash值A,跟将A右无符号移动16位后再
^得到最终值。这个操作叫扰动,原因是怕低几位出现想同的概率太大,尽可能的将数据实现均匀分布。
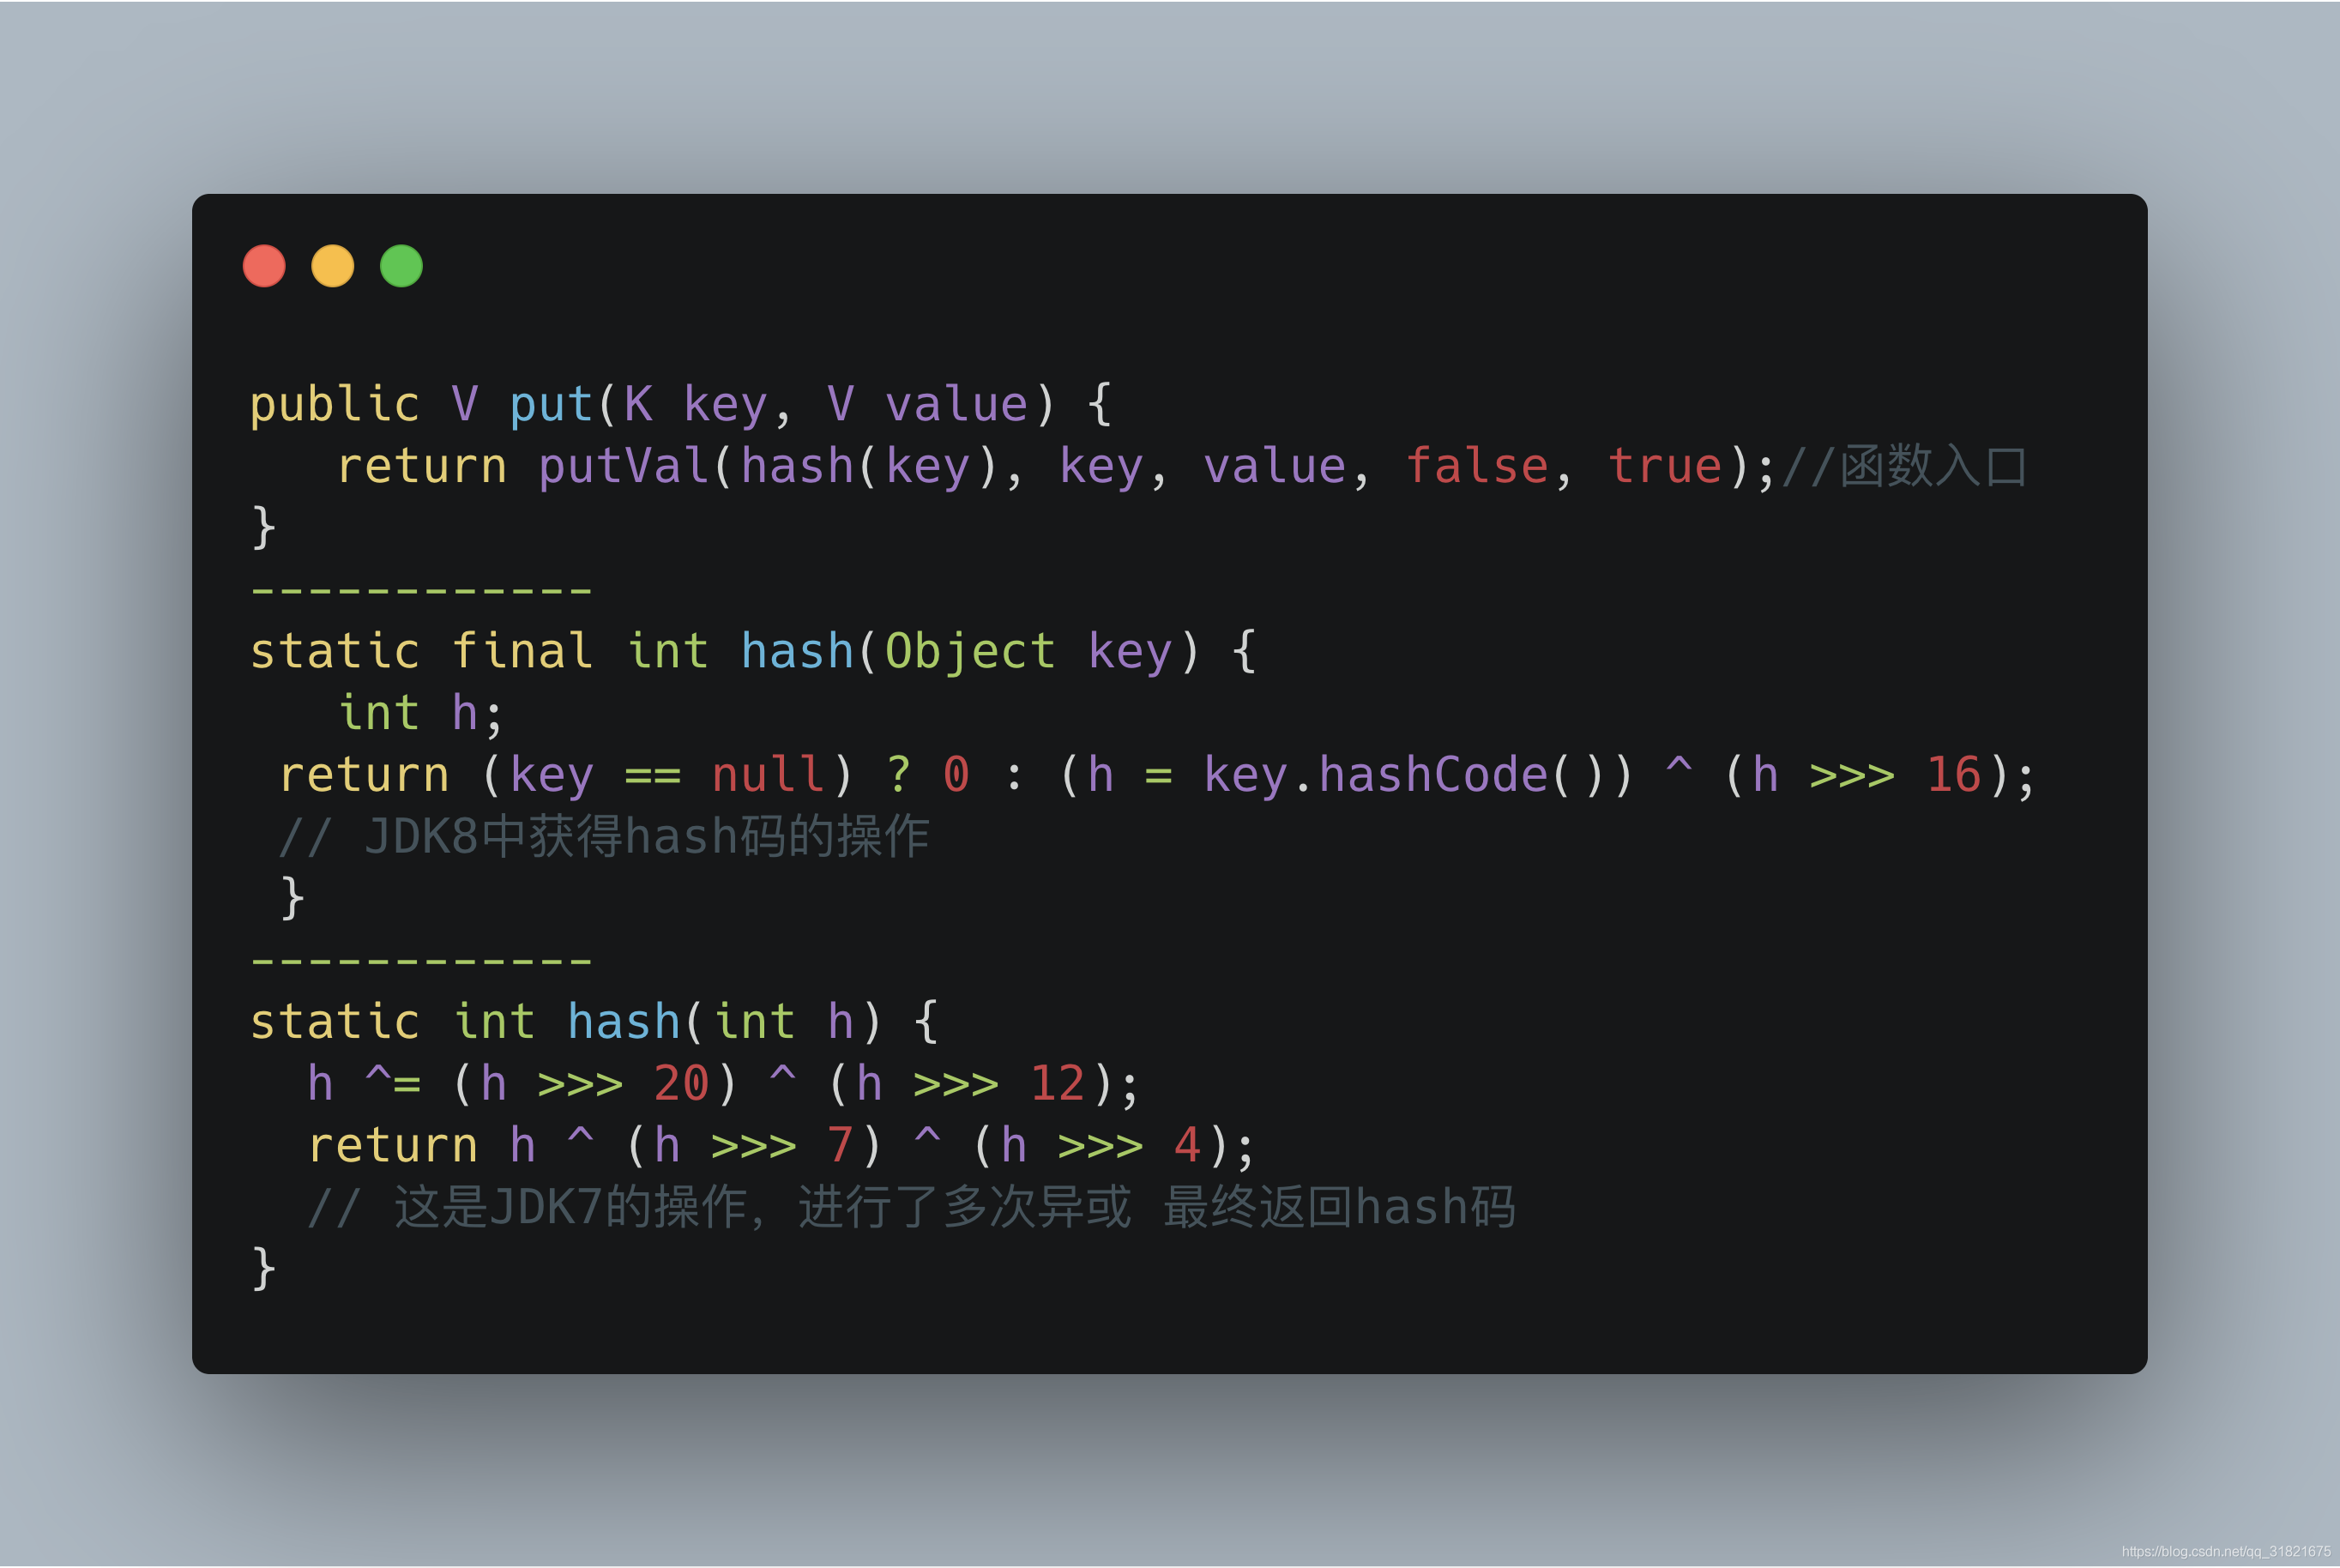
同时JDK8跟JDK7的扰动目的一样,不过复杂程度不一样。
get
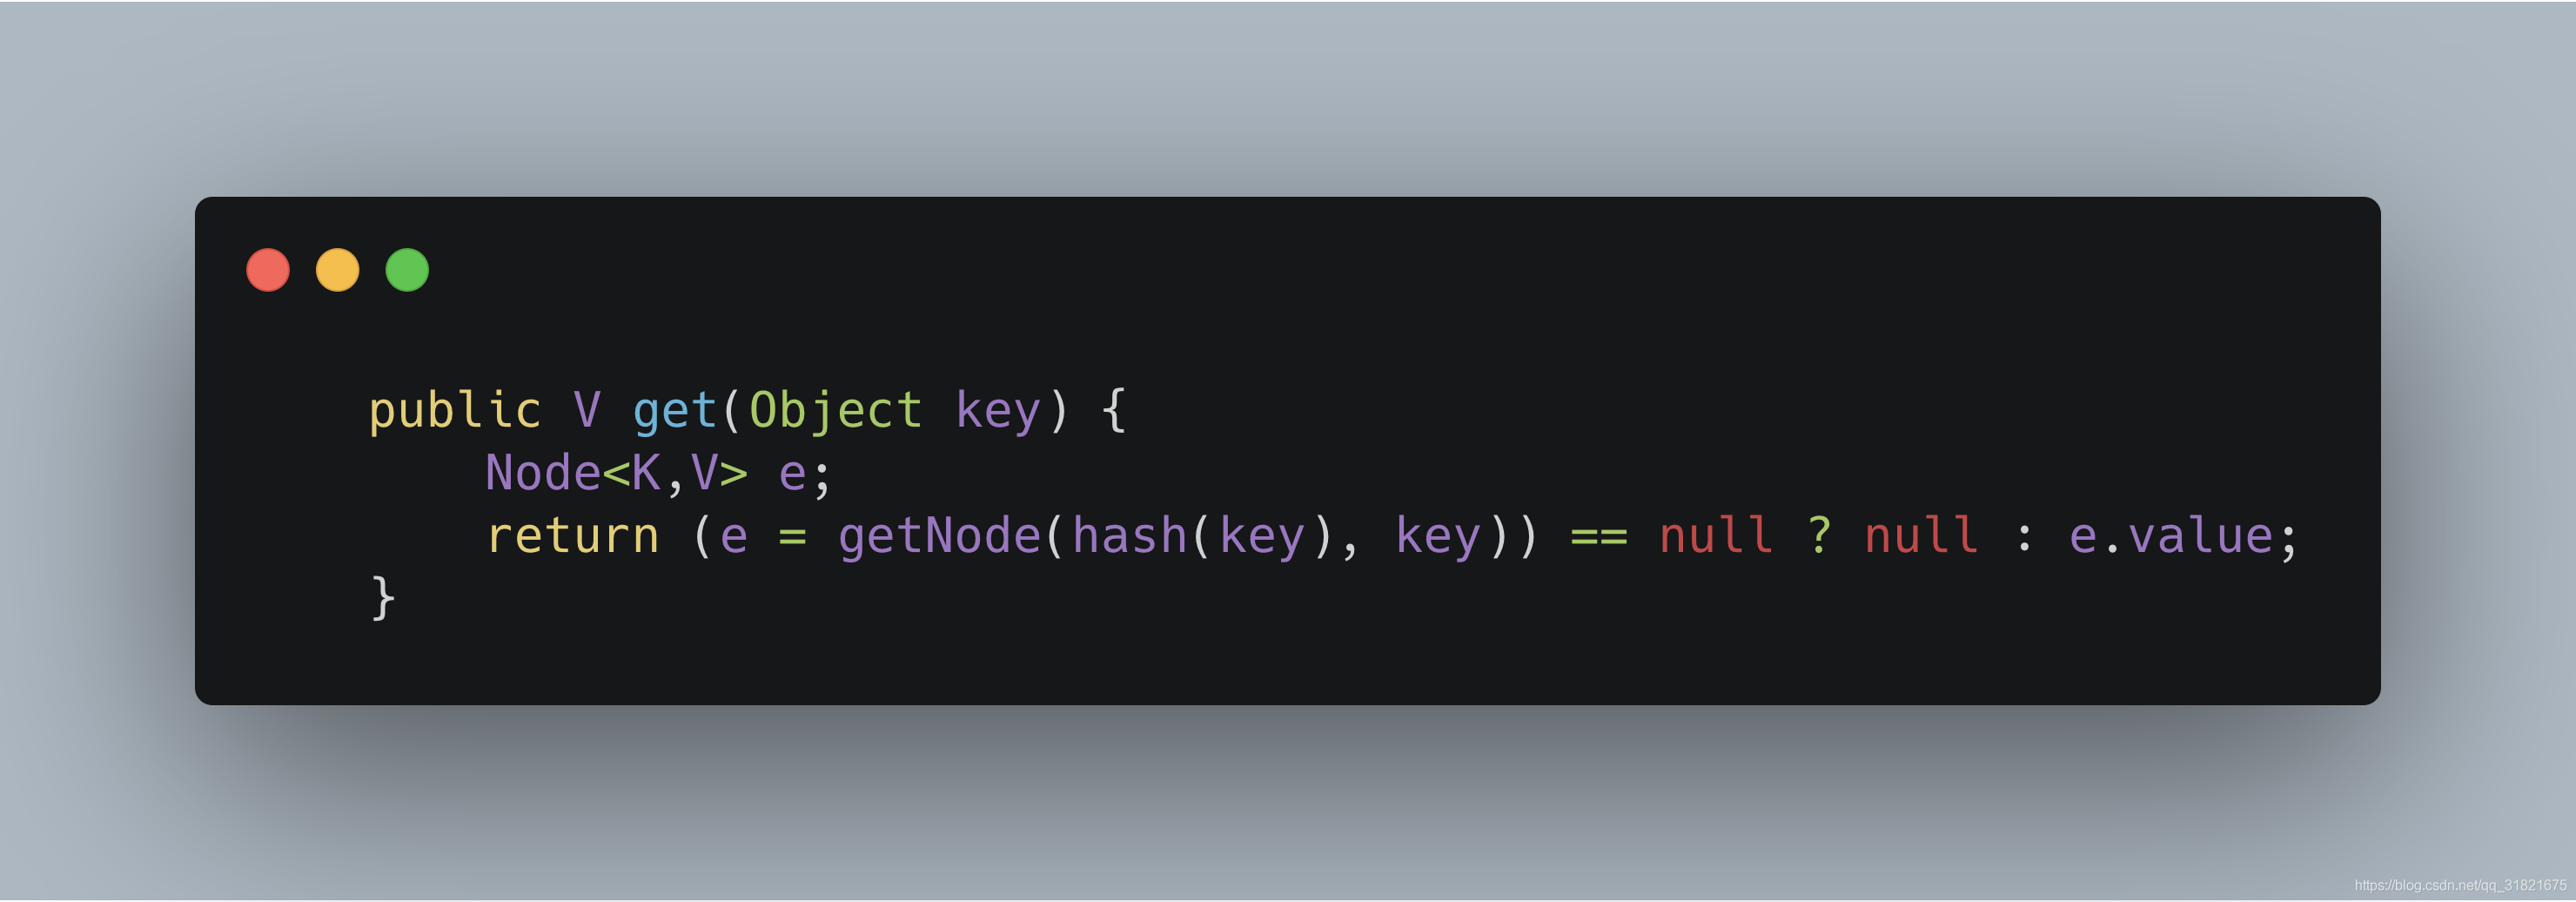
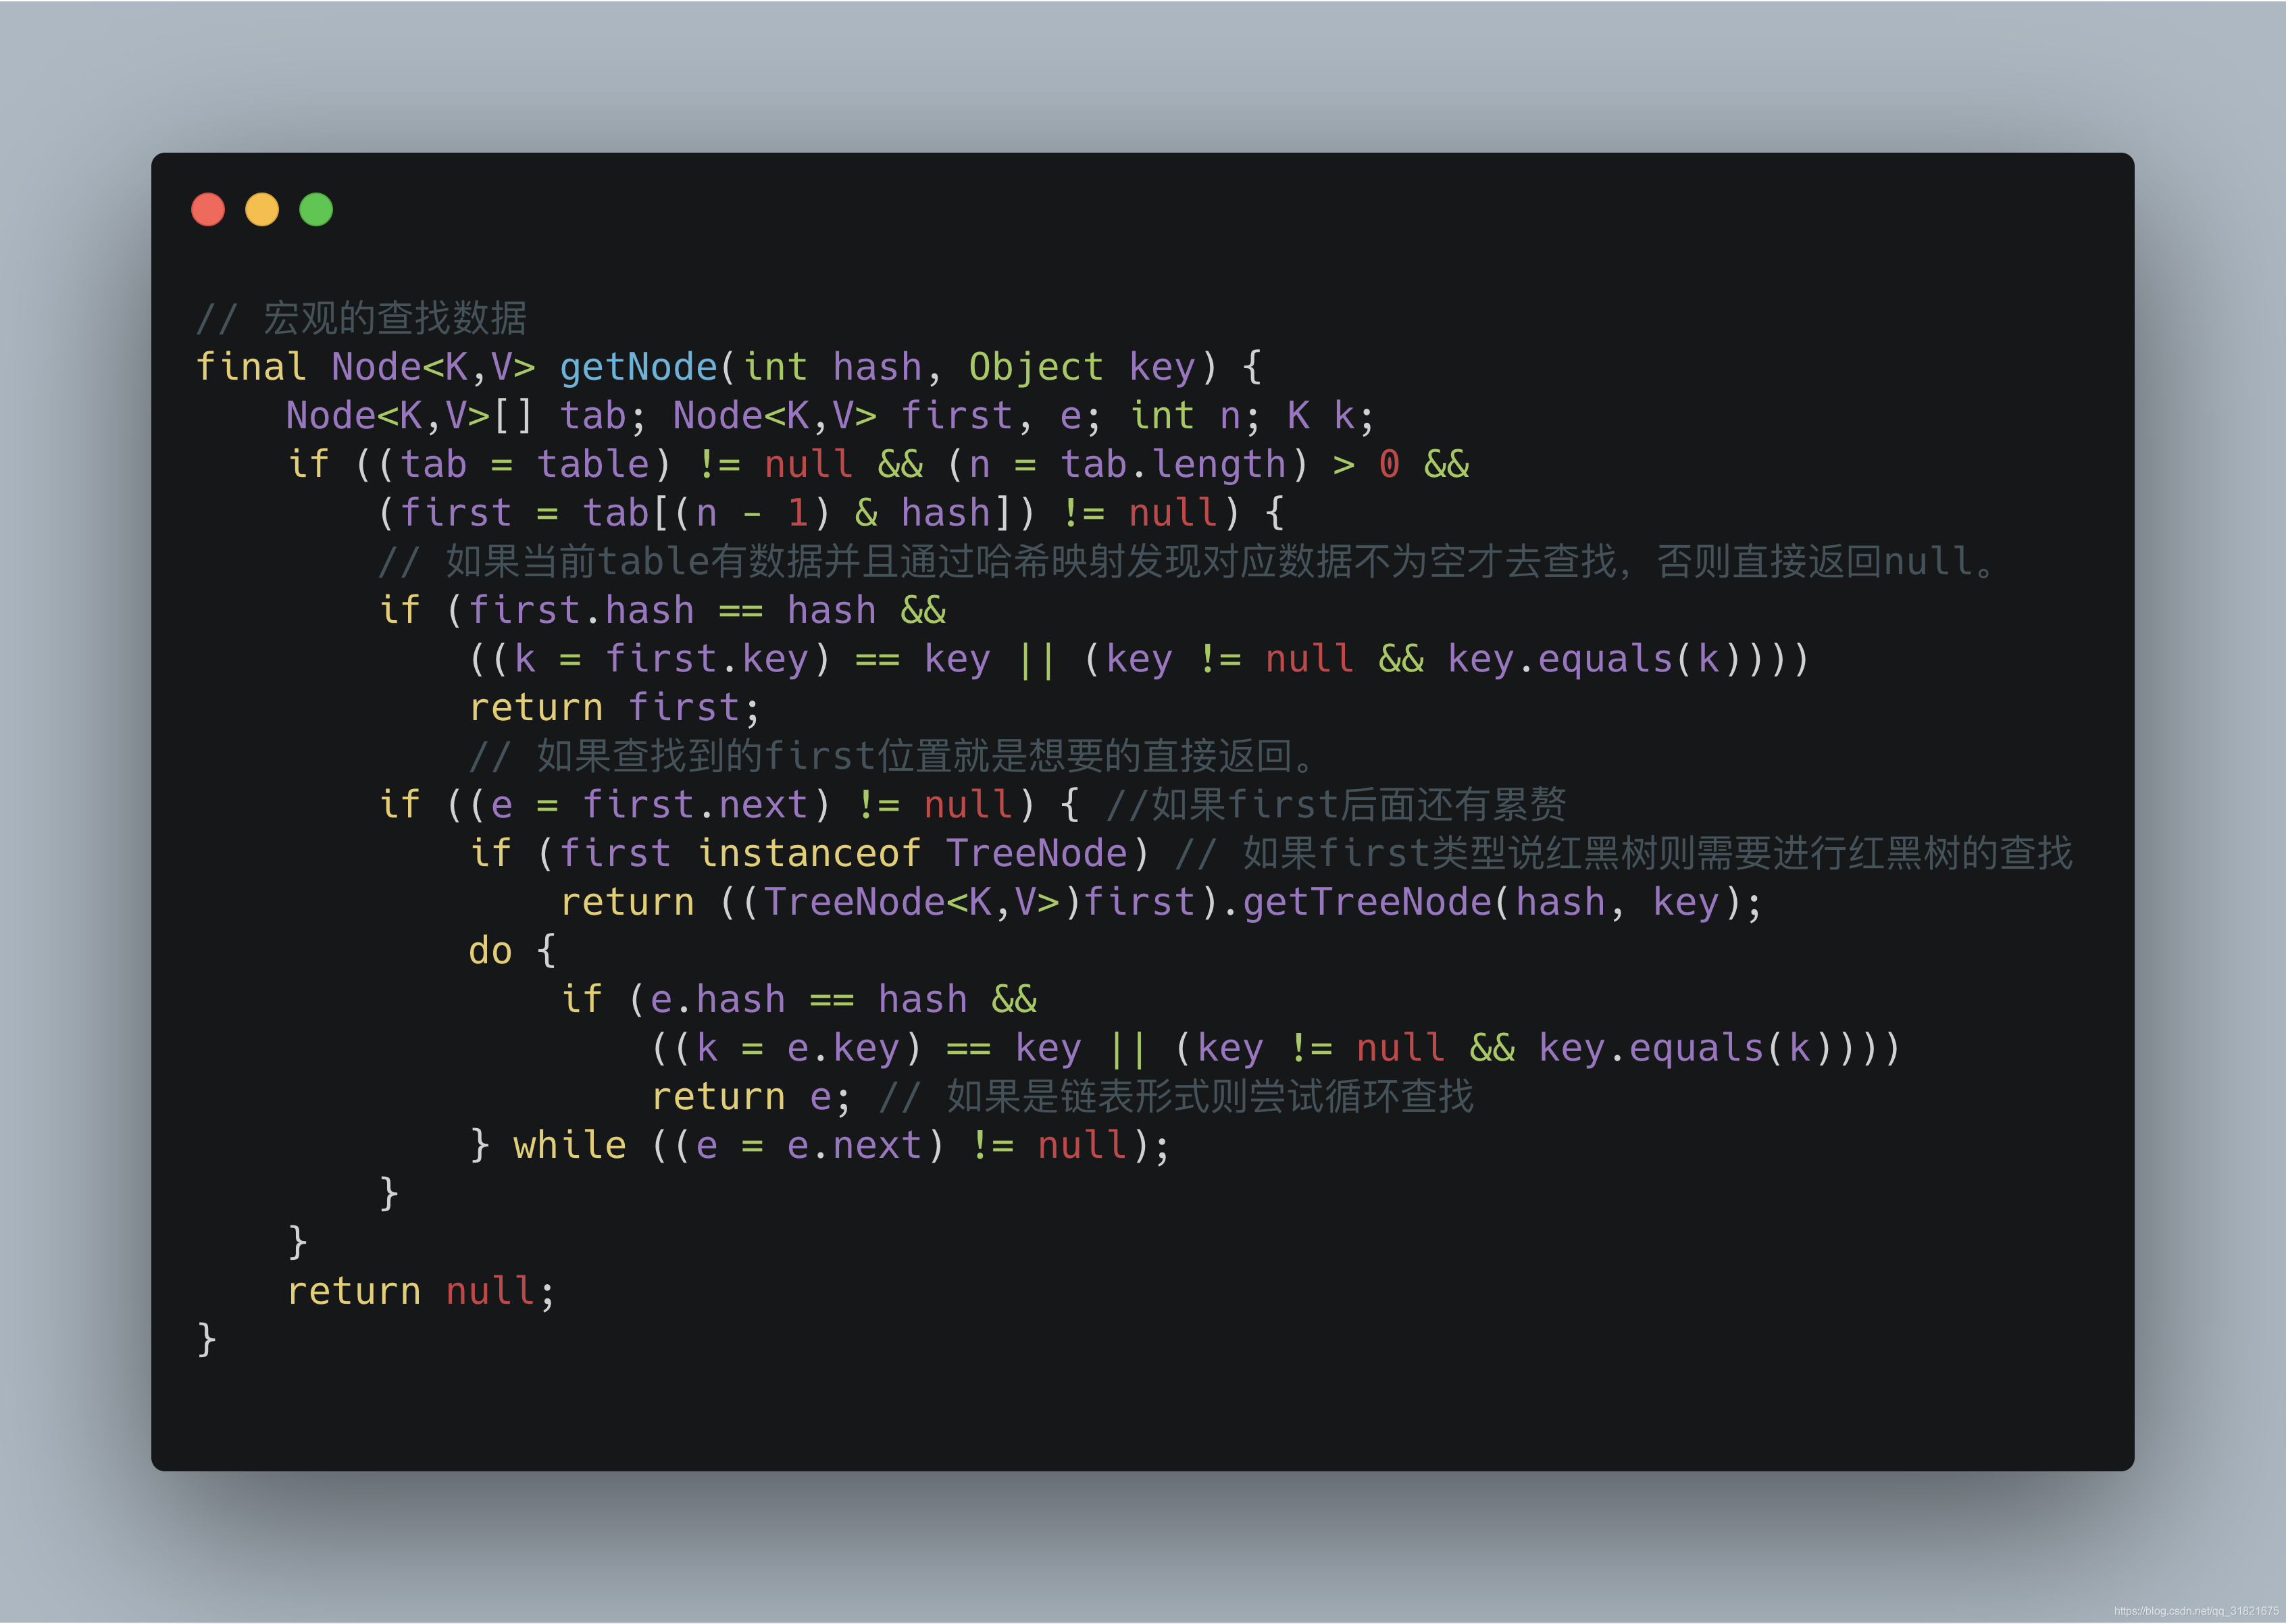
相对来说很简单,为方便理解先说下代码大致流程思路。
- 获得key的hash然后根据hash和key按照插入时候的思路去查找
get。- 如果数组位置为NULL则直接返回 NULL。
- 如果数组位置不为NULL则先直接看数组位置是否符合。
- 如果数组位置有类型说红黑树类型,则按照红黑树类型查找返回。
- 如果数组有next,则按照遍历链表的方式查找返回。
getNode
宏观查找函数细节:
getTreeNode
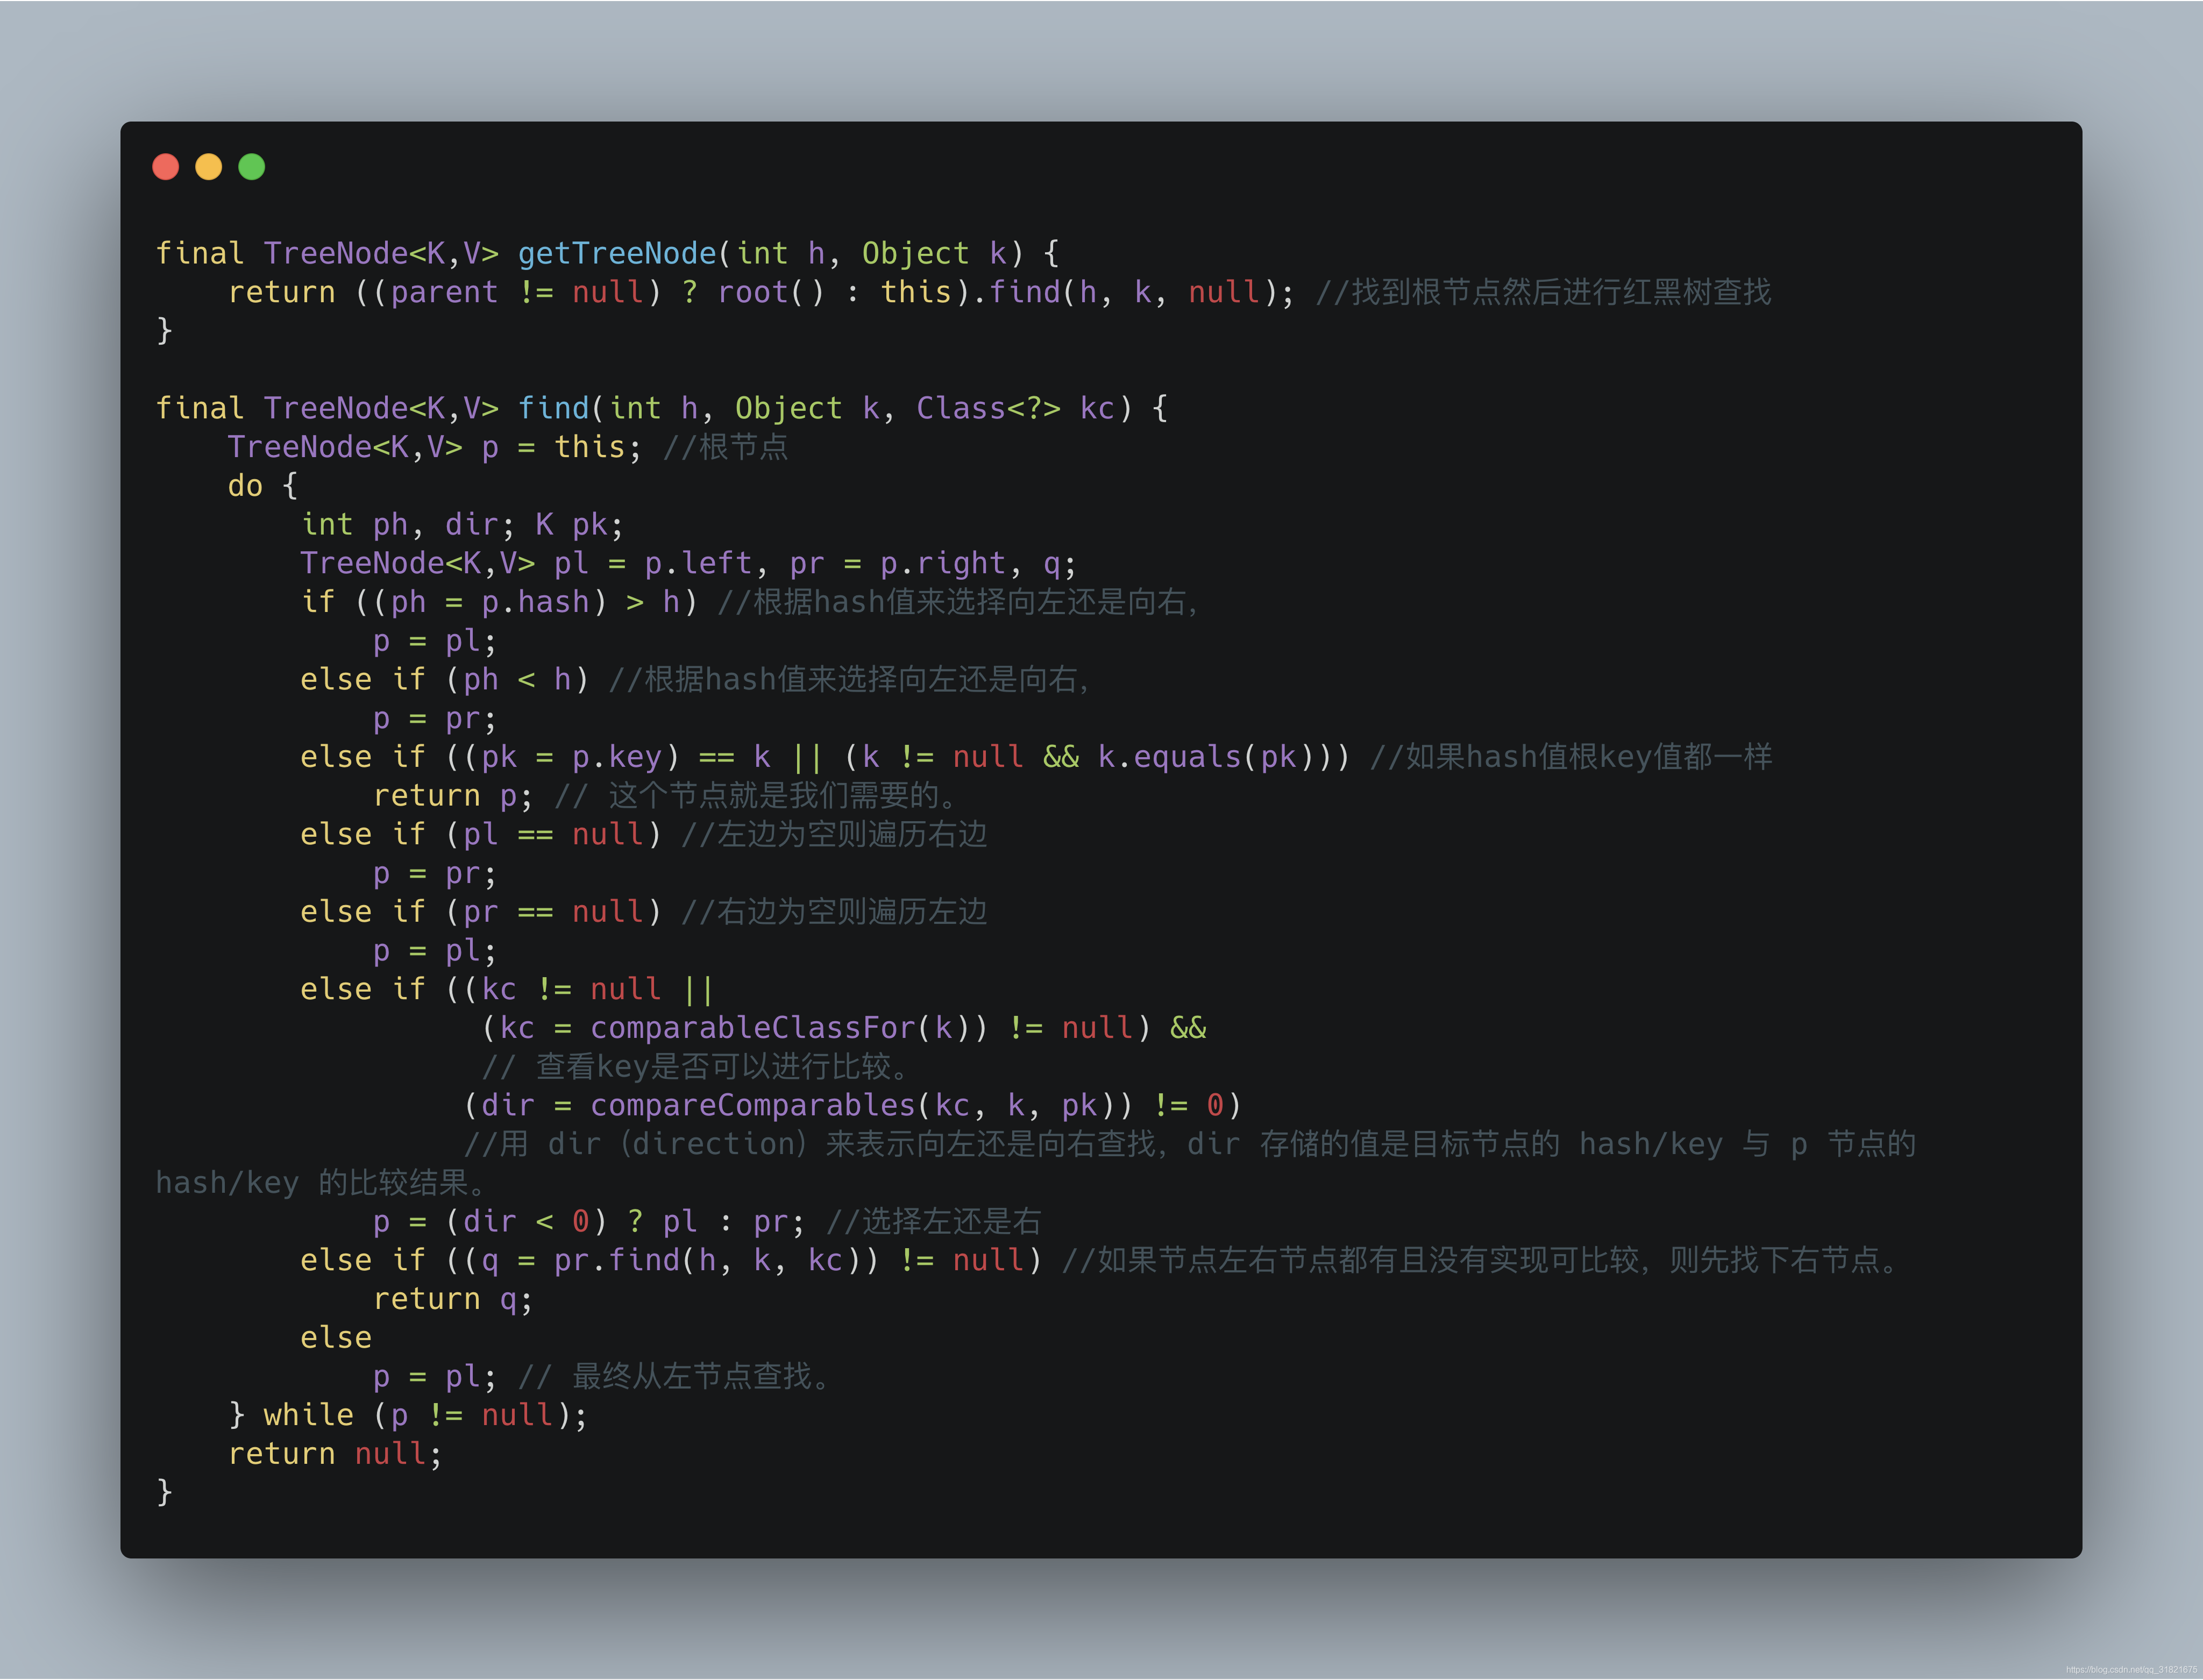
红黑树查找节点细节:
- 先获得根节点,左节点,右节点。
- 根据 左节点 < 根节点 < 右节点 对对数据进行逐步范围的缩小查找。
- 如果实现了Comparable方法则直接对比。
- 否则如果根节点不符合则递归性的调用find查找函数。
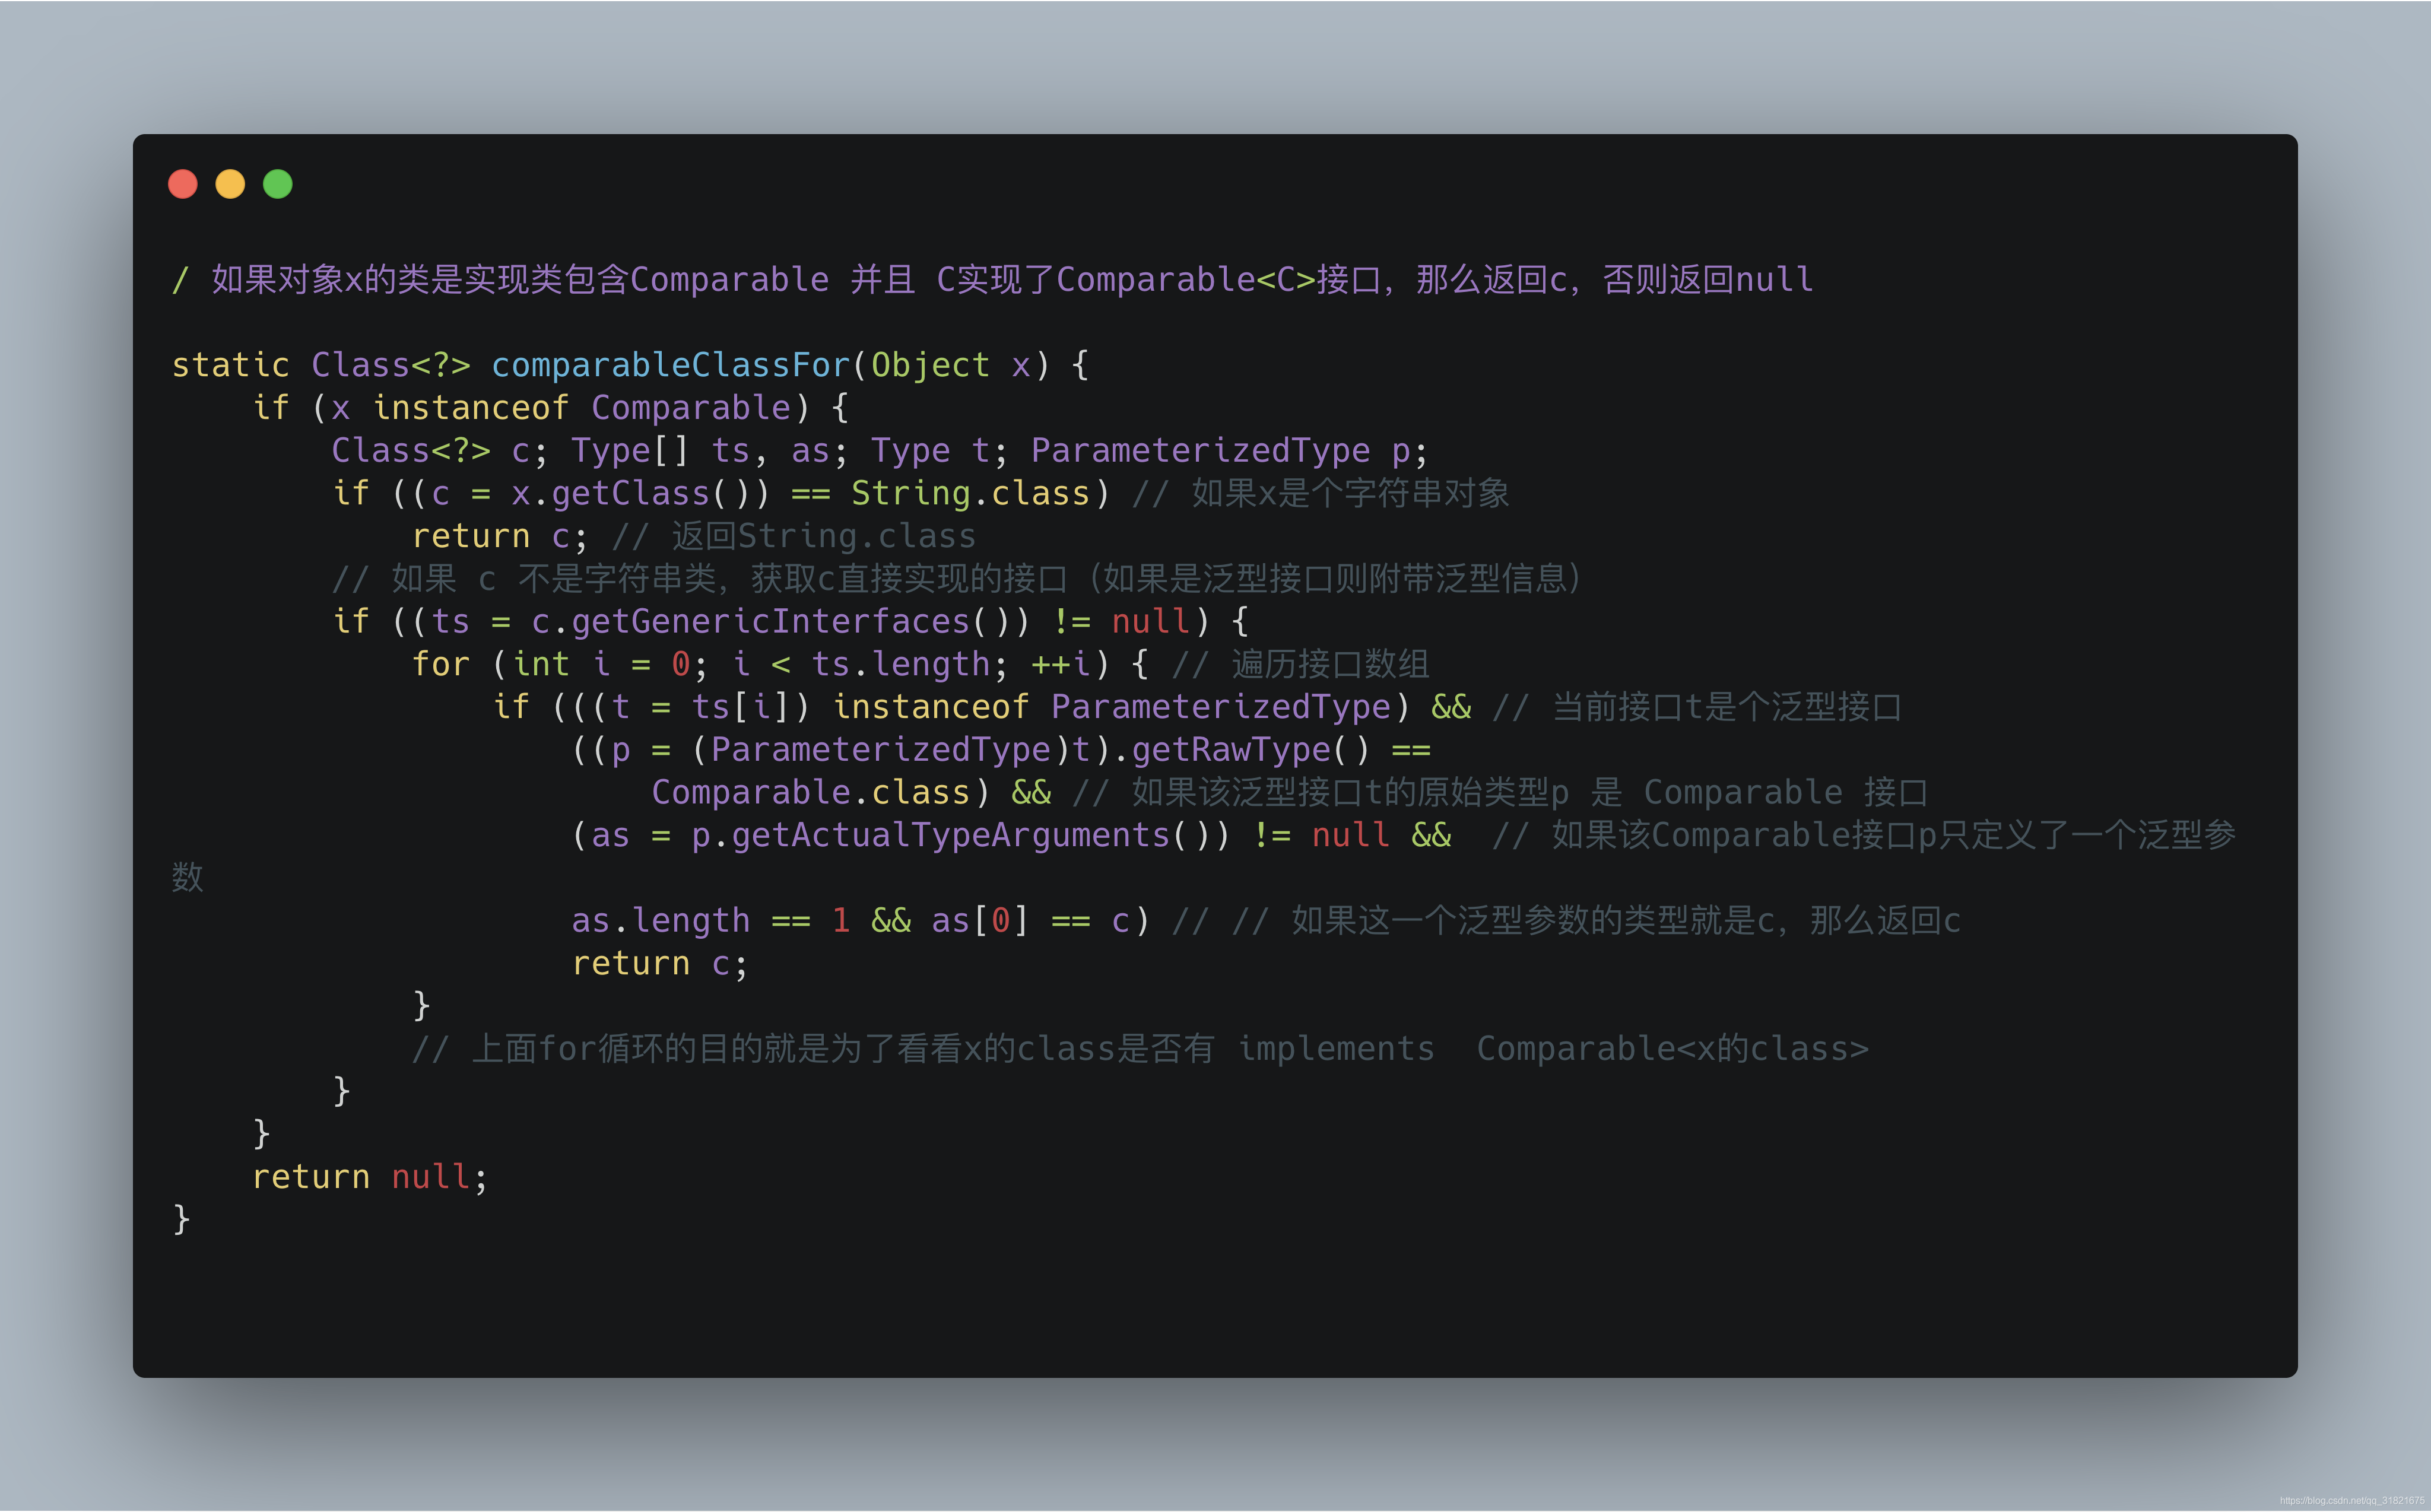
ComparableClassFor:
查询该key是否实现了Comparable接口。
compareComparables:
既然实现了Comparable接口就用该实现进行对比判断如何何去何从。
put
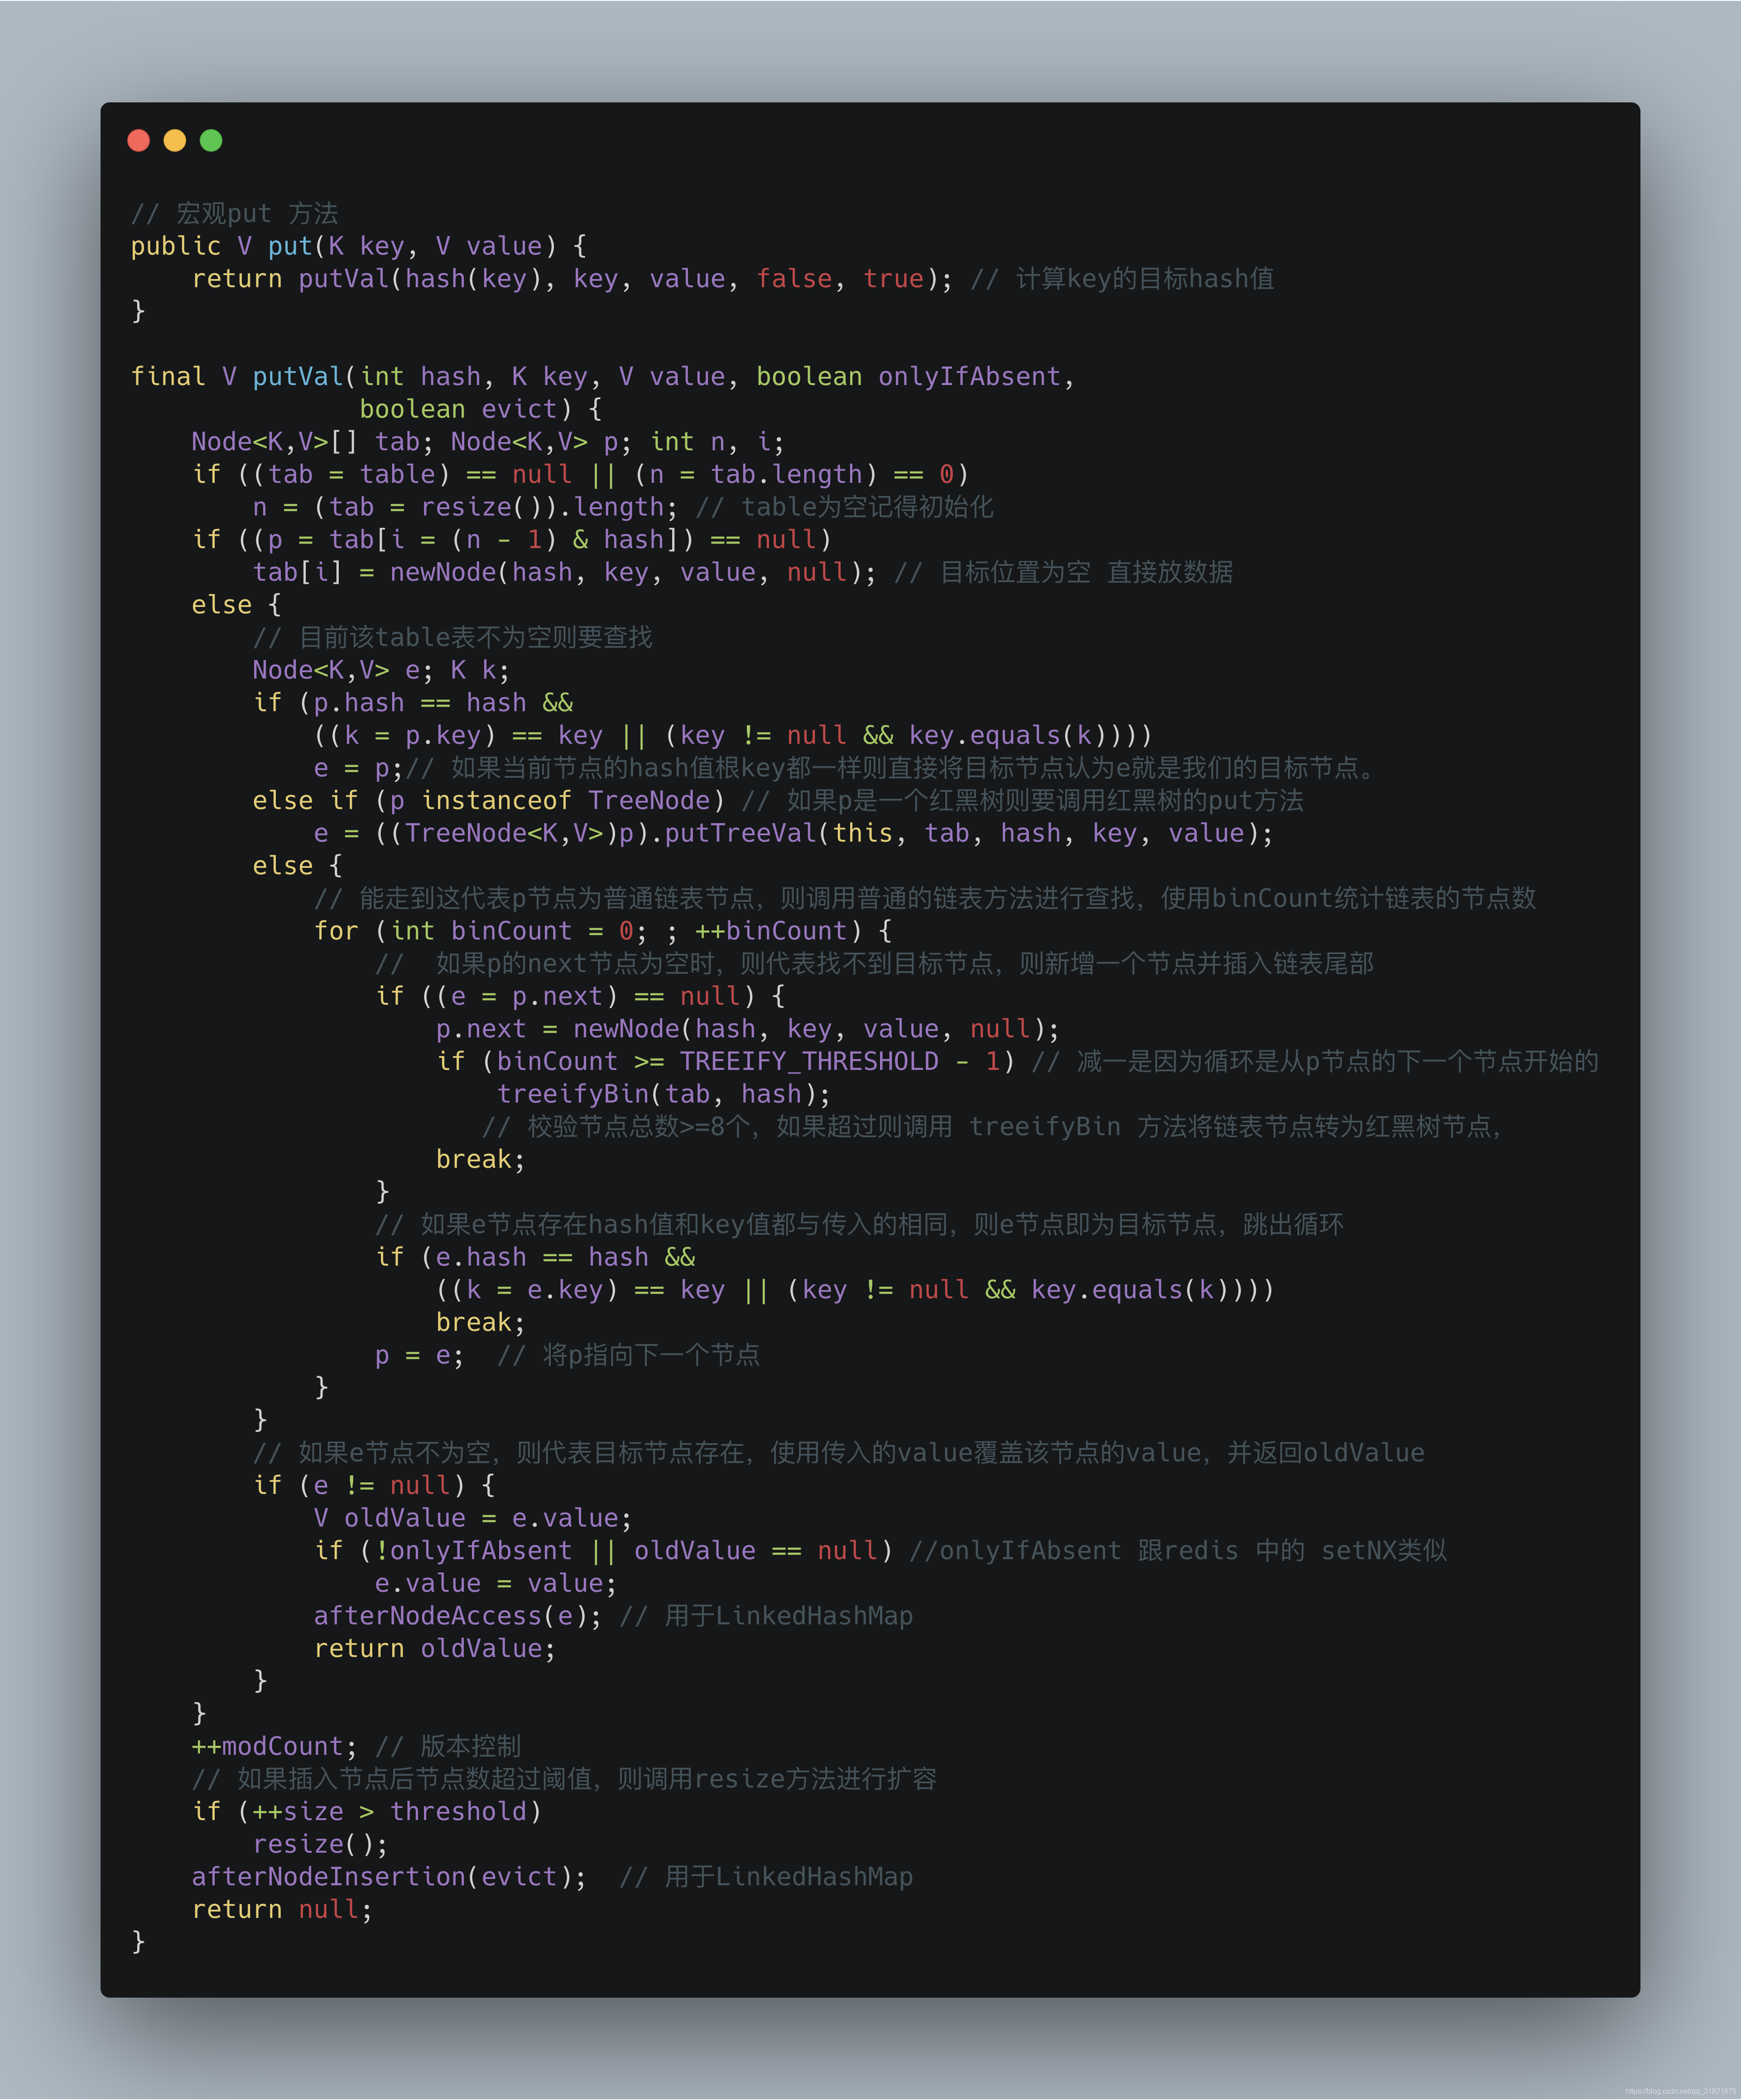
跟随源码梳理下put操作的大致流程。
数据插入的时候大致流程如下:
- 对数据进行
Hash值计算。 - 将数据插入前先查看下当前
table的状态,如果table是空需要调用resize来进行初始化。 - 通过位运算获得
key的目标位置。并判断当前位置情况。 - 如果当前位置为空则直接进行放置,如果跟当前key一直则进行覆盖。
- 如果当前有数据则看当前数据类型是否是红黑树,是的话需要调用
putTreeVal。 - 否则就认为是个链表,然后循环的查找进行尾部插入。同时还要考虑当前链表转红黑树。
在JDK8中寻找待插入点
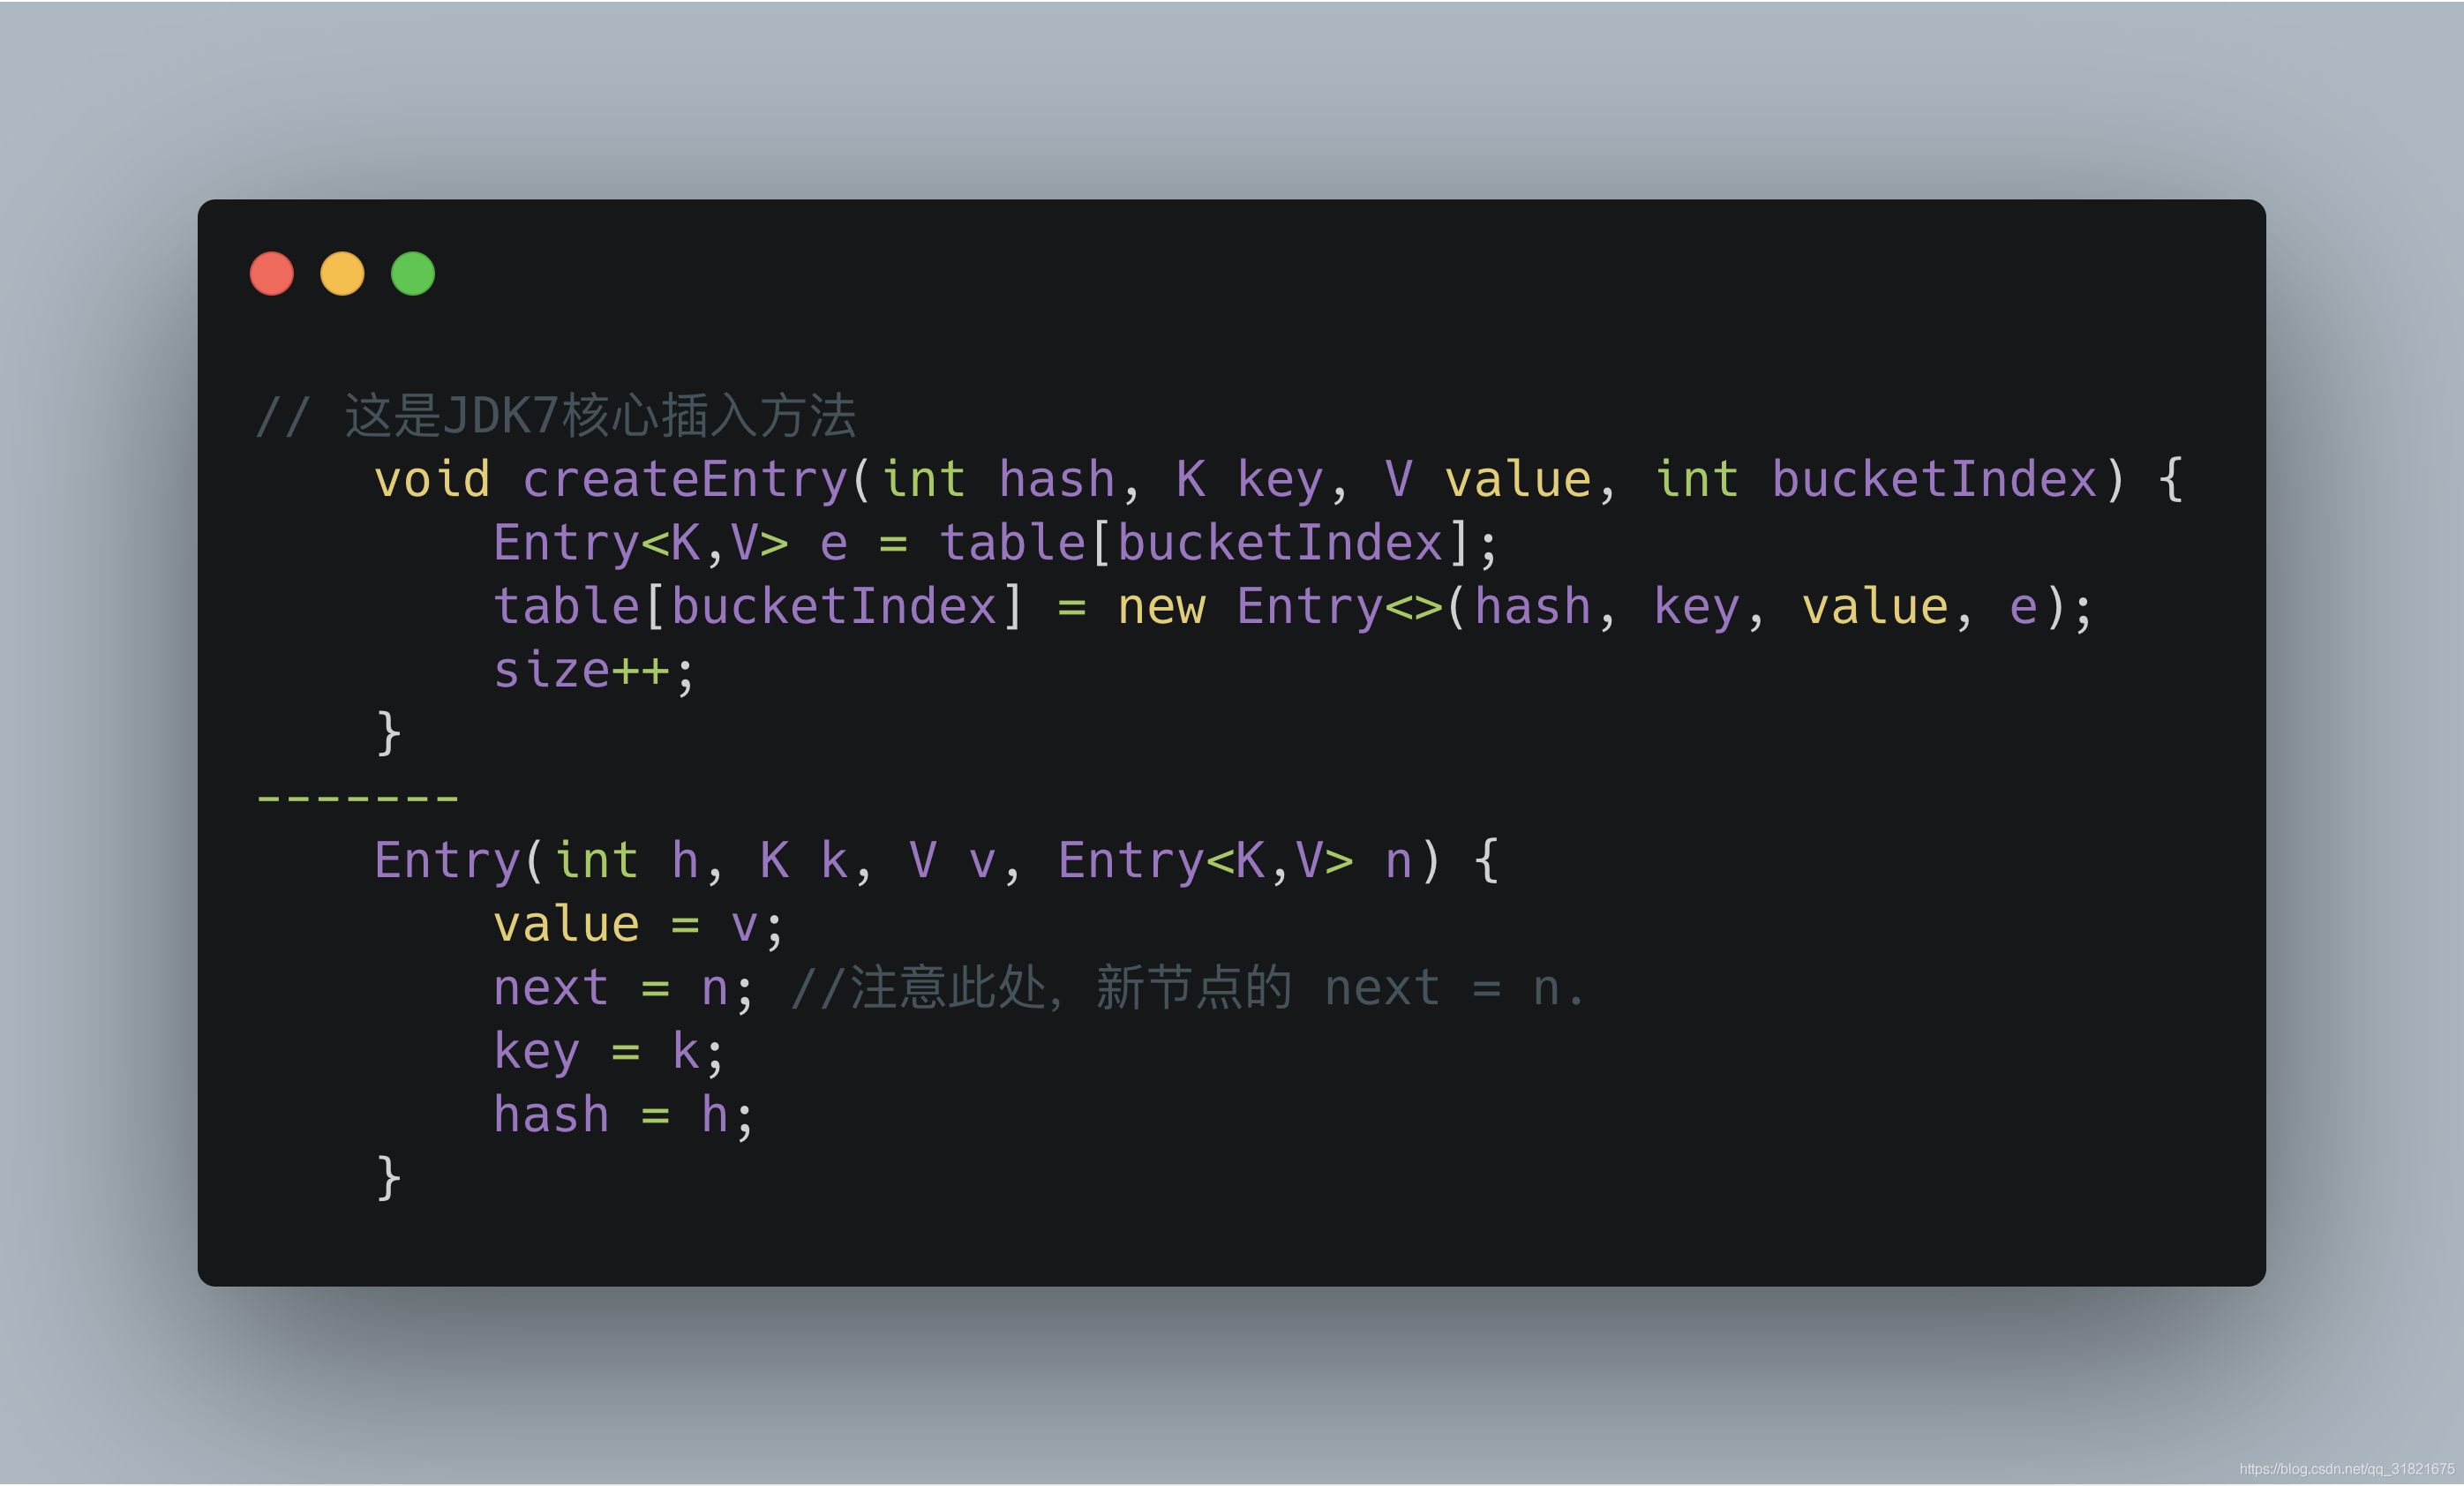
e是通过尾插法(类似与排队在最后面),而在JDK7中是前插法(类似与加塞在最前面,之所以这样做是HashMap发明者认为后插入节被访问概率更大),对应代码如下。
- 对找到的旧节点
e进行判断
- oldValue对应的旧值如果为NULL,那么无论onlyIfAbsent是否决定替换。都将被替换。
- oldValue对应的旧值如果不为NULL,那么如果onlyIfAbsent是false就替换。
- onlyIfAbsent:只有在缺席的情况下才替换,不缺席不替换。跟redis
Setnx同样的功能。
- 数据最终添加完毕后要对对修改后的变量
modCount加1,同时看最新的总的节点数是否需要扩容了,如果是就扩容。
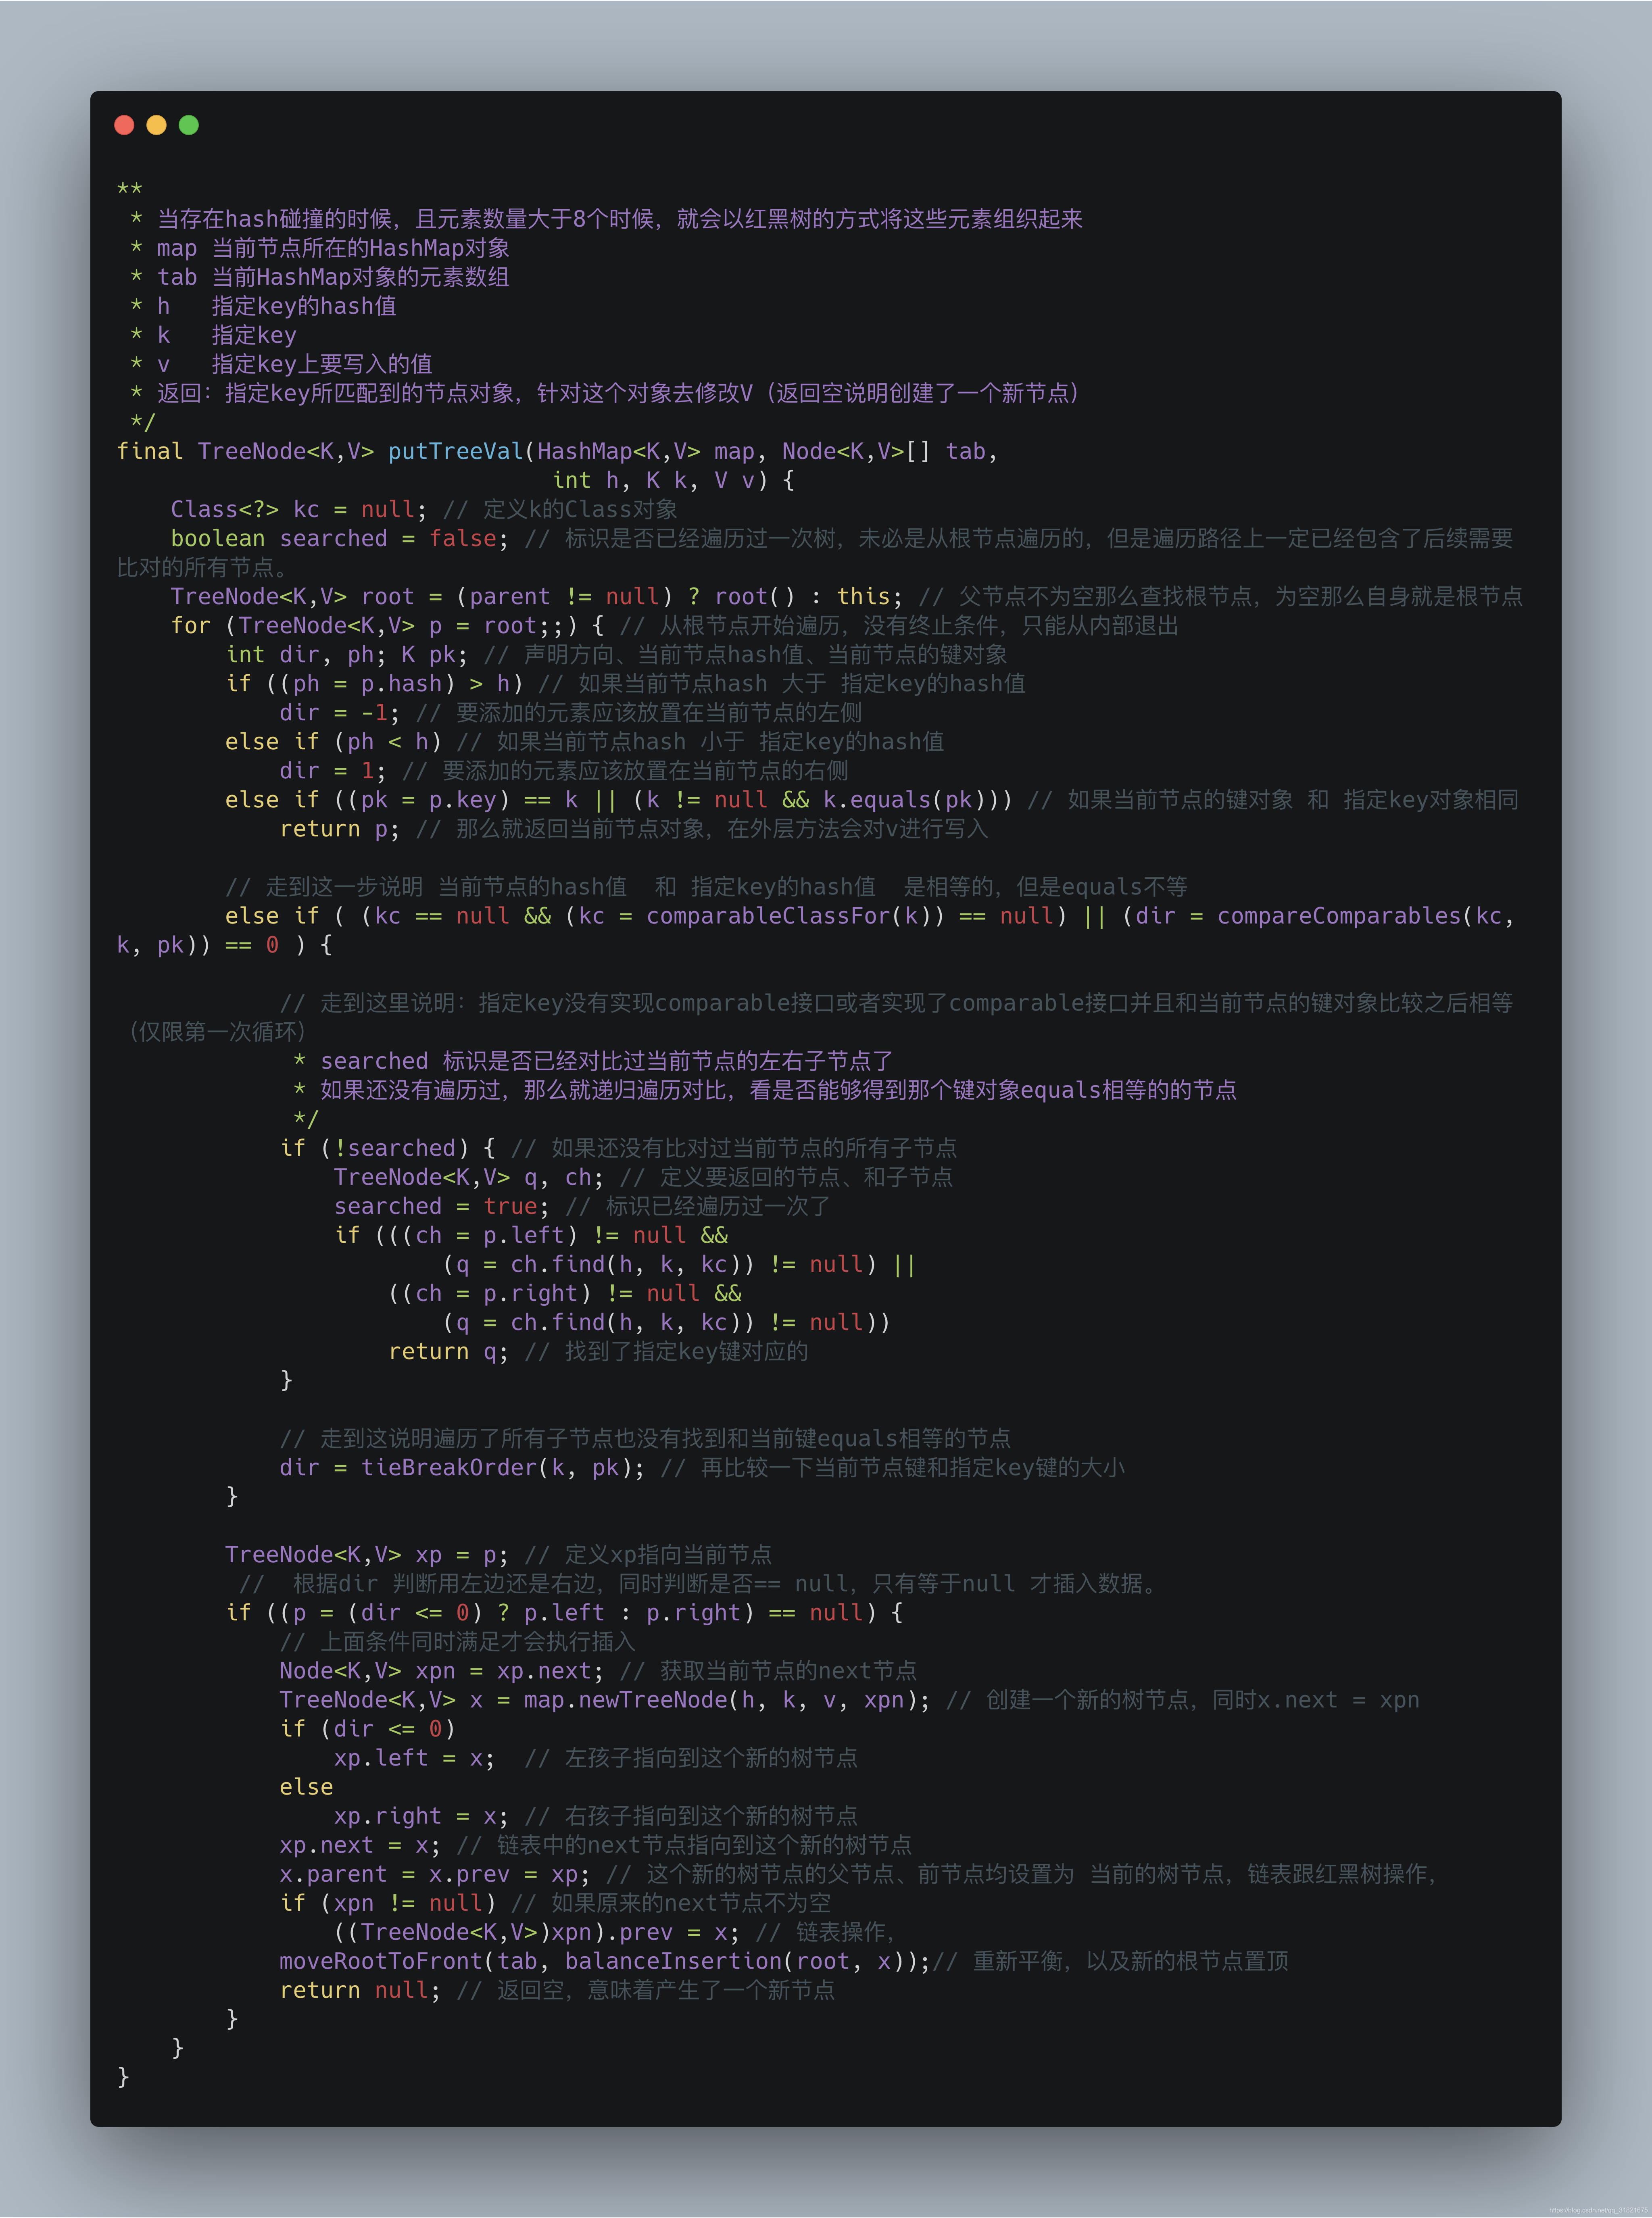
putTreeVal
- 先找到根节点,然后判断是从左边找还是右边找key。
- 找到了则直接返回找到的节点。
- 没找到则新建节点将该新建节点放到适当的位置,同时考虑红黑树跟双向链表的节点插入情况。
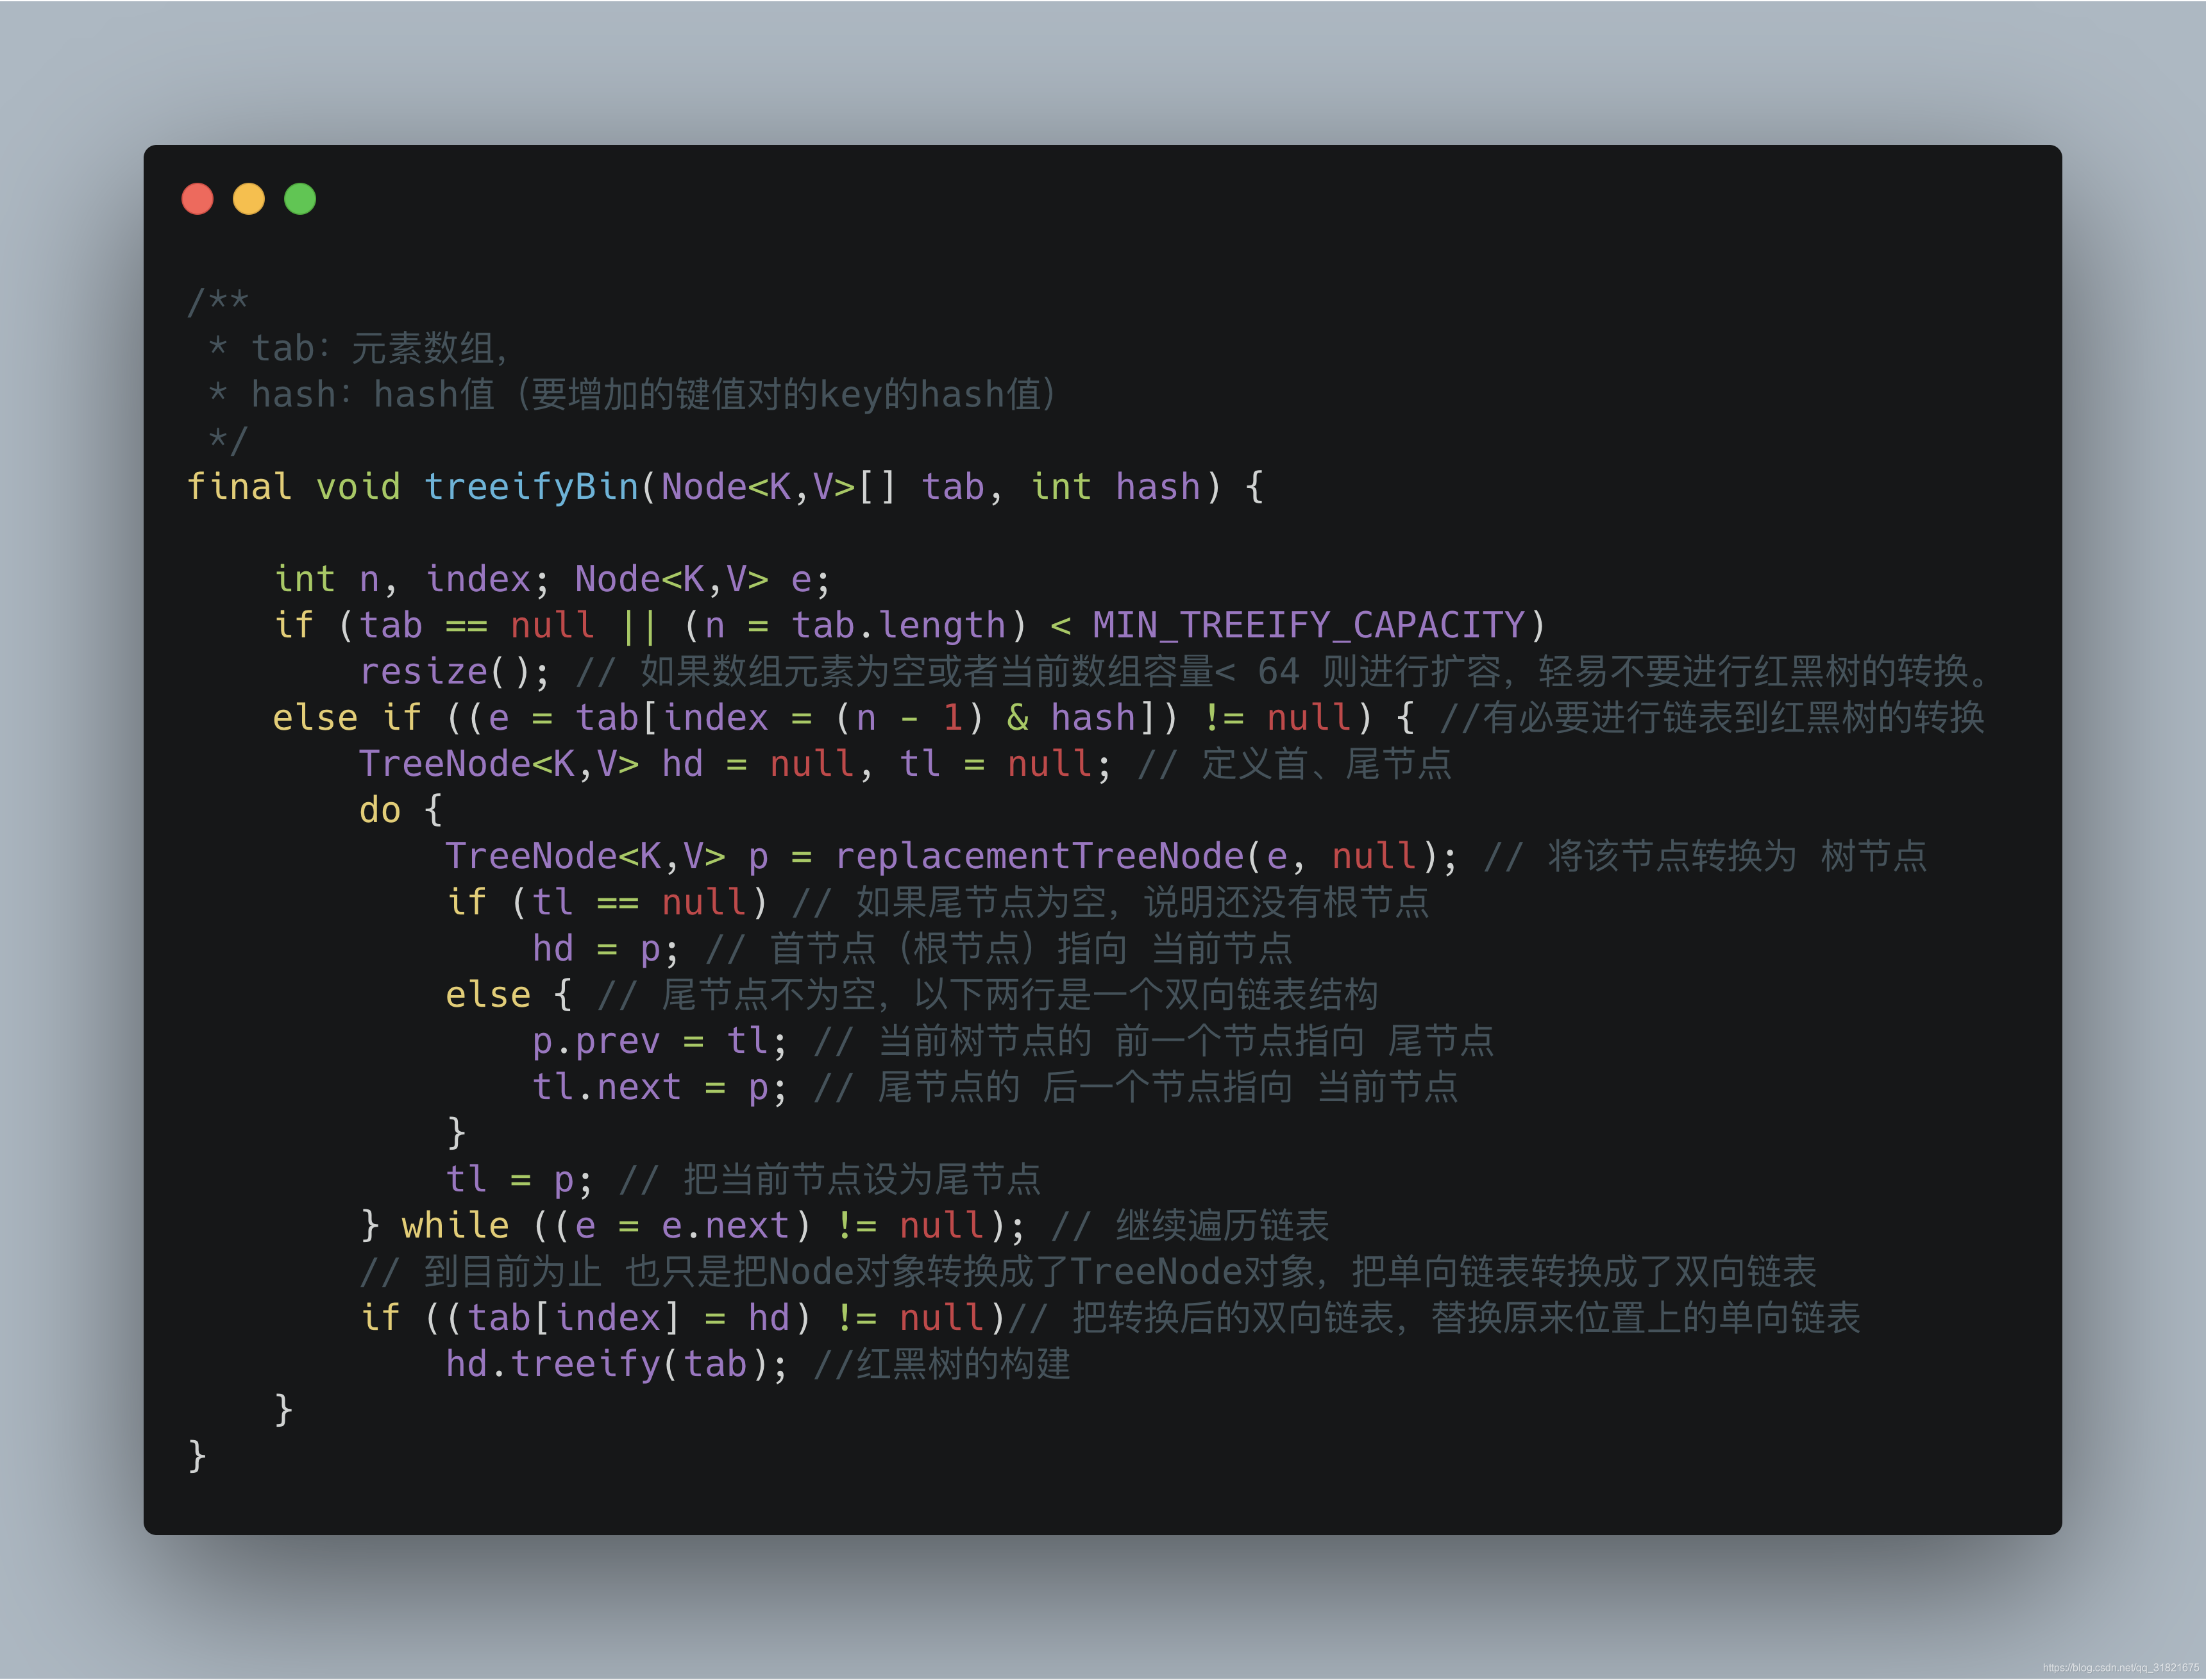
treeifyBin
主要功能是根据参数的阈值范围绝对是否将链表转化为红黑树,然后首先将单项链表转化为双向链表,再调用treeify以头节点为根节点构建红黑树。
treeify
双向链表跟红黑树创建,主要步骤分3步。
- 从该双向链表中找第一个节点为root节点。
- 每一个双向链表节点都在root节点为根都二叉树中找位置然后将该数据插入到红黑树中,同时要注意balance。
- 最终要注意将根节点跟当前
table[i]对应好。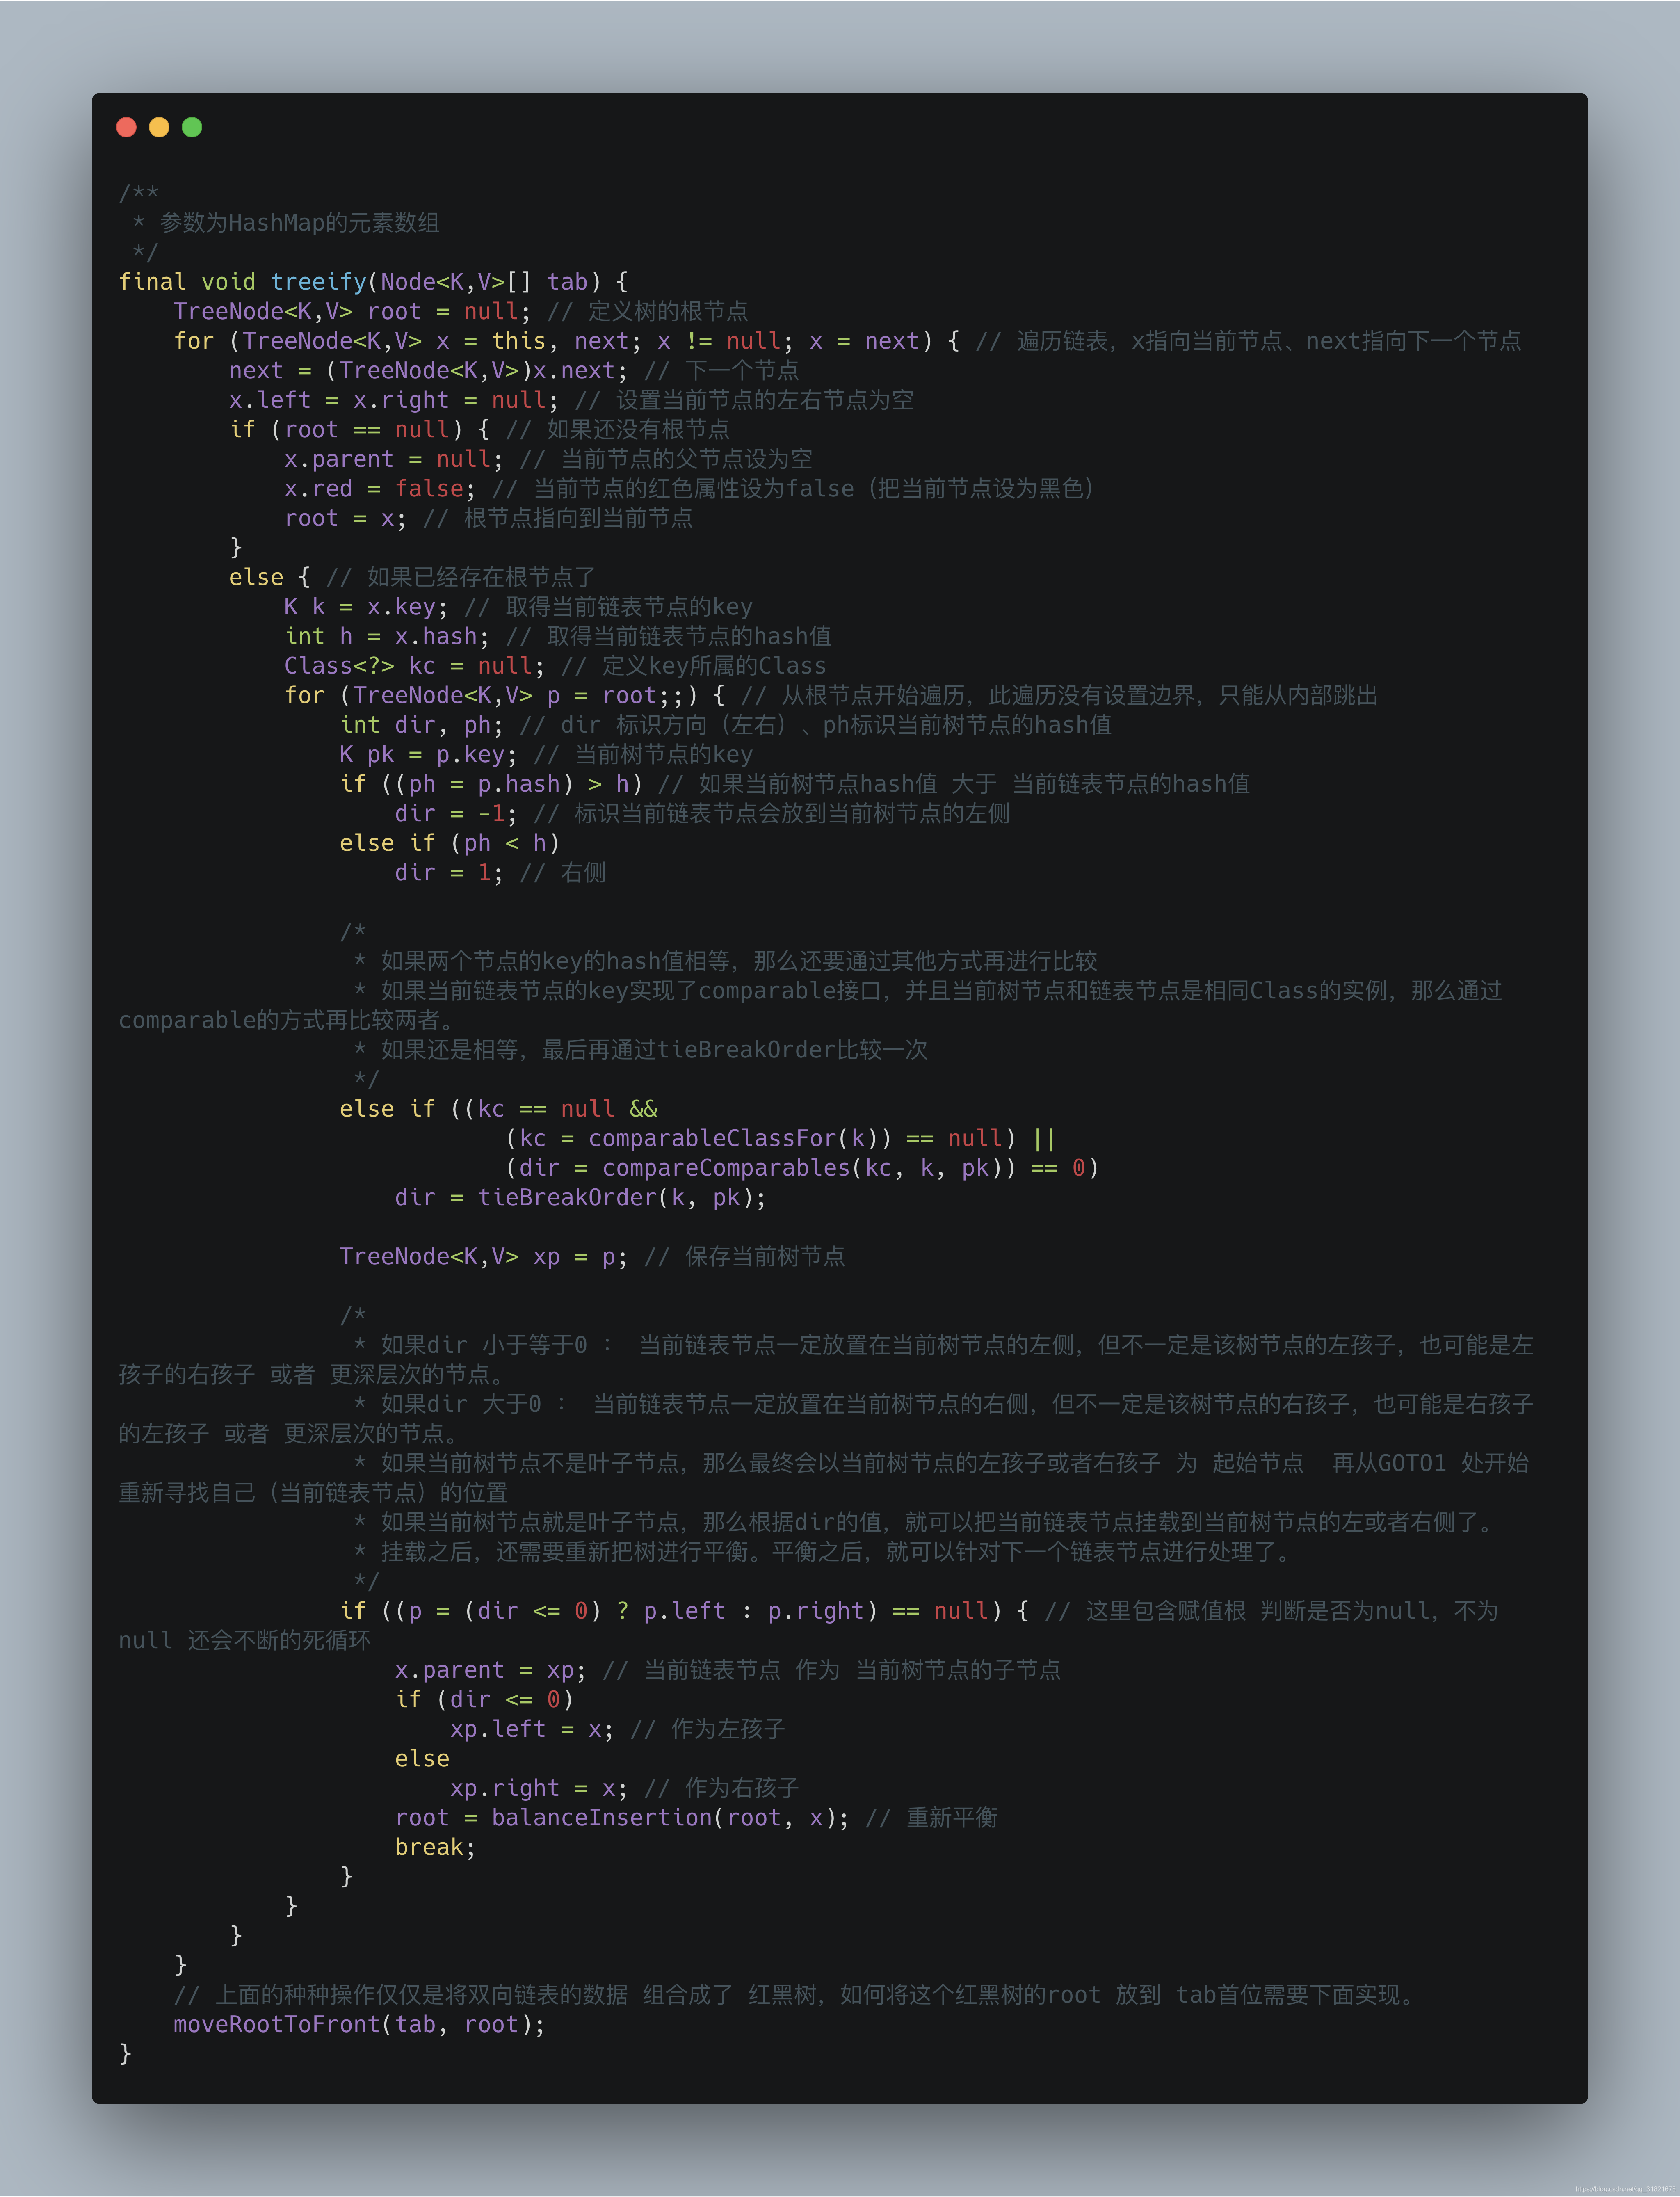
moveRootToFront
确保将root节点挪动到table[first]上,如果红黑树构建成功而没成功执行这个任务会导致tablle[first]对应的节点不是红黑树的root节点。正常执行的时候主要步骤分2步。
- 找到跟节点然后将
root节点放到跟节点,至此关于红黑树到操作搞定。 - 原来链表头是
first节点,现在将可能是中间节点的root节点挪到first节点前面。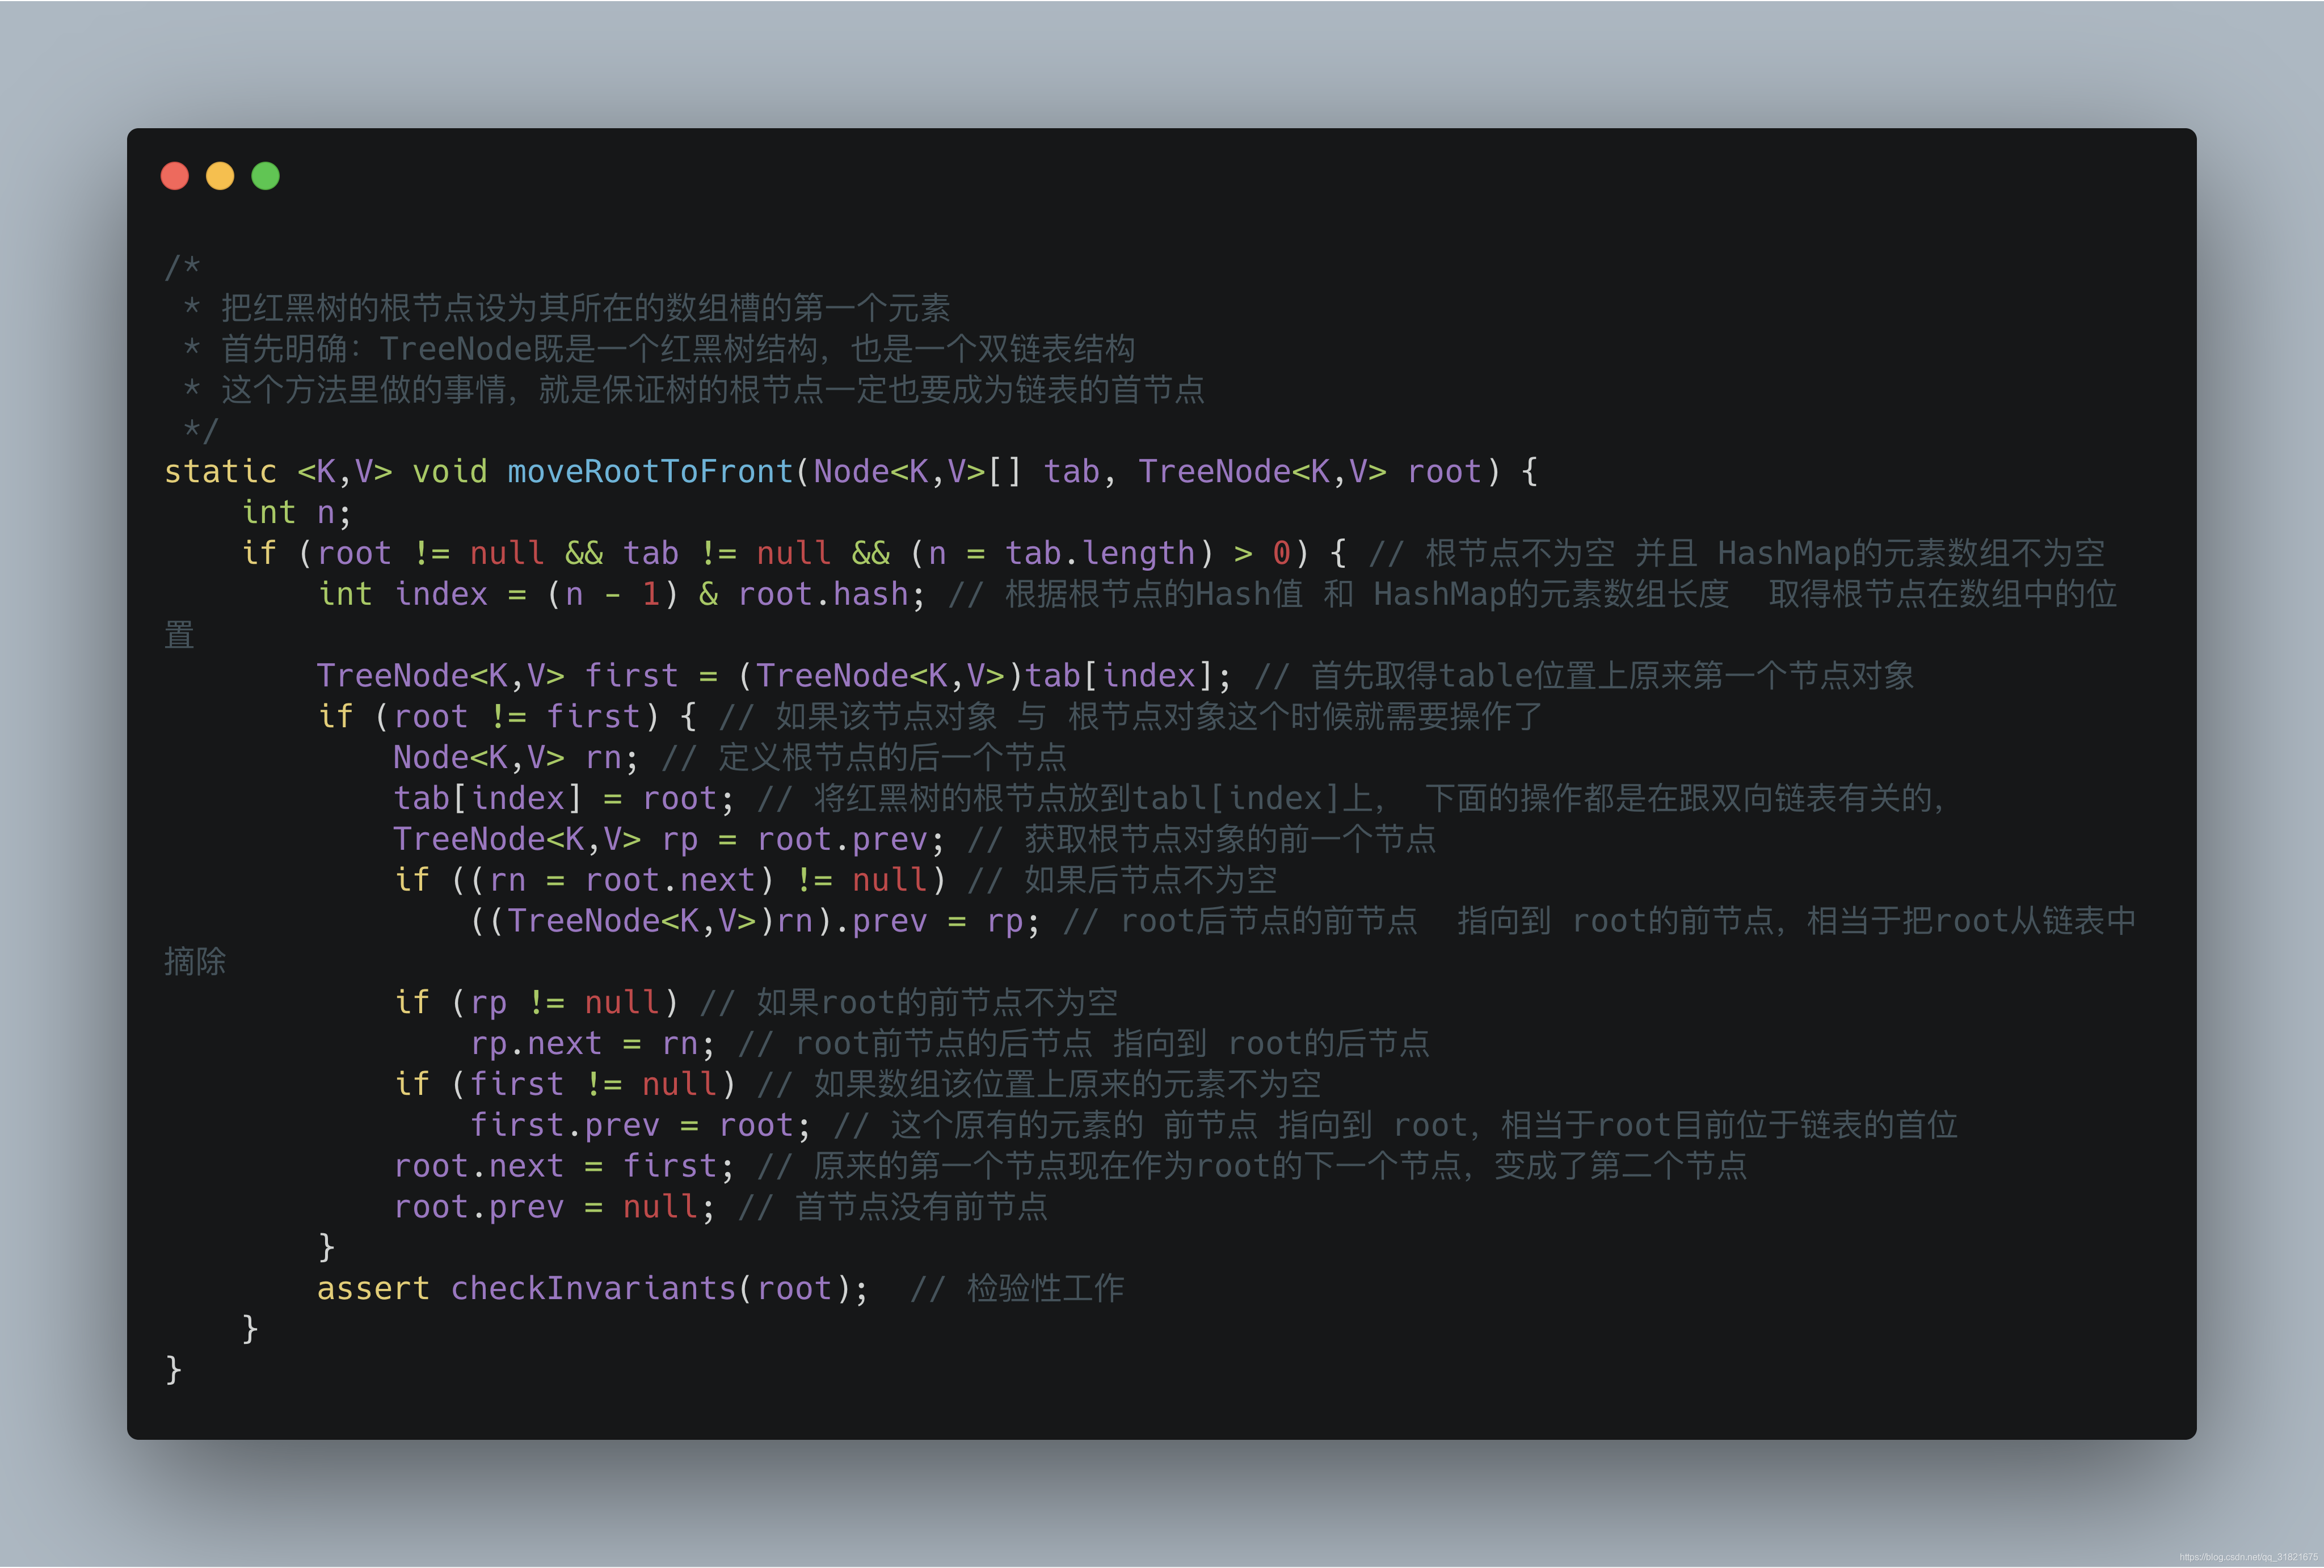
其中checkInvariants函数的作用:校验TreeNode对象是否满足红黑树和双链表的特性。因为并发情况下会发生很多异常。
resize
- 获得老table数据,如果老table已经足够大则不再扩容,只调节阈值。
- 老table扩容后的范围也符合要求直接将容器大小跟阈值都扩容 。
- 如果是带参数构造函数则需要将阈值复制给容器容量。
- 否则认为该容器初始化时未传参,需初始化。
- 如果老table有数据,新他变了大小设置好了但是阈值没设置成功。此时要设置新阈值。
- 创建新容器。
- 老table成功扩容为新table,涉及到数据的转移。
- 数据不为空是单独的节点则直接重新hash分配新位置。
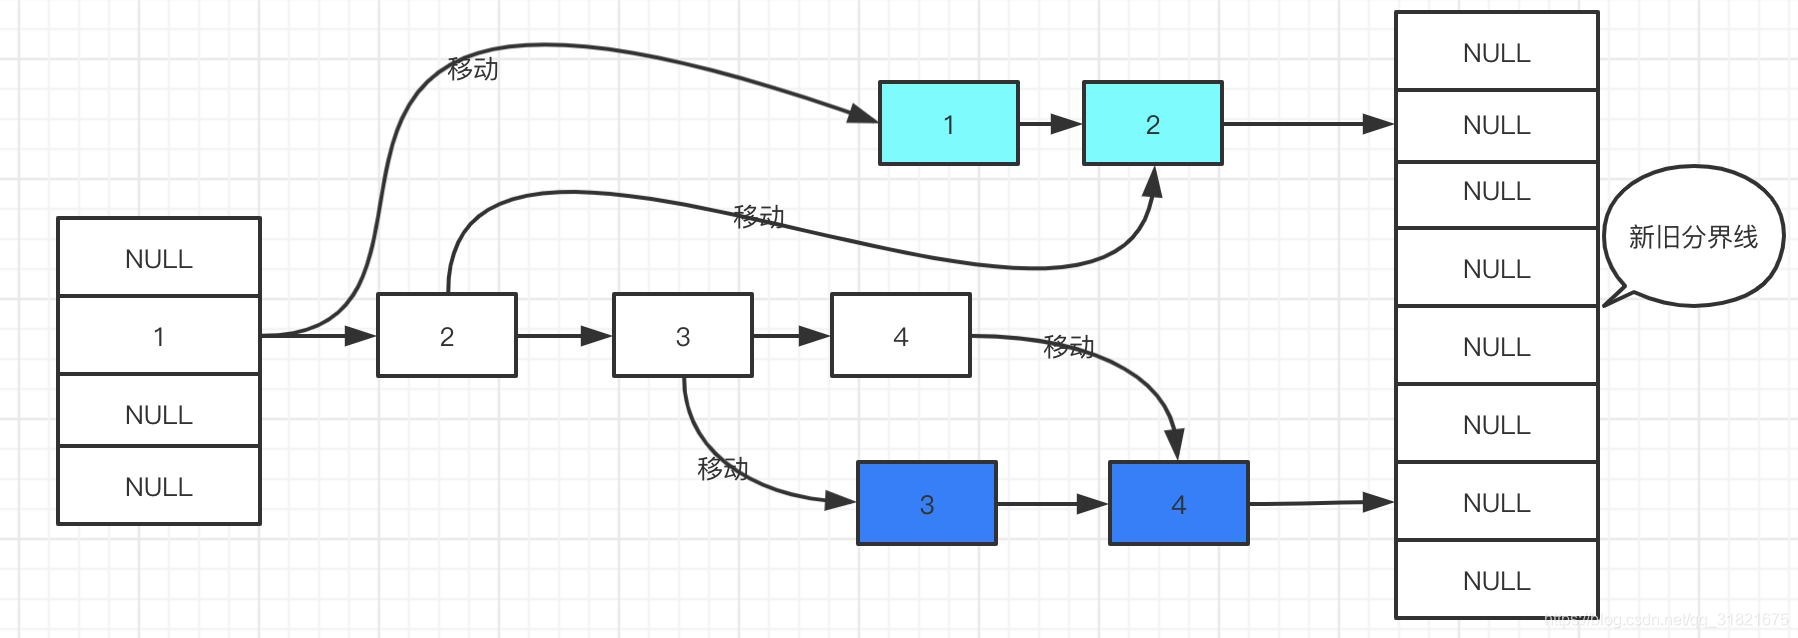
- 数据不为空后面是一个链表,则要把链表数据进行区分看那些分到老地方那些分到新地方。
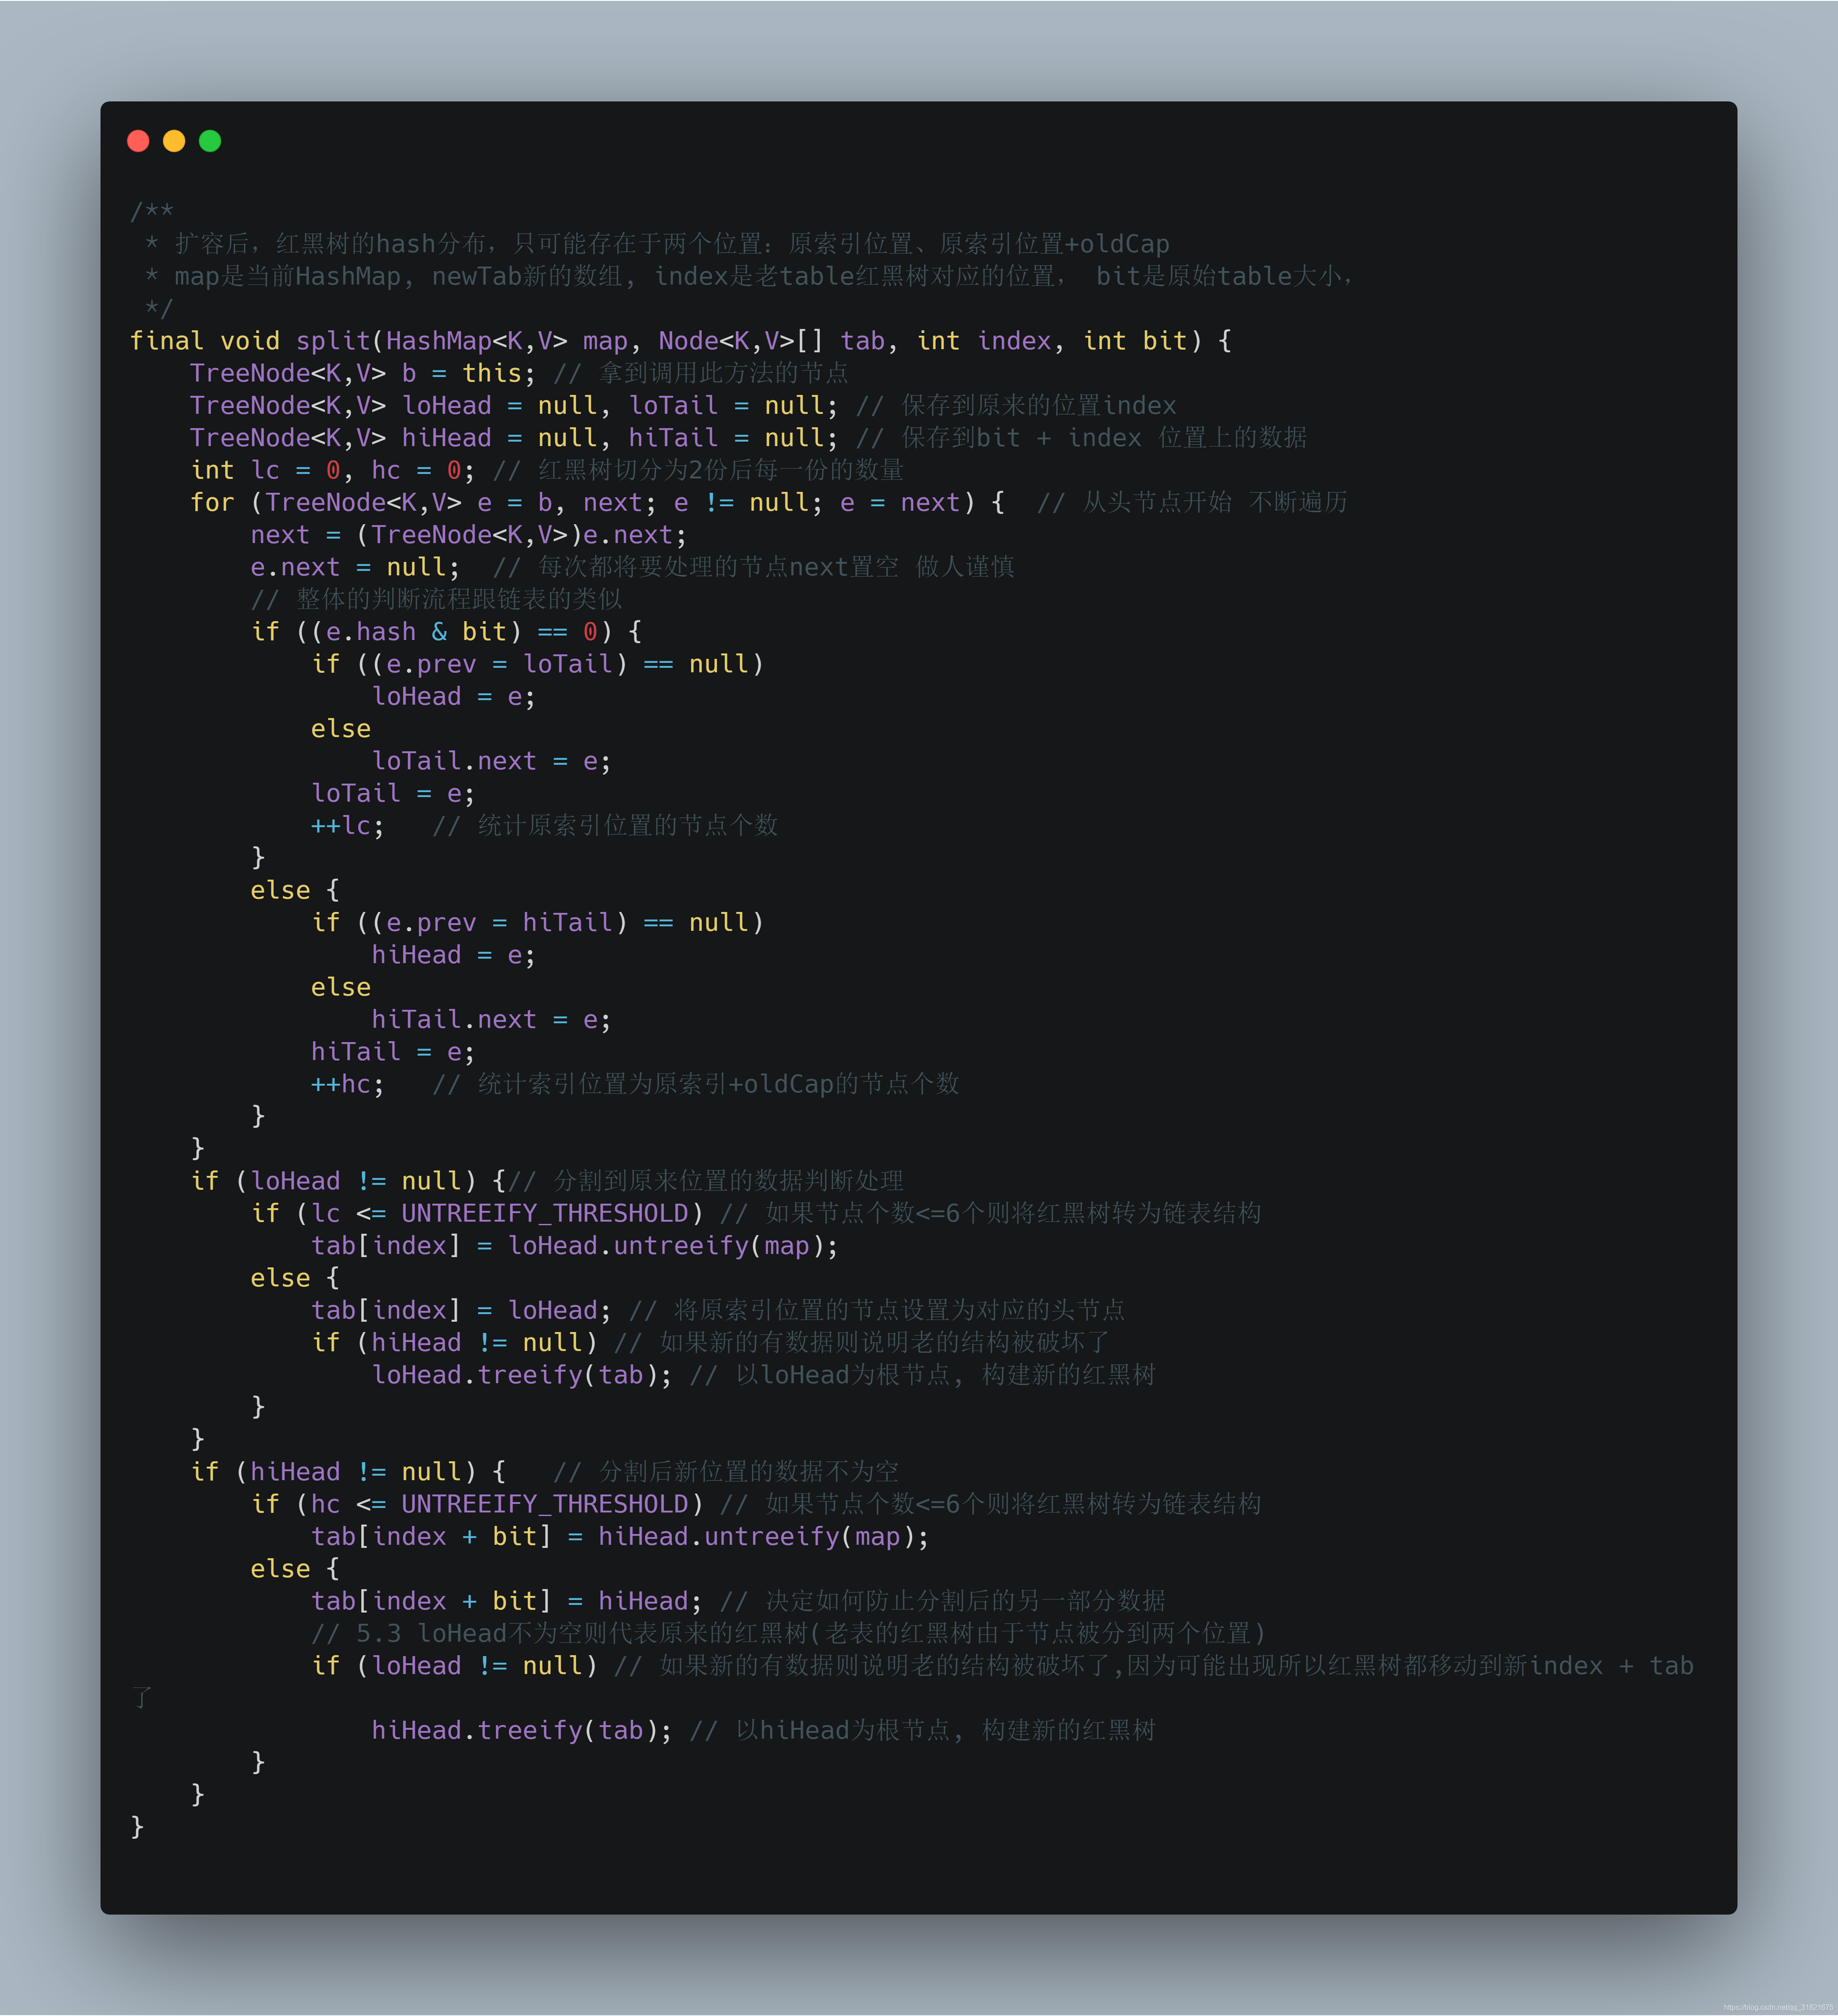
- 如果该节点类型是个红黑树则调用split.
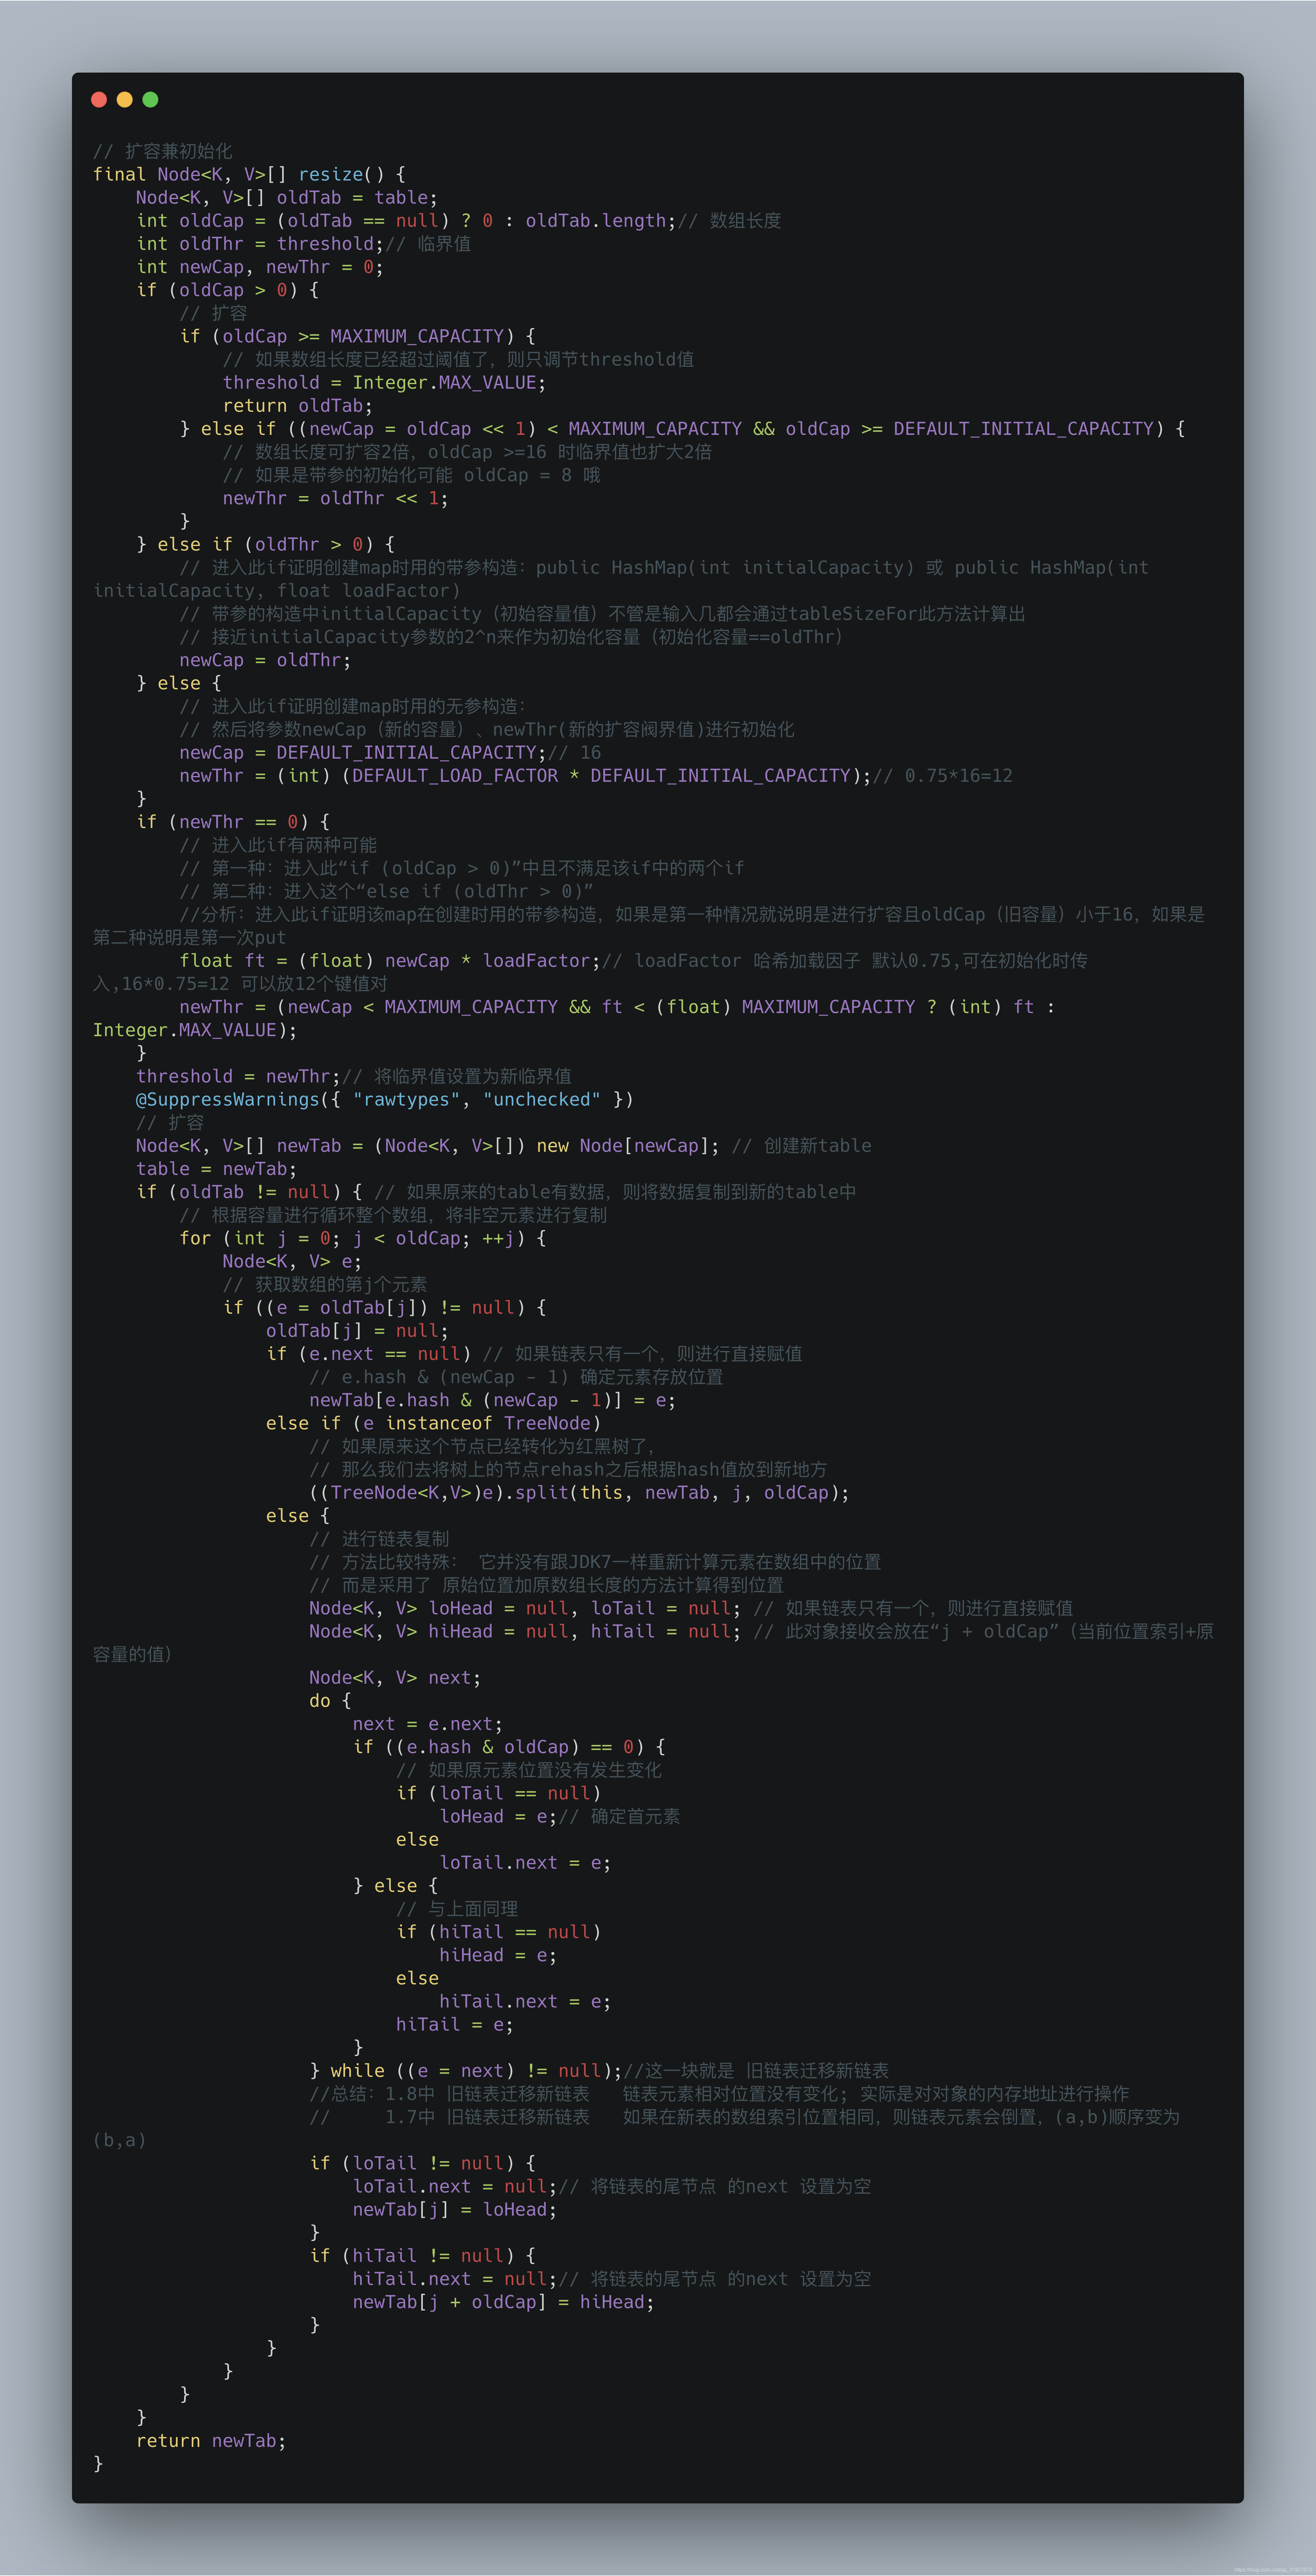
链表形式的重新划分解释如下:
注意:不是(e.hash & (oldCap-1))而是(e.hash & oldCap),
后一个得到的是 元素的在数组中的位置是否需要移动,示例如下
示例1:
e.hash= 10 0000 1010
oldCap=16 0001 0000
& =0 0000 0000 比较高位的第一位 0
结论:元素位置在扩容后数组中的位置没有发生改变
示例2:
e.hash= 17 0001 0001
oldCap=16 0001 0000
& =1 0001 0000 比较高位的第一位 1
结论:元素位置在扩容后数组中的位置发生了改变,新的下标位置是原下标位置+原数组长度
split
扩容后如何处理原来一个table[i]上的红黑树,代码的整体思路跟处理链表的时候差不多,只要理解节点关系保存红黑树的时候也保存了双向链表就OK了。
find
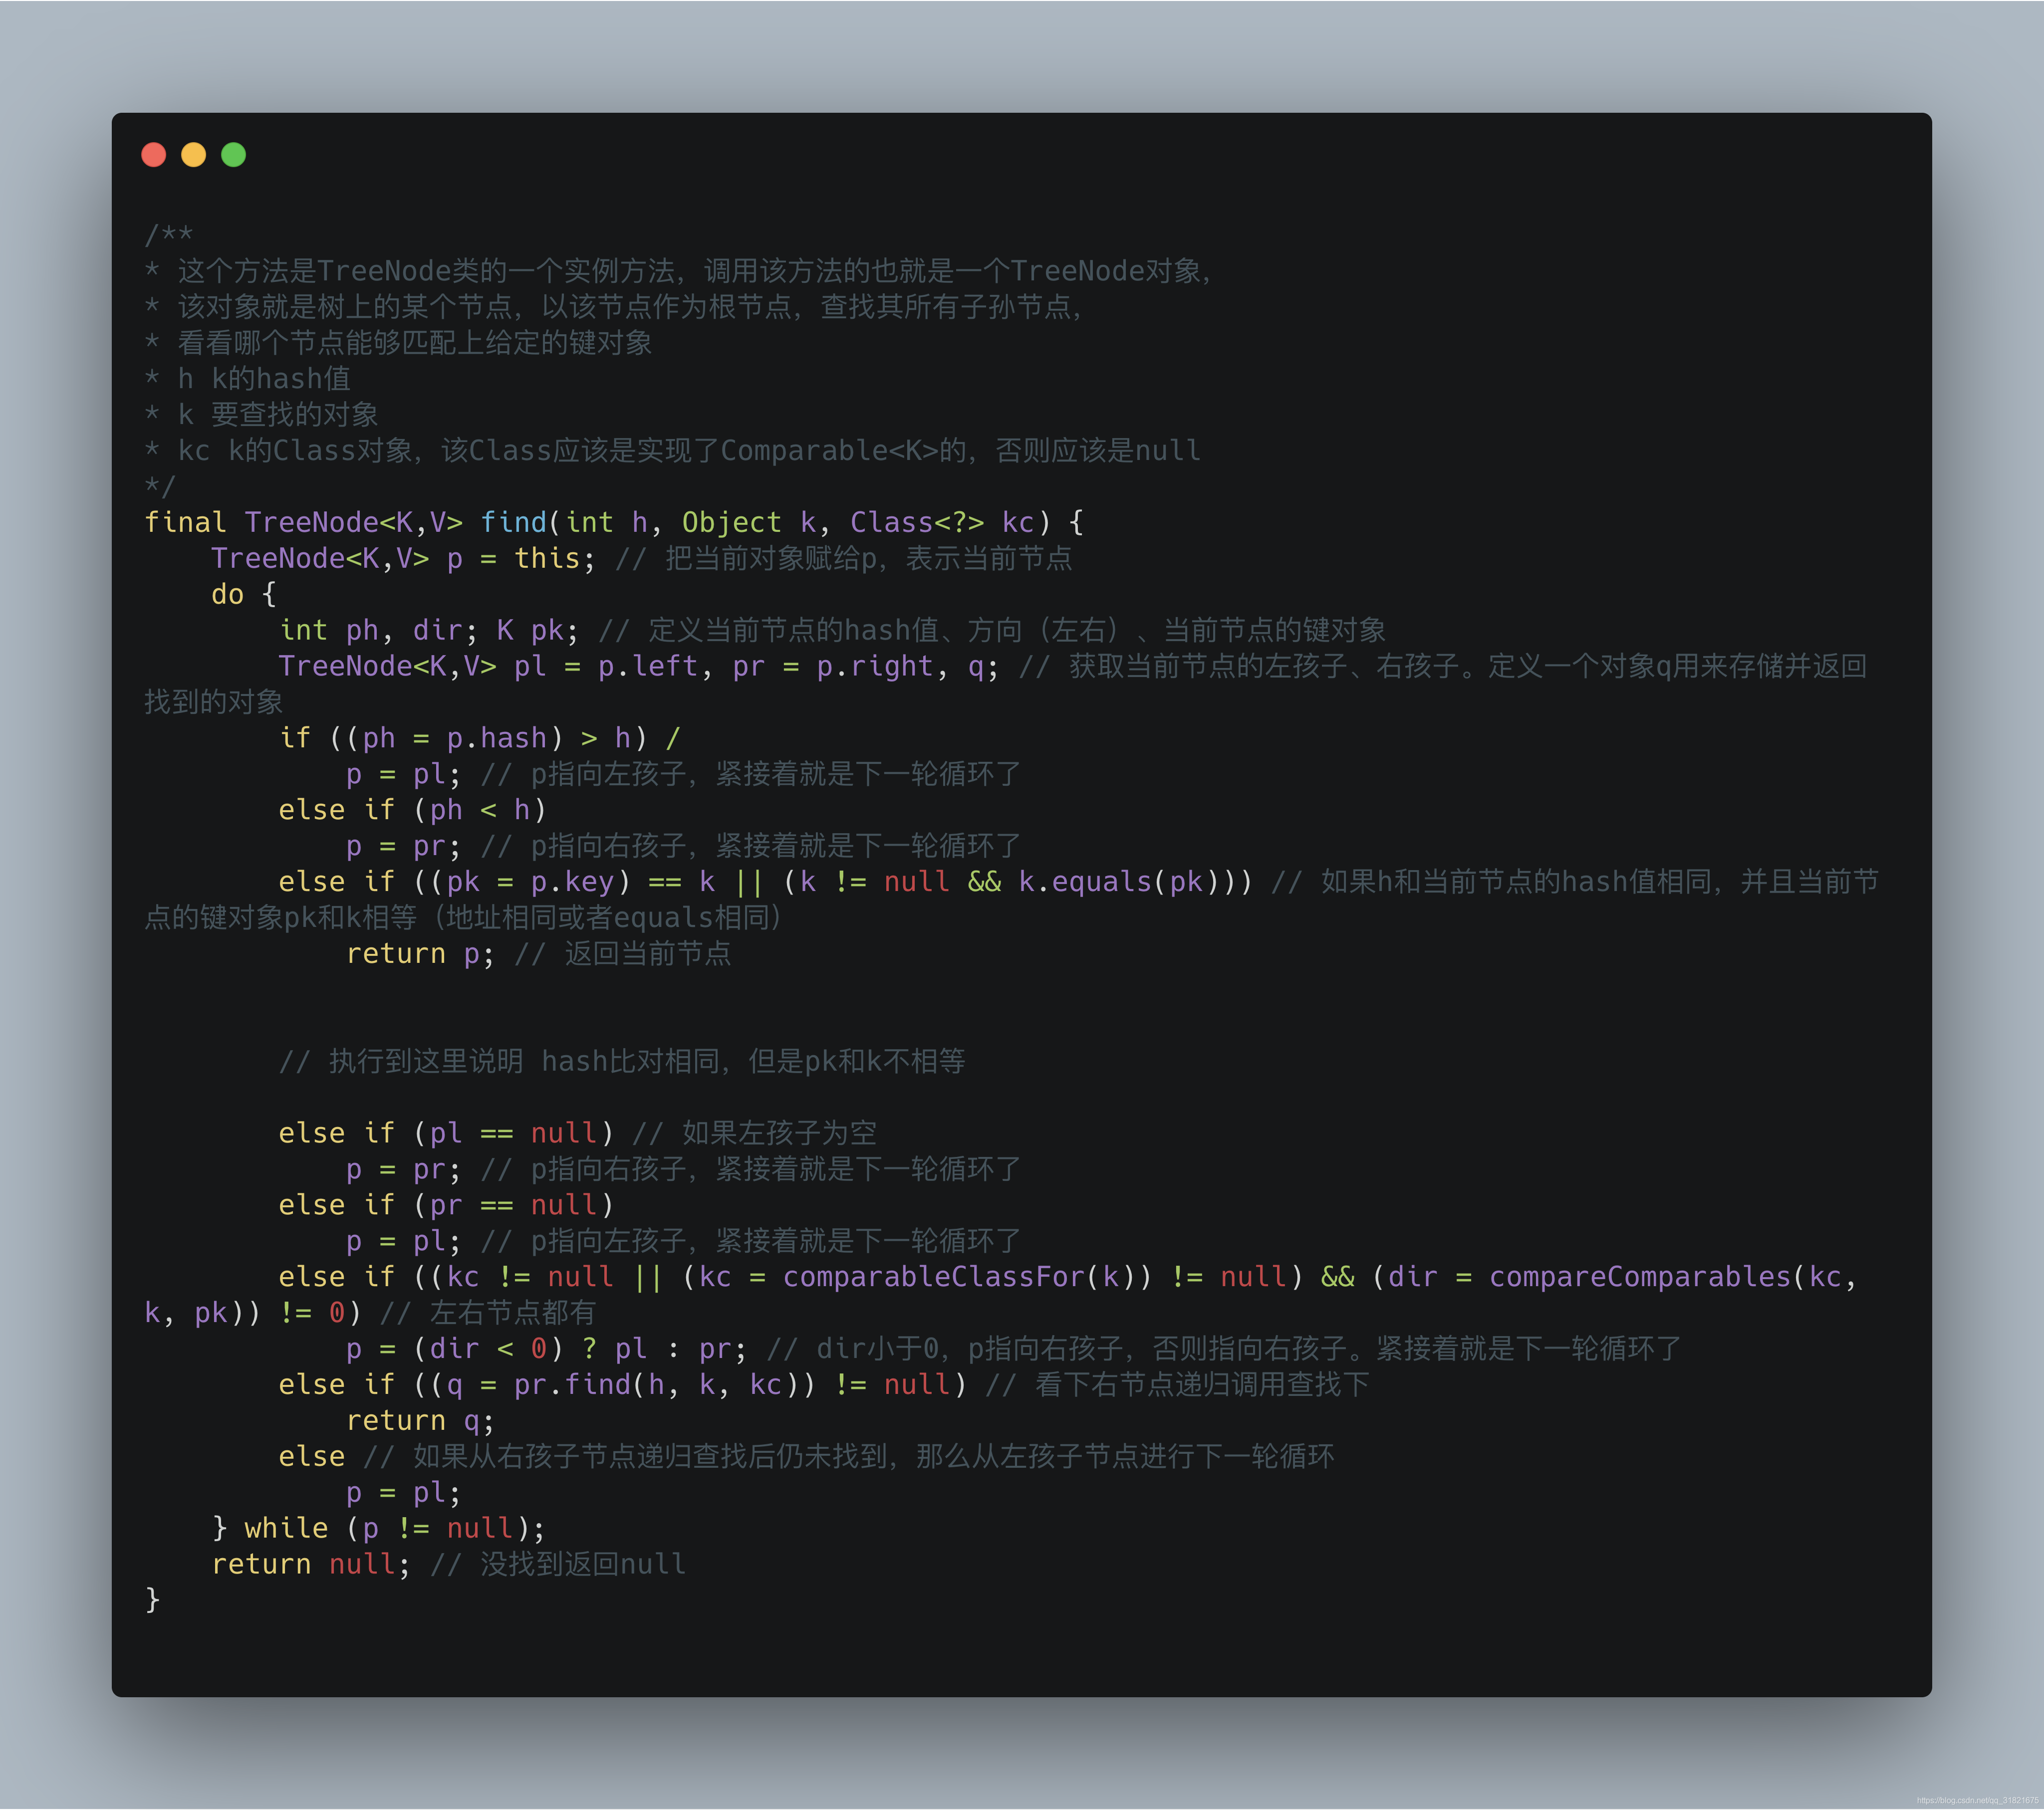
函数功能就是以指定的一个节点为根节点,根据指定的key跟value进行查找。
- 通过hash值判断 左边找还是右边找。
- 如果找到的很简单直接返回。
- 可能出现hash值相等可是
key不一样,继续查找分为三种情况。- 左节点为空则找右节点
- 右节点为空则找左节点
- 左右节点都不会空,尝试通
Comparable对数据看向左还是向右。- 无法通过comparable比较或者比较之后还是相等。
- 直接从右节点递归查找下。
- 否则就从左边查找。
tieBreakOrder
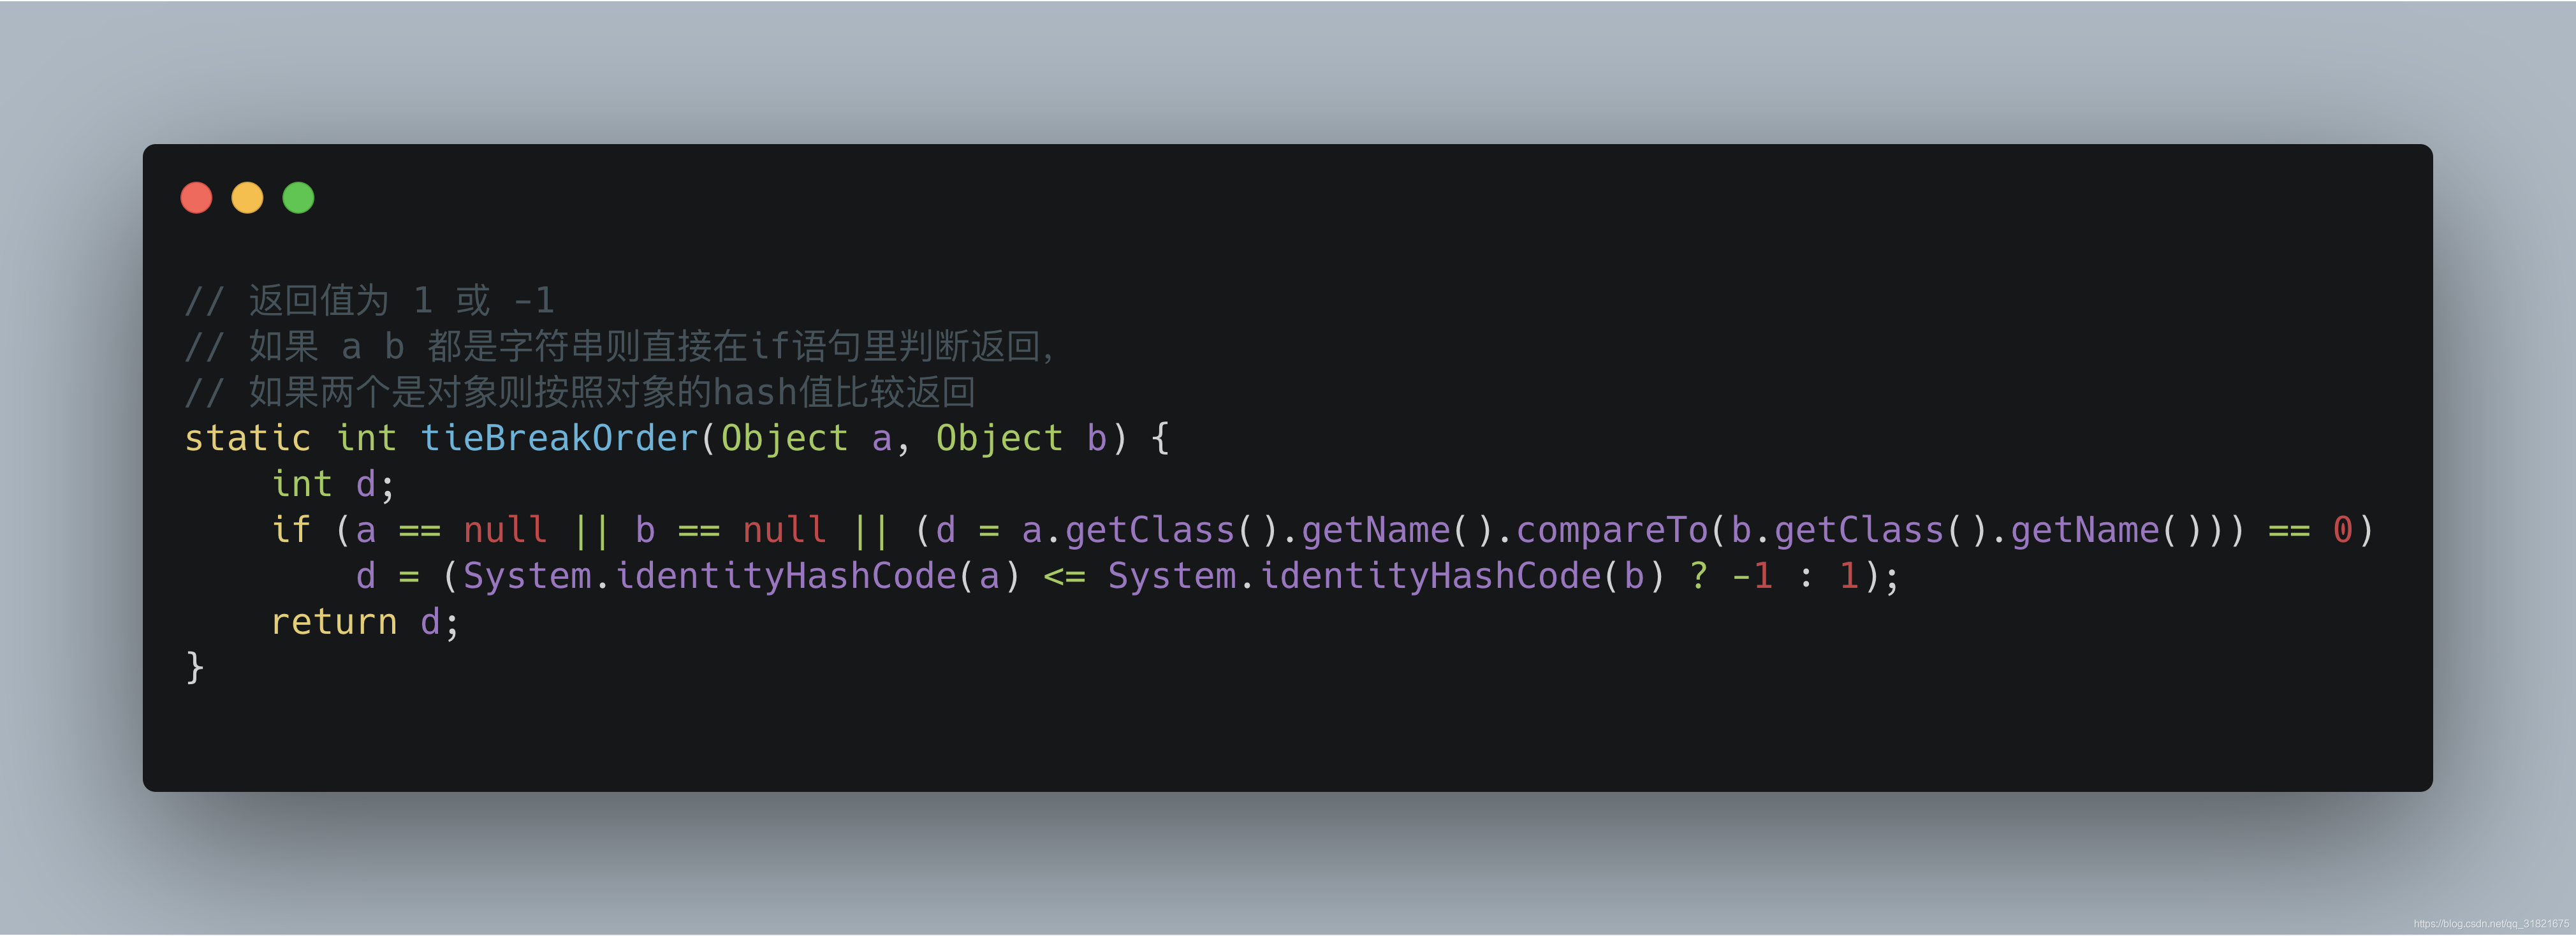
对两个对象进行比较,一定能比出个高低。
- a 跟 b 都是字符串则直接在if判断里比拼完毕
- a 跟 b 都是对象则直接查看对象在JVM中的hash地址,然后比较。
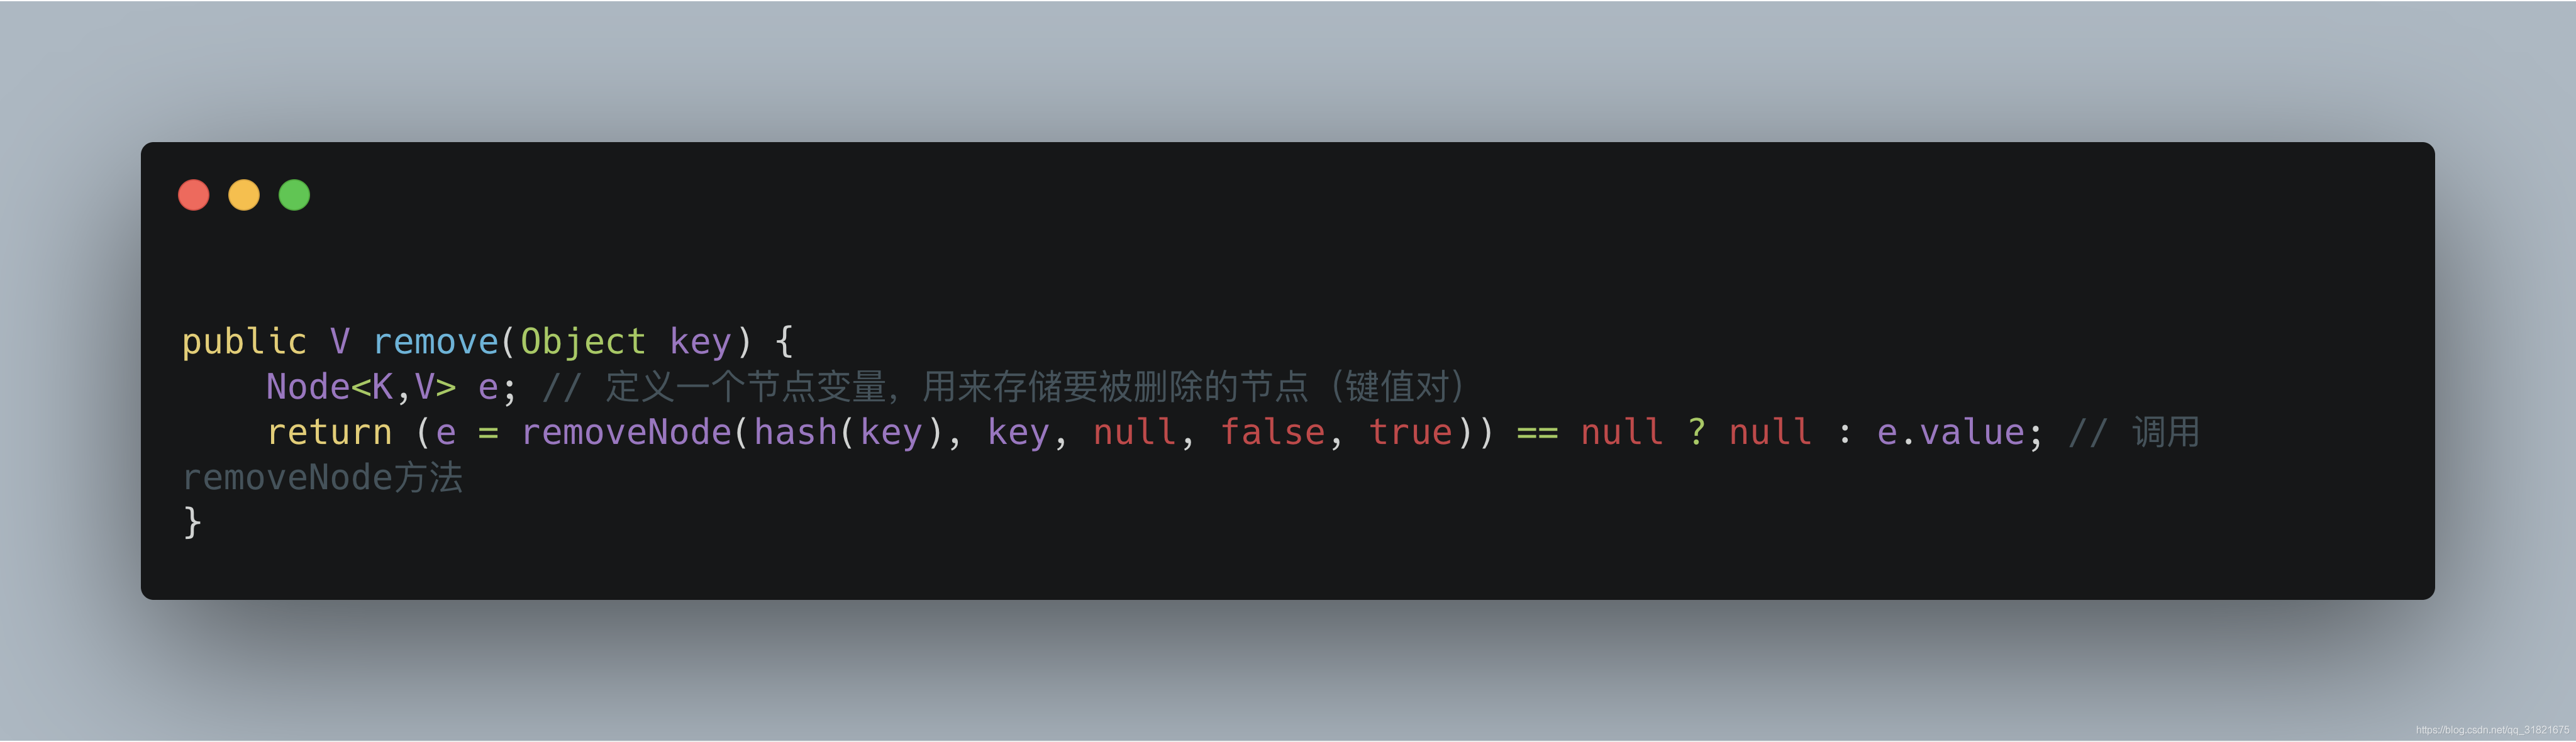
remove
函数入口而已:
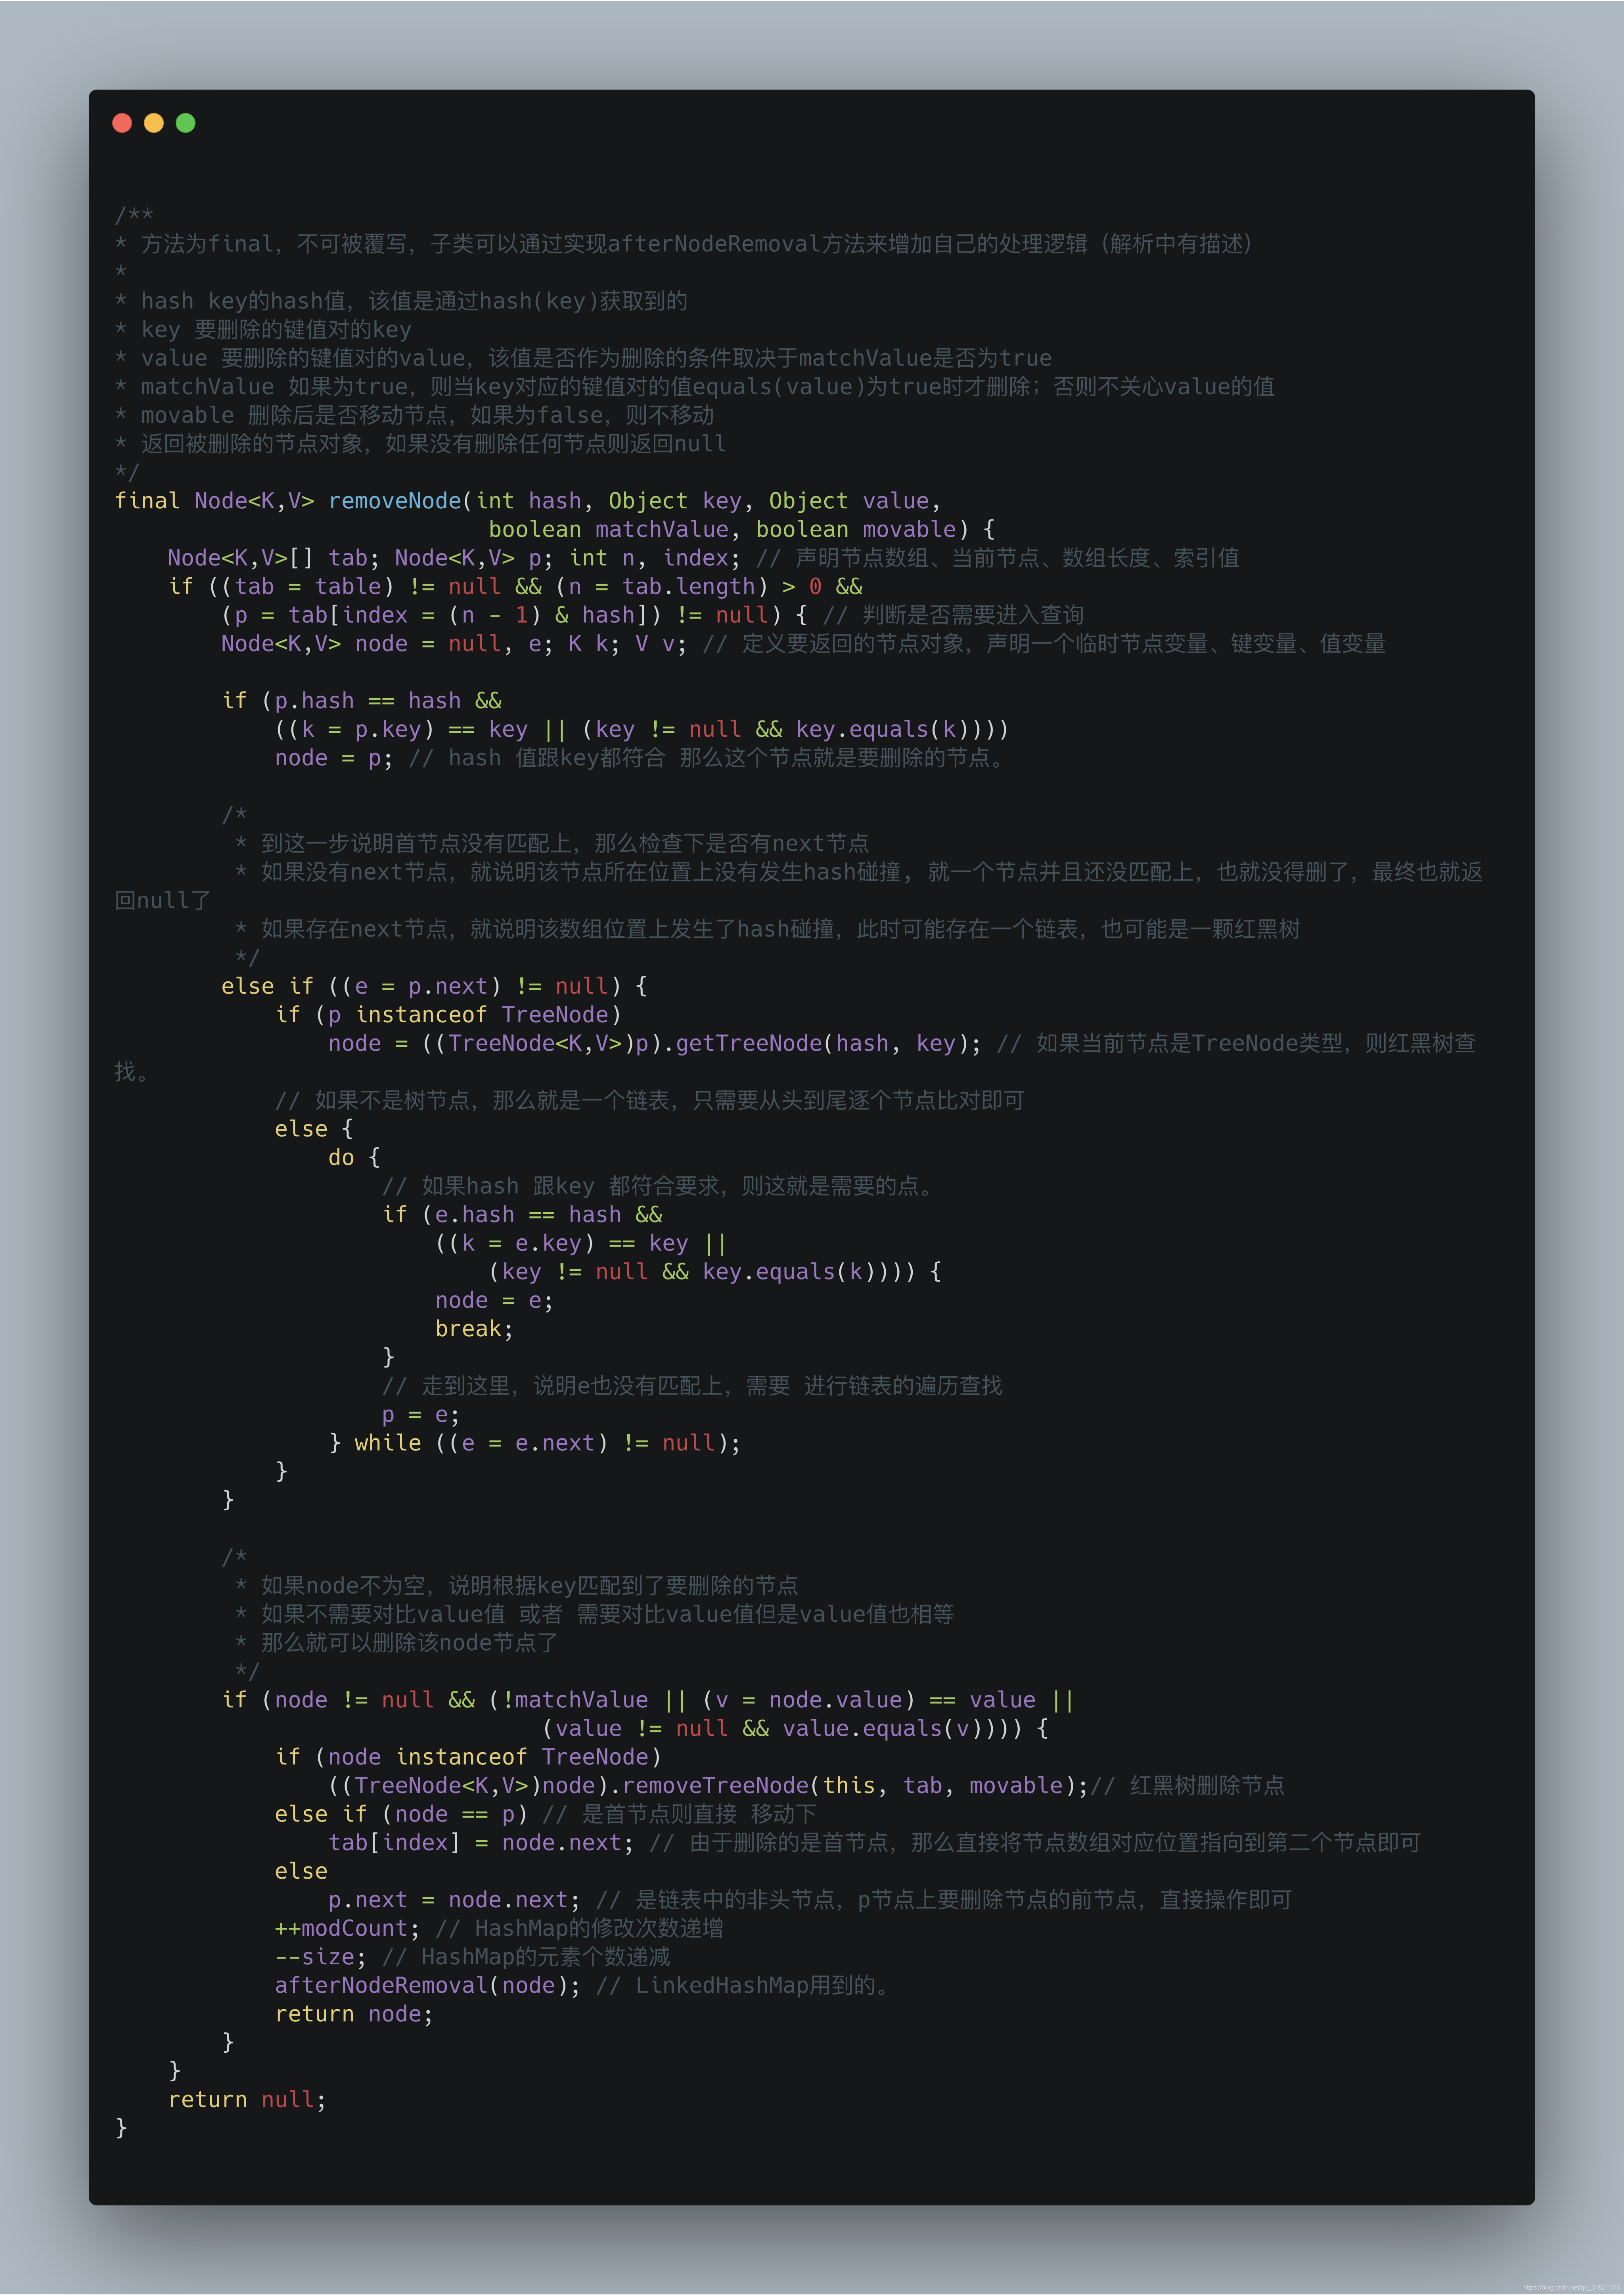
removeNode
removeNode无非就是查看table[i]是否存在,然后是否在首节点上,是否在红黑树上,是否在链表上。这几种情况,找到了则直接删除,同时注意平衡性。
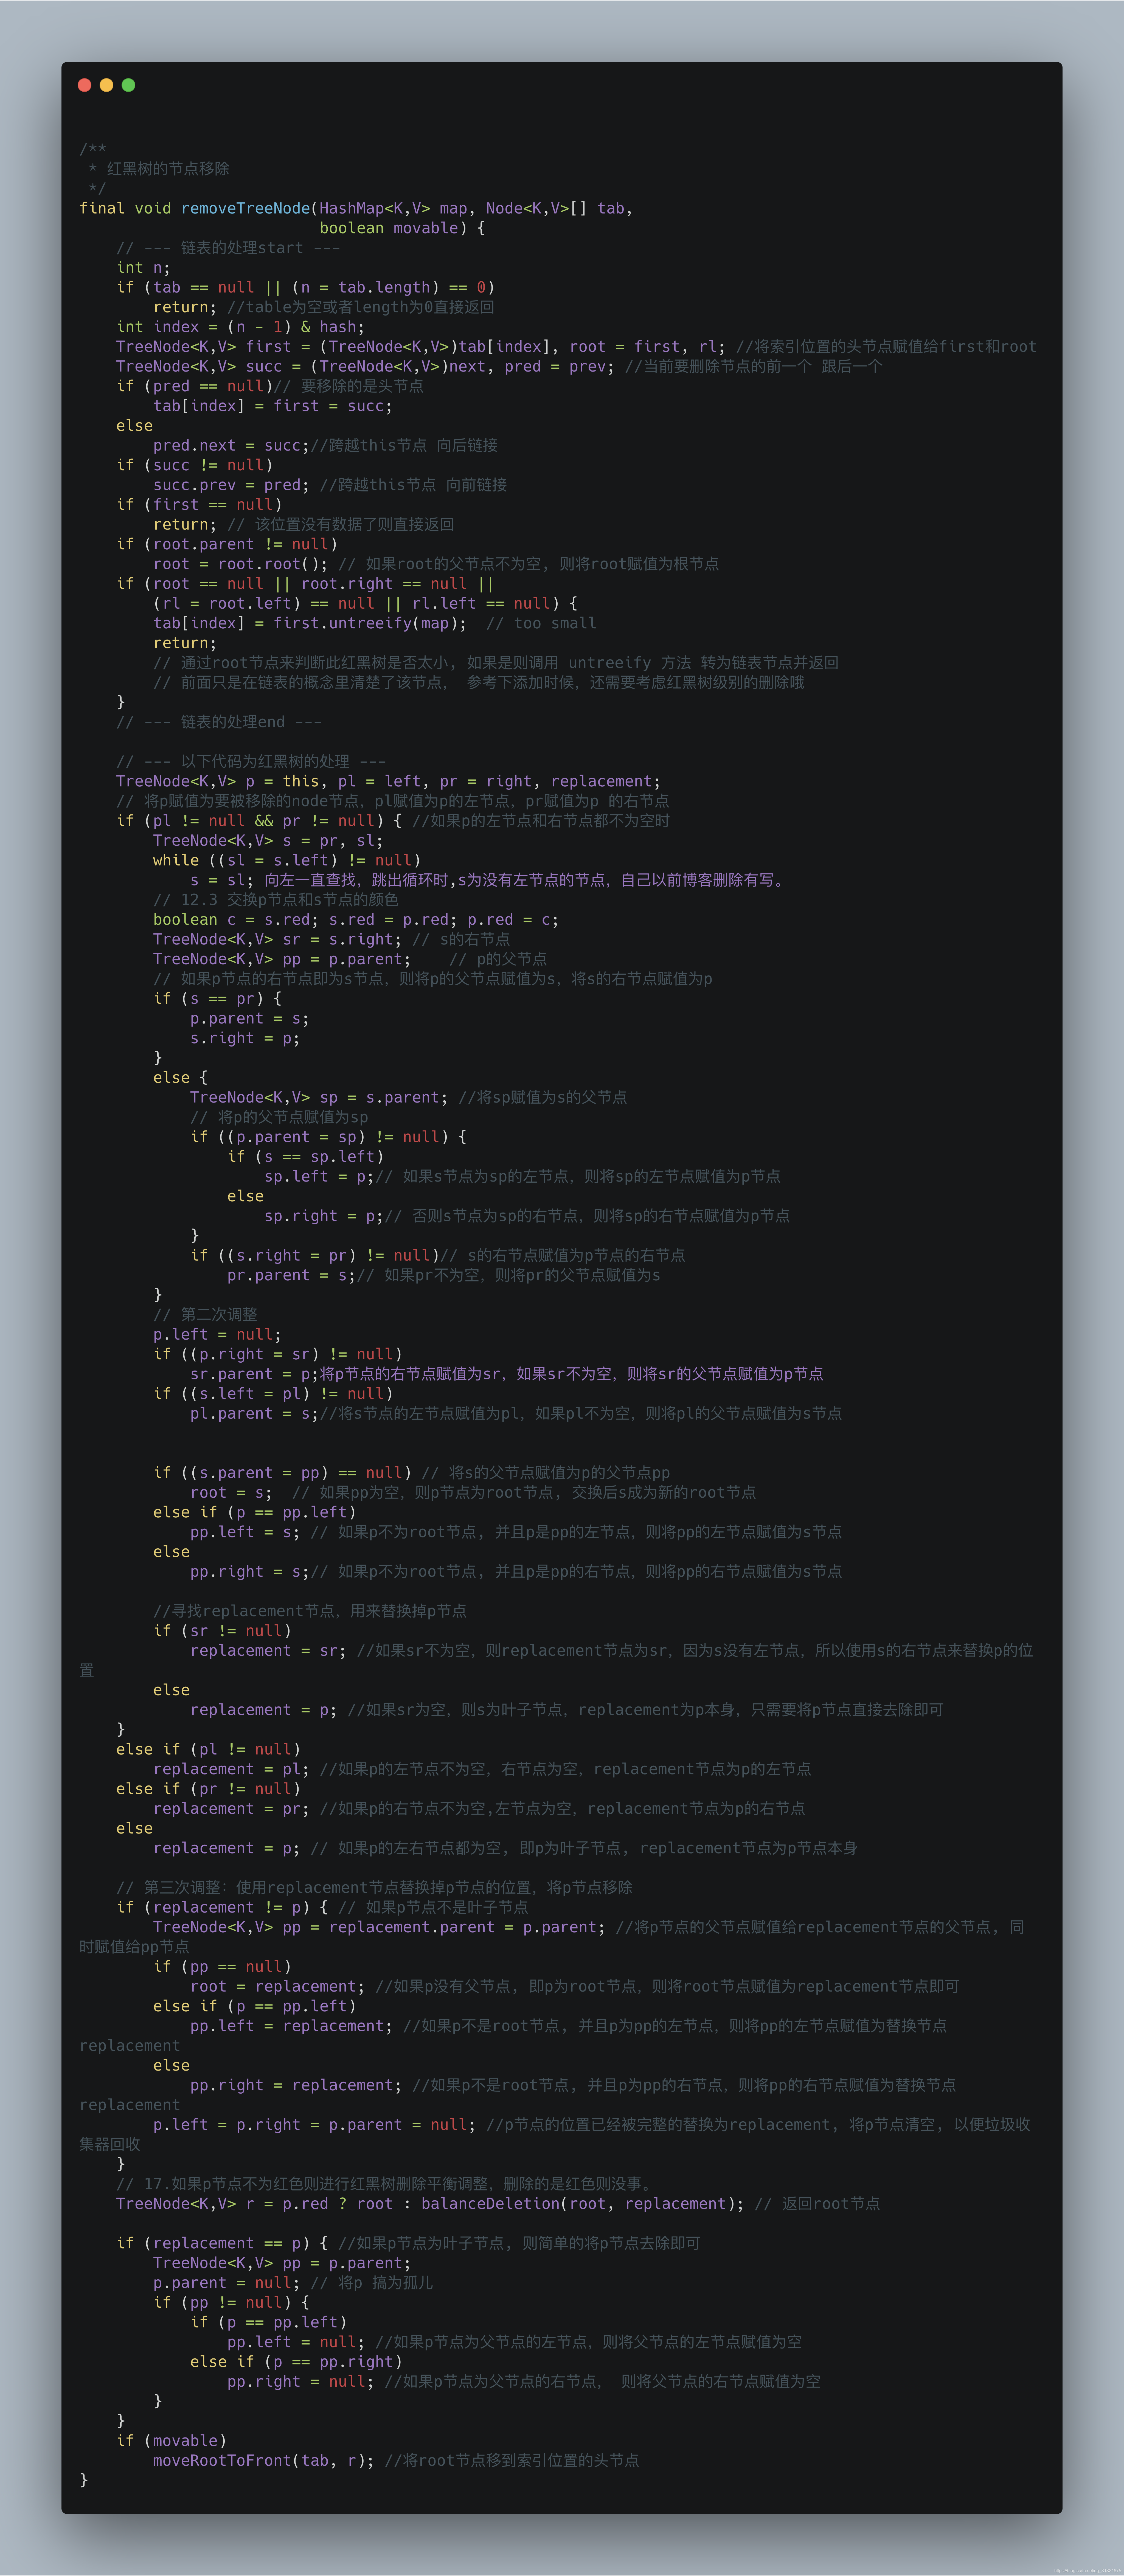
removeTreeNode
该函数的 目的就是移除调用此方法的节点,也就是该方法中的this节点。移除包括链表的处理和红黑树的处理。可以看以前写过的RBT,删除的时候思路大致是一样的,这里大致分为3步骤。
- 红黑树也是双向链表,以链表的角度来删除节点,然后判断是否需要退化为链表。
- 根据当前的
p节点尝试从pr找最小的或者从pl找最大的目标节点s,将两点兑换。- 找到要
replacement来跟p进行替换。- 实施替换。
- 替换后为保持红黑树特性可能需要进行
balance。
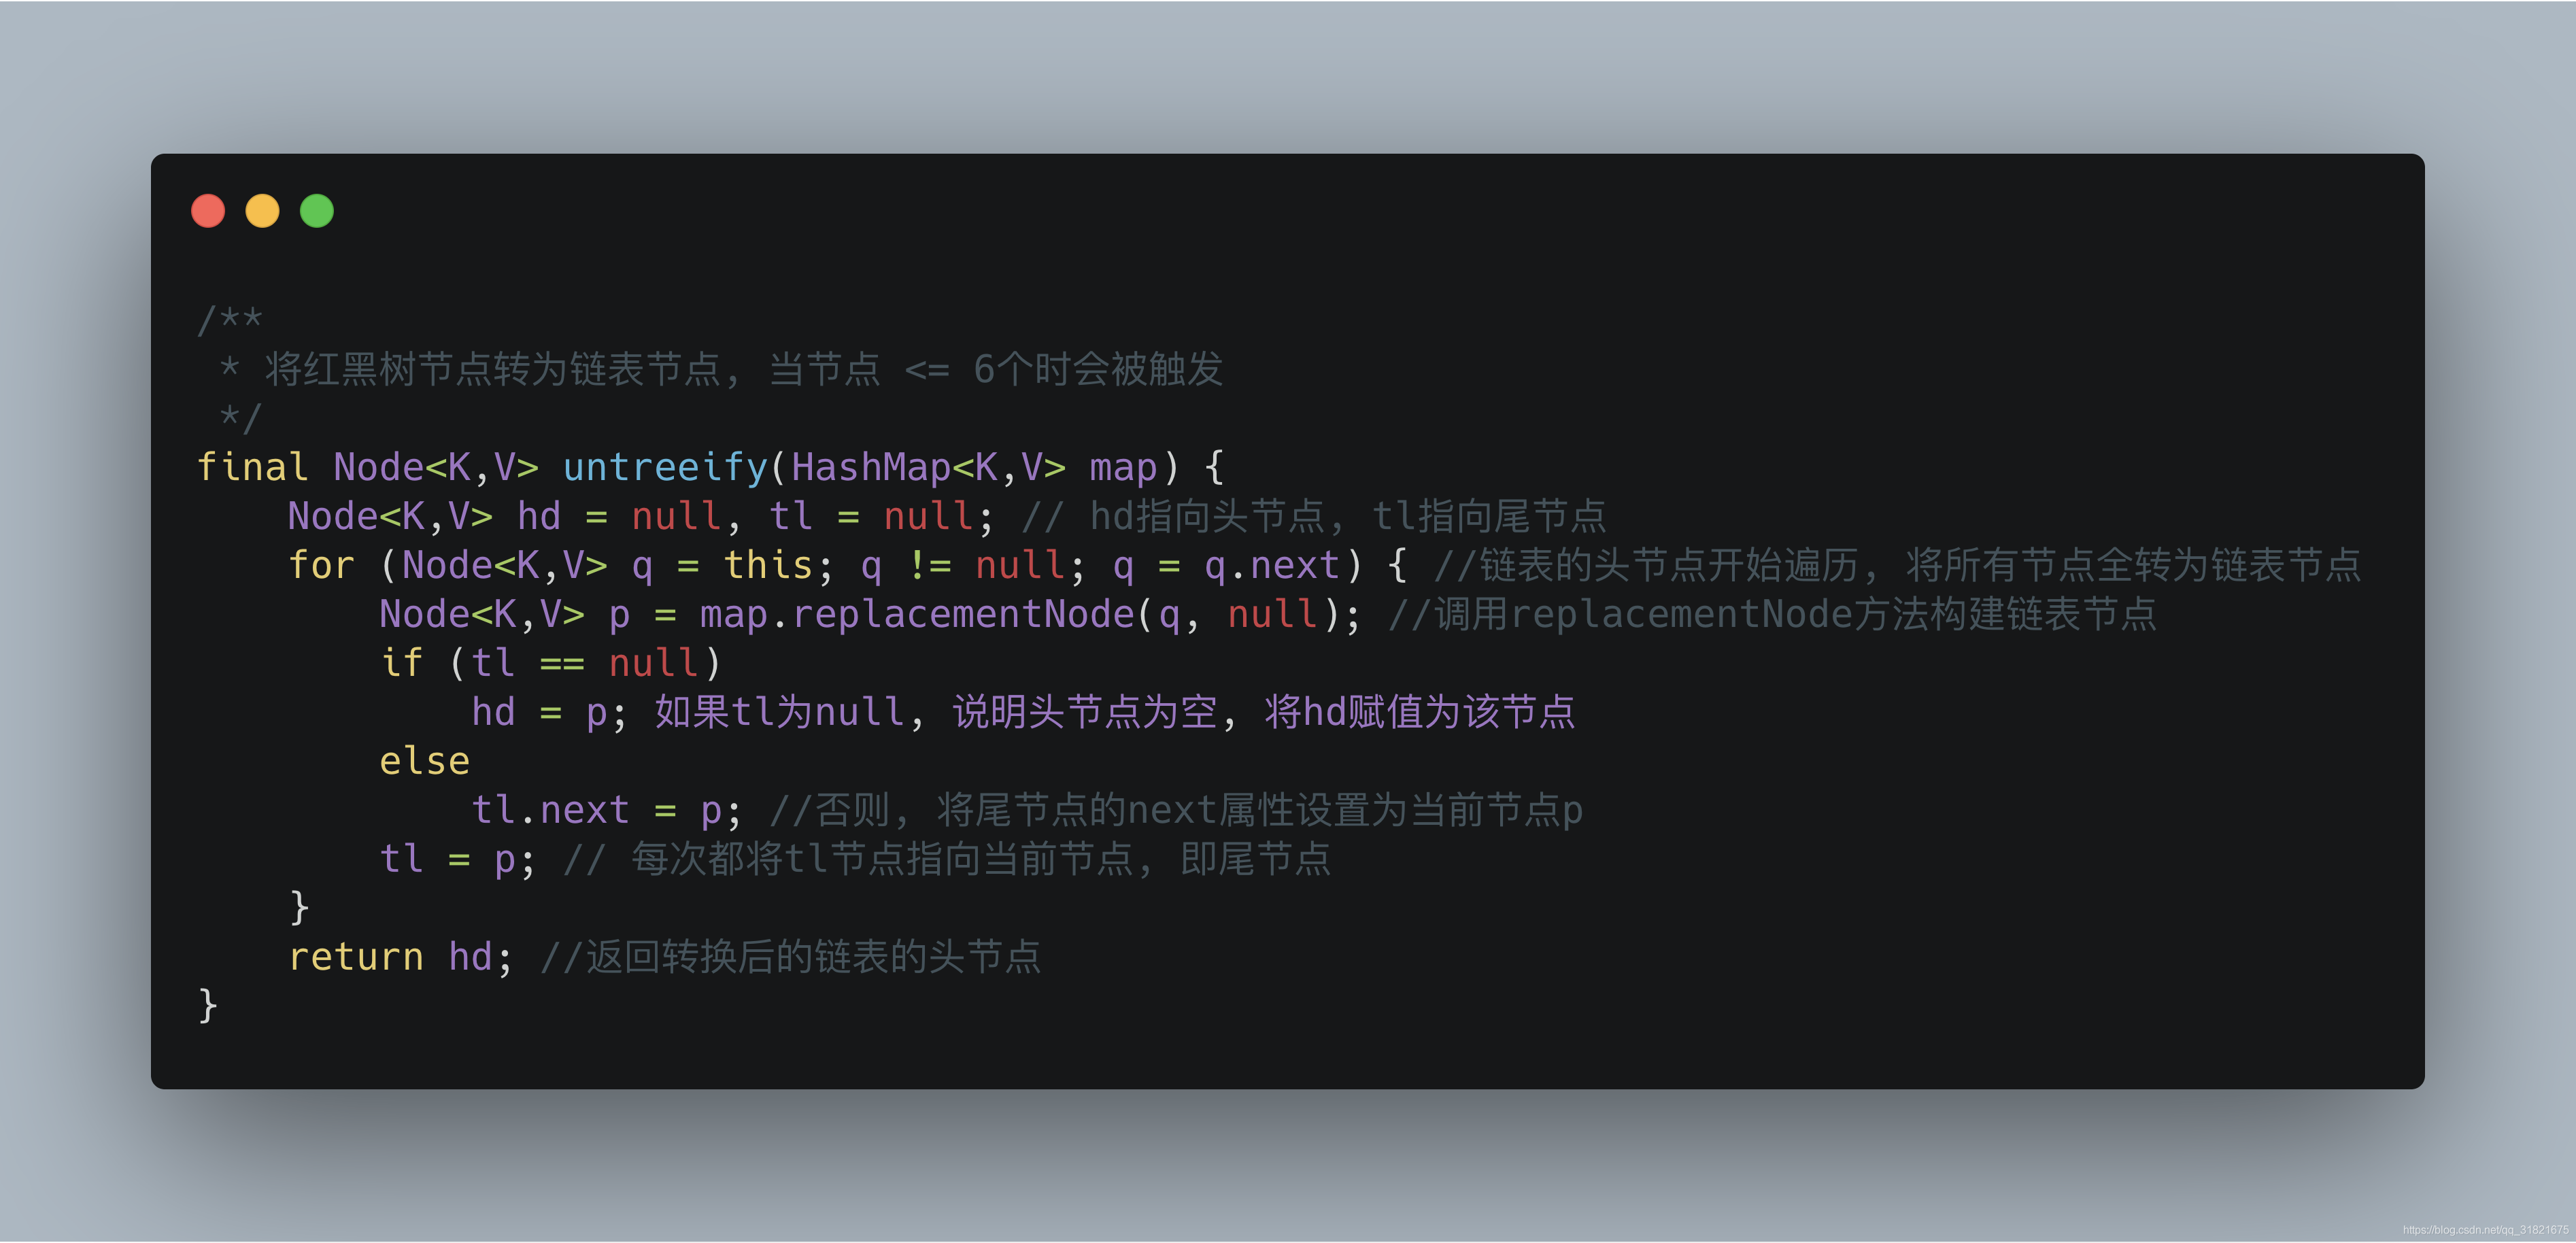
untreeify
红黑树退化成链表
balanceDeletion
关于这个问题可以直接看博主以前写的红黑叔添加跟删除RBT
JDK7死环问题
JDK7对旧table数据重定位到新table的函数transfer如下,其中重点关注部分以标出。
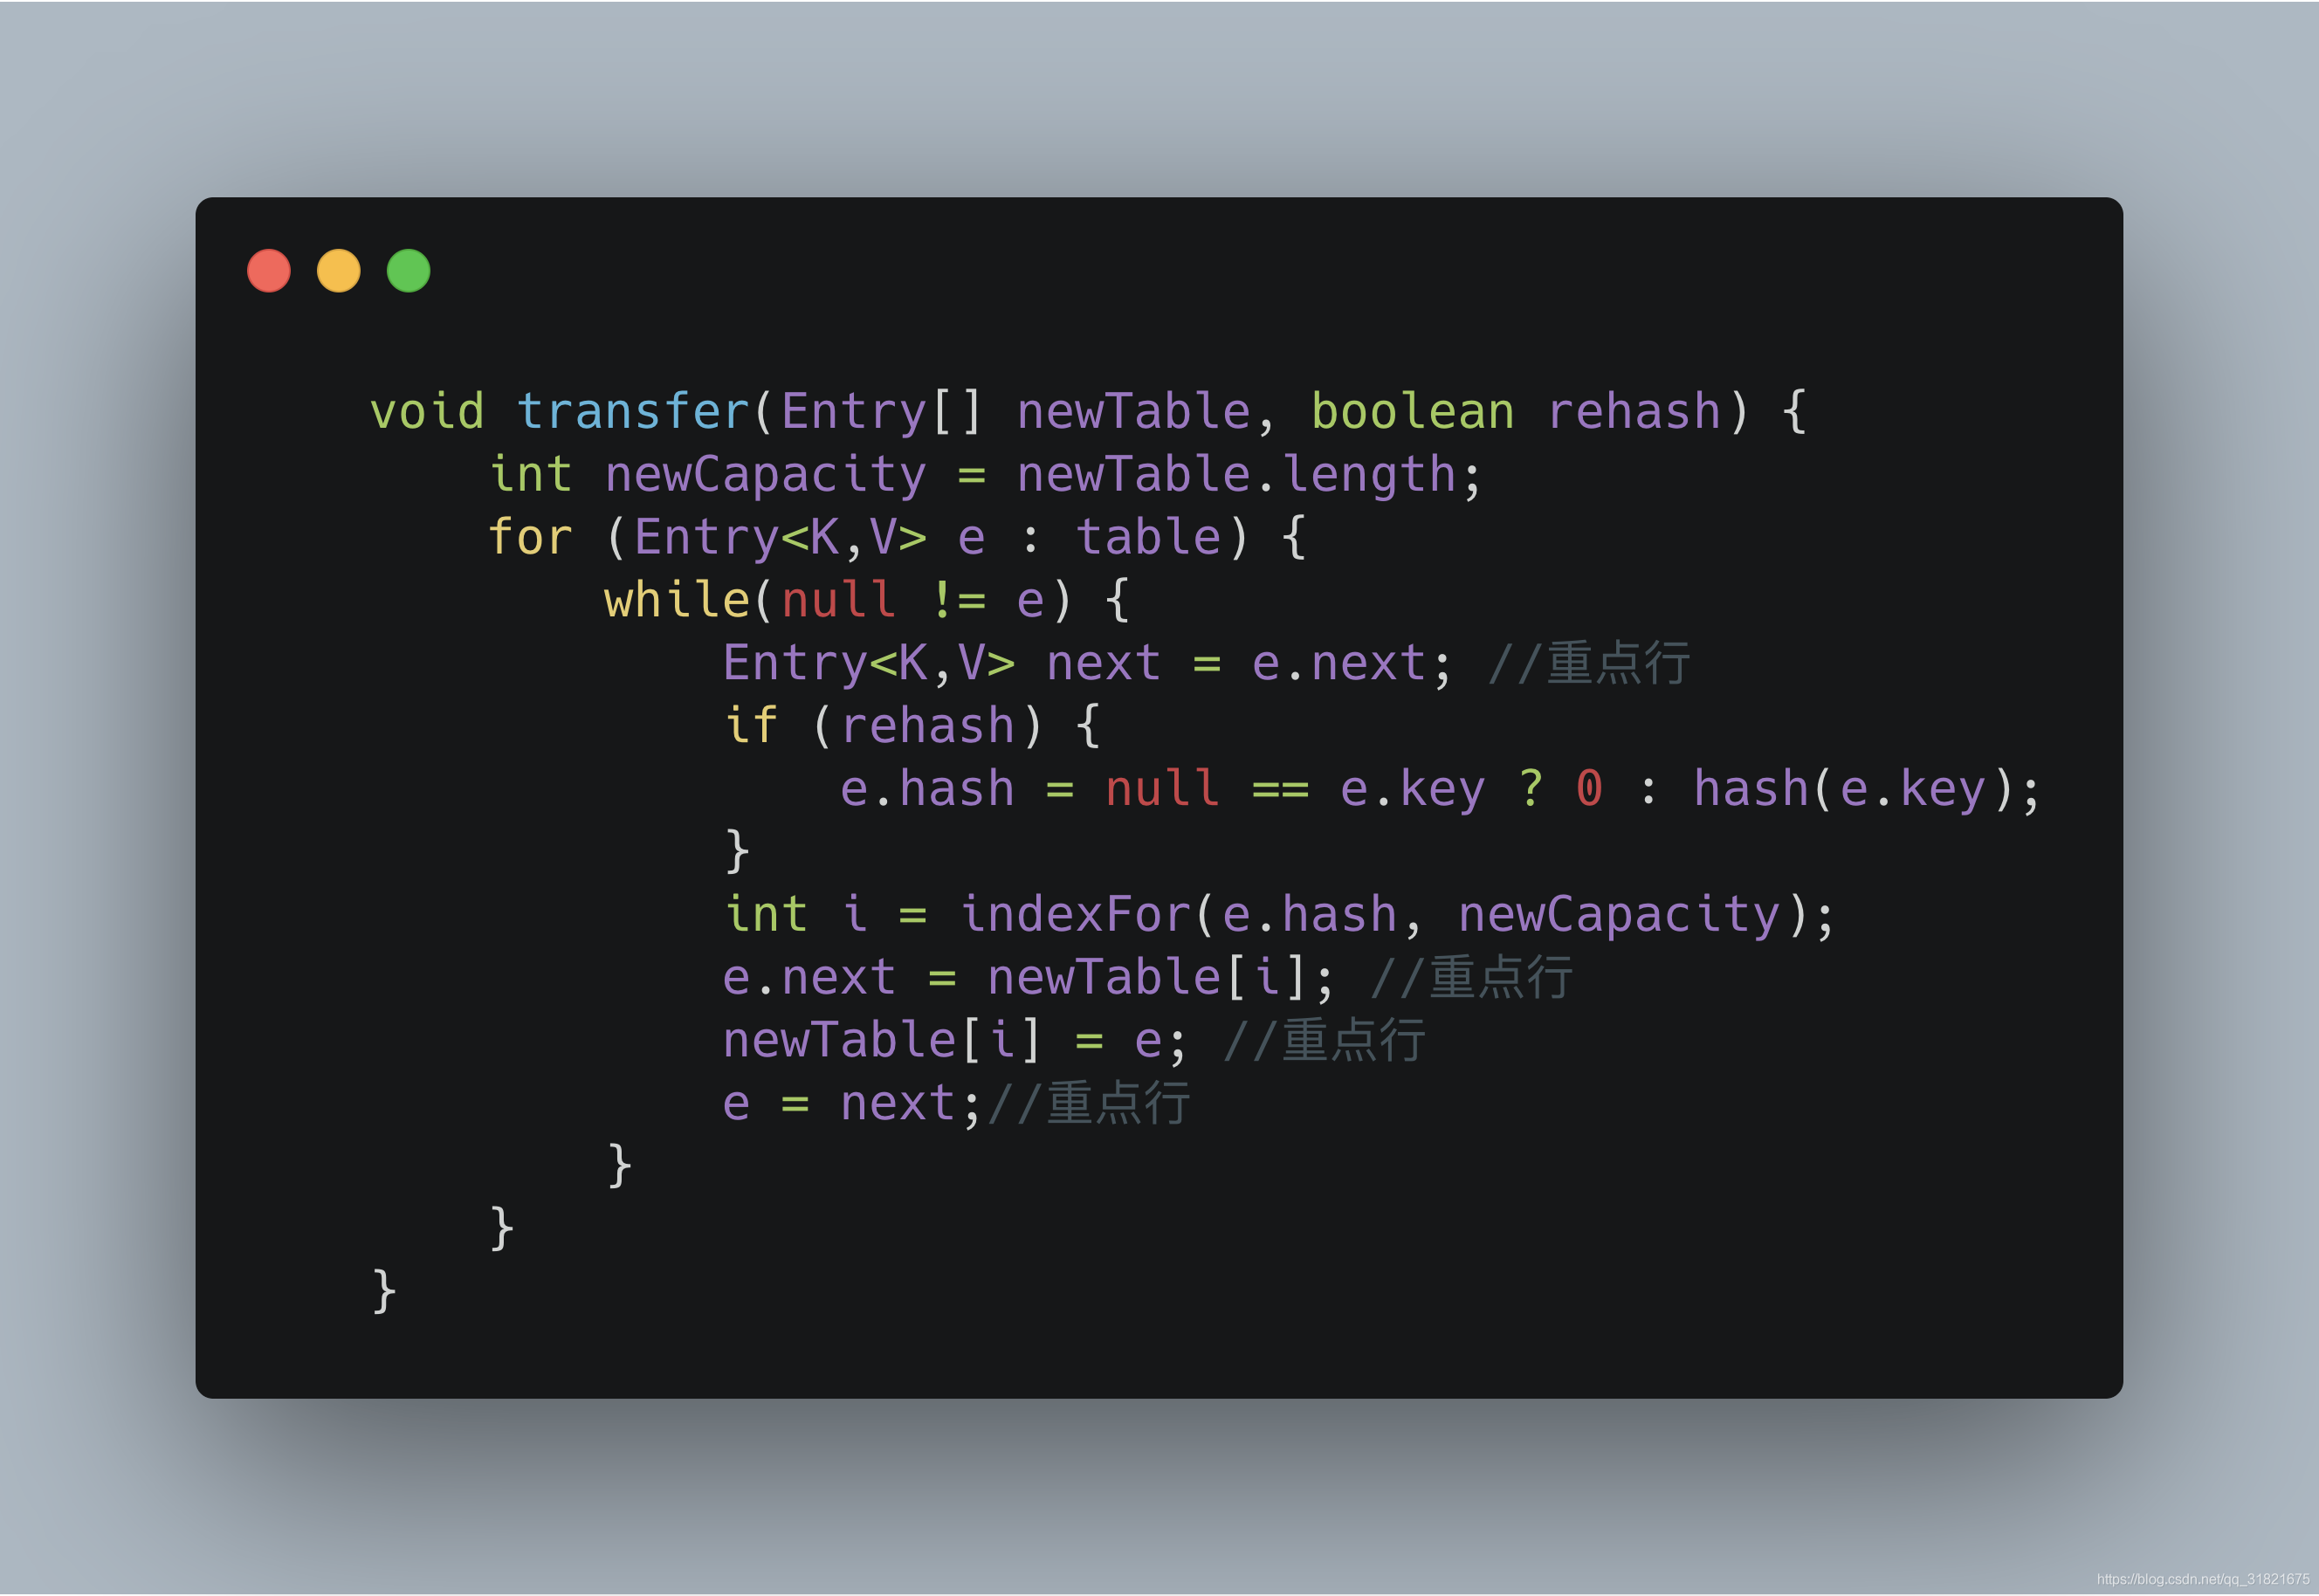
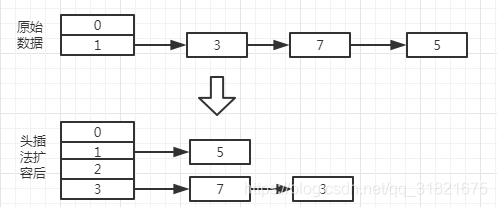
- 头插法正常情况下:
- 并发情况下
线程1只执行了Entry<K,V> next = e.next就被挂起了,而线程2正常执行完毕,结果图如下: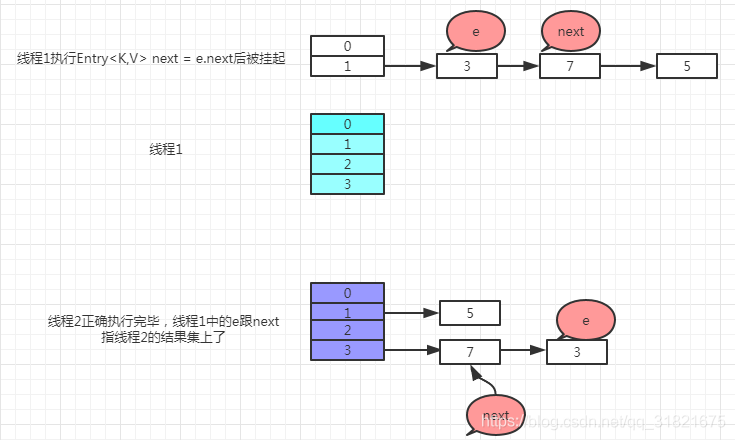
线程1接着下面继续执行: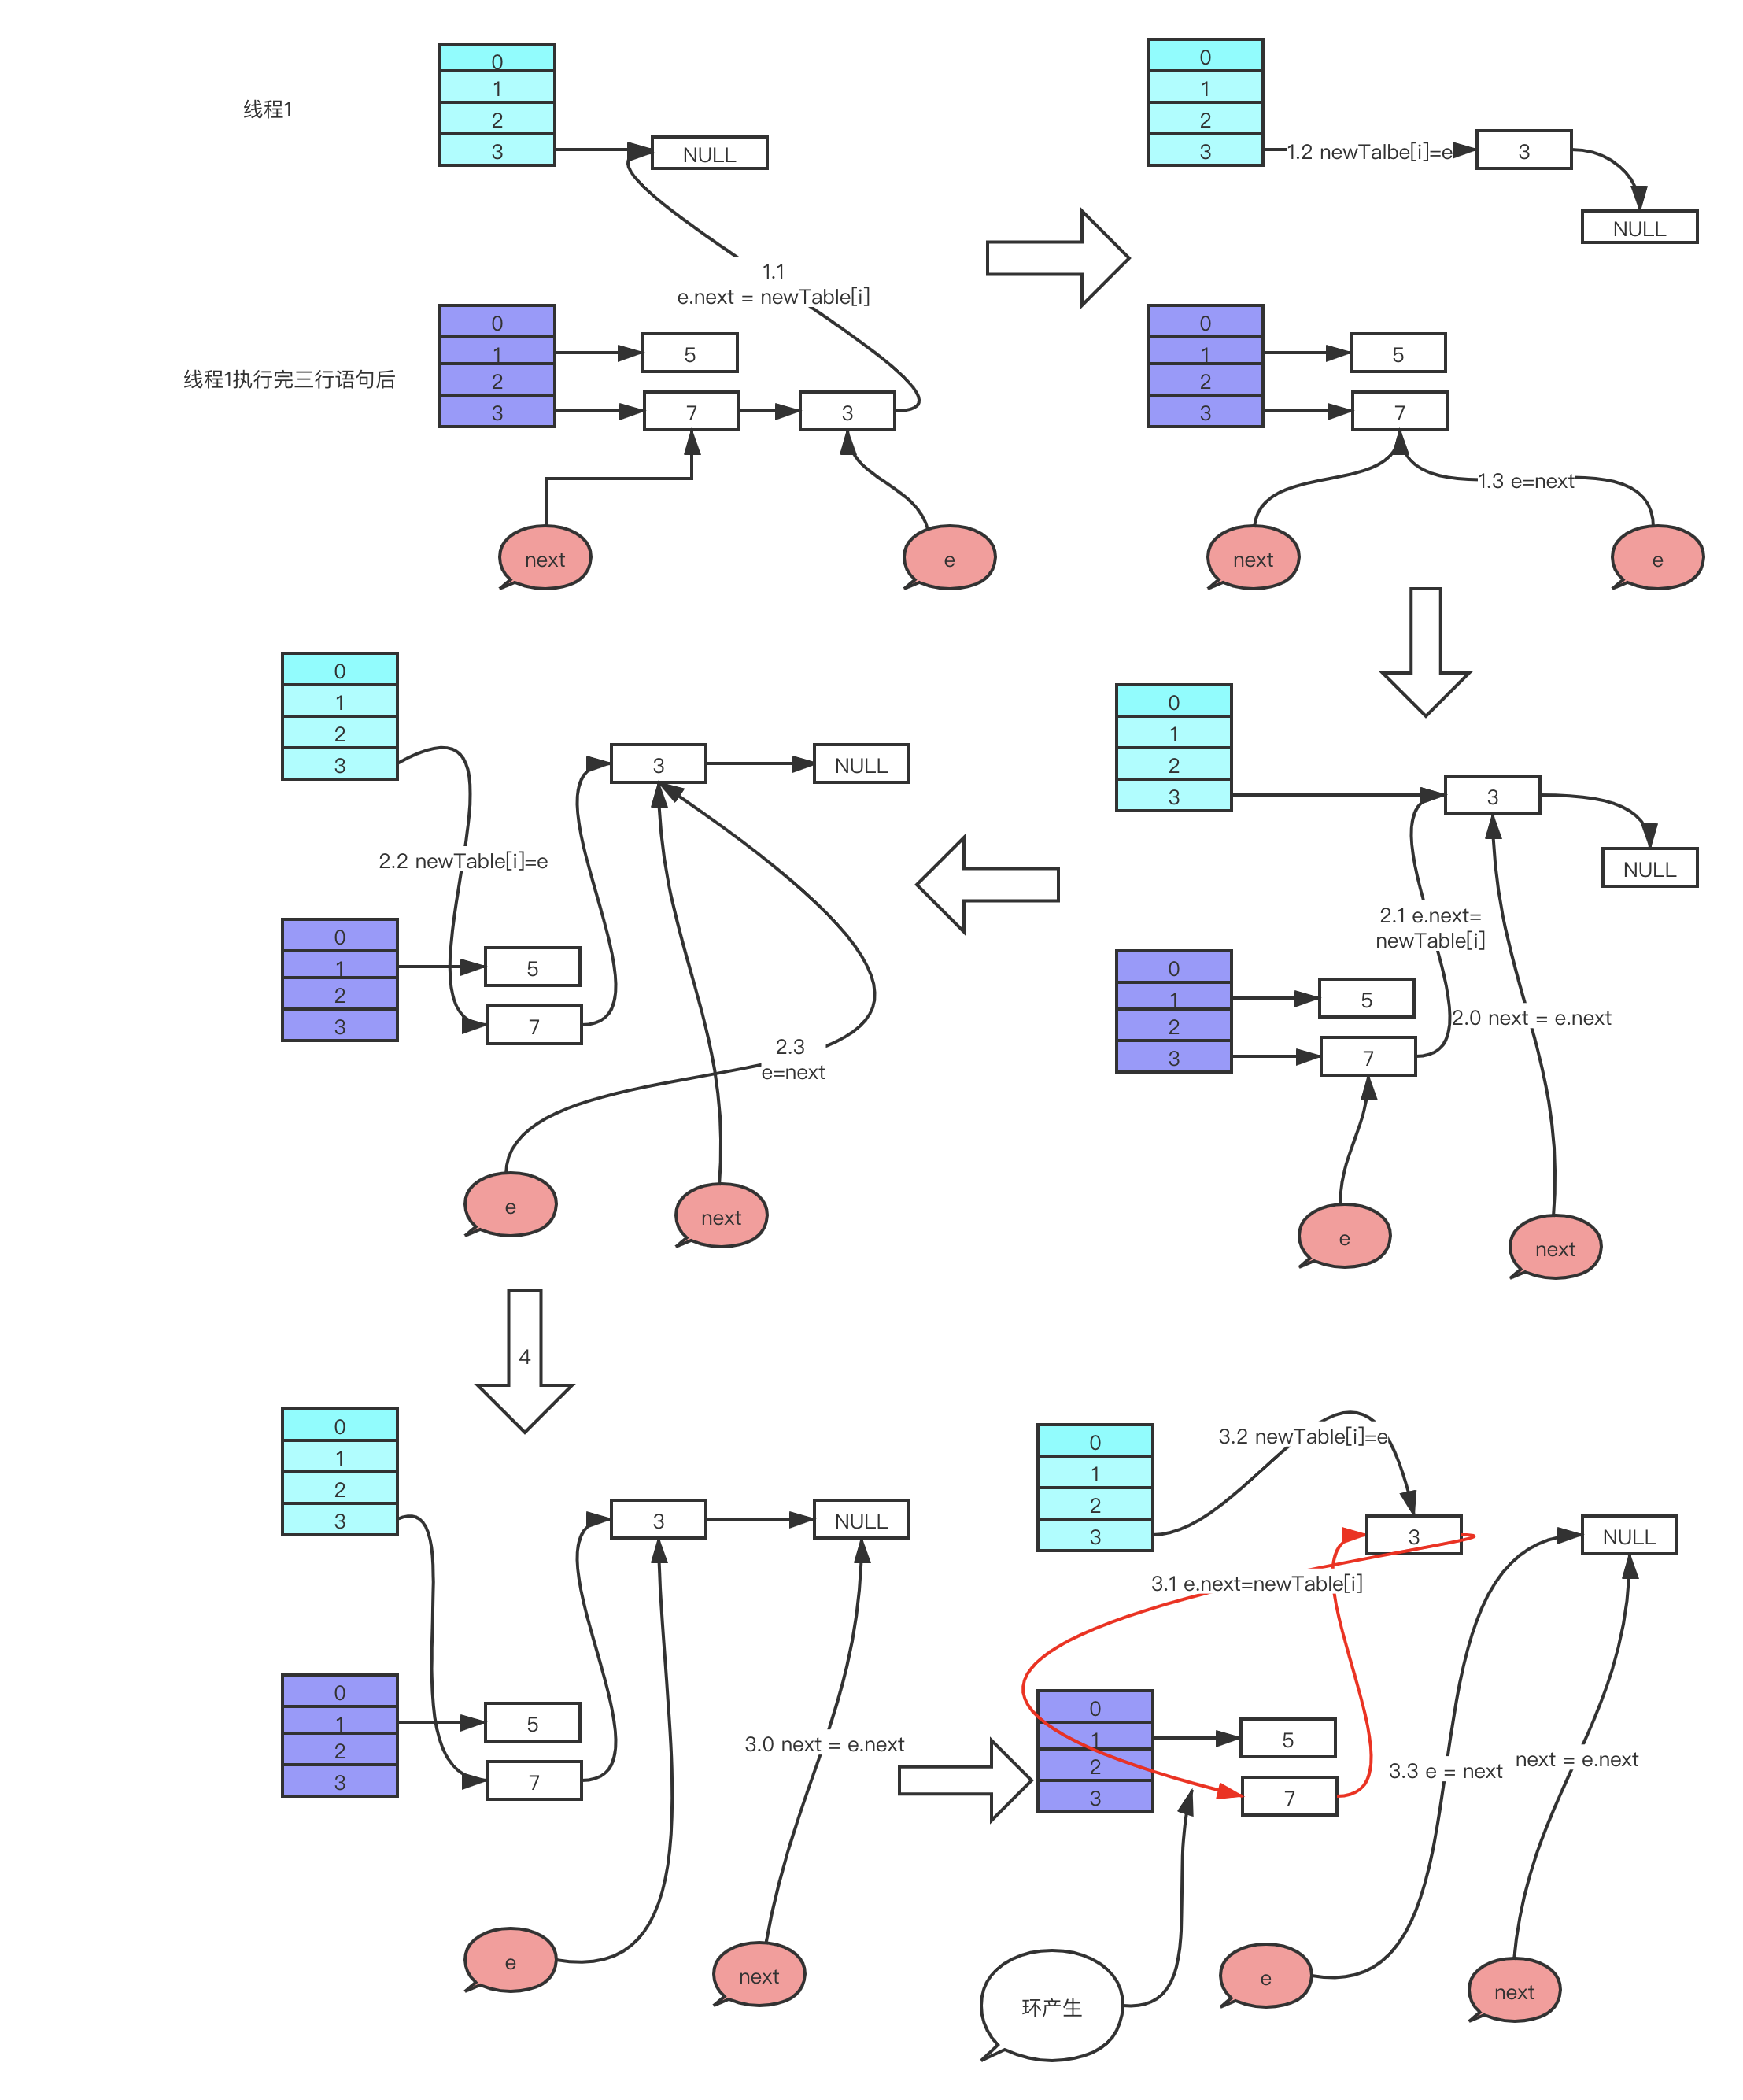
通过逐步分析跟绘图可以知道 会有环产生。
7vs8
- 7中找
Hash用了4次,8中只用了1次。- 7 = 数组 + 链表,8 = 数组 + 链表 + 红黑树
- 7中是头插法,多线程容易造成环,8中是尾插法。
- 7的扩容是全部数据重新定位,8中是位置不变+ 移动旧size大小来实现更好些。
- 7是先判断是否要扩容再插入,8中是先插入再看是否要扩容。
HashMap不管78都是线程不安全的,多线程情况下记得用ConcurrentHashmap。ConcurrentHashmap下篇文章说。
HashMap(数组+链表+红黑树)即散列表
HashMap 根据键的 hashCode 值存储数据,大多数情况下可以直接定位到它的值,因而具有很快的访问速度,但遍历顺序却是不确定的。 HashMap 最多只允许一条记录的键为 null,允许多条记录的值为 null。HashMap 非线程安全,即任一时刻可以有多个线程同时写 HashMap,可能会导致数据的不一致。如果需要满足线程安全,可以用 Collections 的 synchronizedMap 方法使HashMap 具有线程安全的能力,或者使用 ConcurrentHashMap。
JAVA1.7 实现
大方向上,HashMap 里面是一个数组,然后数组中每个元素是一个单向链表。上图中,每个绿色的实体是嵌套类 Entry 的实例,Entry 包含四个属性:key, value, hash 值和用于单向链表的 next。
- capacity:当前数组容量,始终保持 2^n,可以扩容,扩容后数组大小为当前的 2 倍。
- loadFactor:负载因子,默认为 0.75。
- threshold:扩容的阈值,等于 capacity * loadFactor
JAVA1.8 实现
Java8 对 HashMap 进行了一些修改,最大的不同就是利用了红黑树,所以其由 数组+链表+红黑树组成。
根据 Java1.7 HashMap 的介绍,我们知道,查找的时候,根据 hash 值我们能够快速定位到数组的具体下标,但是之后的话,需要顺着链表一个个比较下去才能找到我们需要的,时间复杂度取决于链表的长度,为 O(n)。为了降低这部分的开销,在 Java8 中,当链表中的元素超过了 8 个以后,会将链表转换为红黑树,在这些位置进行查找的时候可以降低时间复杂度为 O(logN)。
HashMap1.8关键参数
/**
 * 默认的hash table长度
 */
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16

/**
 * 最大的hash table长度
 */
static final int MAXIMUM_CAPACITY = 1 << 30;

/**
 * 默认负载因子
 */
static final float DEFAULT_LOAD_FACTOR = 0.75f;

/**
 * 当一个hash桶中的链表个数大于8时 转成红黑树
 */
static final int TREEIFY_THRESHOLD = 8;

/**
 * 当一个hash桶中的红黑树个数小于6时 转成链表
 */
static final int UNTREEIFY_THRESHOLD = 6;

/**
 * 只有当hash node数组中的元素个数超过64位时,才会允许超过8位长度的链表转成红黑树
 * 否则是直接扩容hash表
 */
static final int MIN_TREEIFY_CAPACITY = 64;
//存储元素的数组
transient Node<k,v>[] table;
//HashMap迭代器
transient Set<map.entry<k,v>> entrySet;
//存放元素的个数
transient int size;
//被修改的次数fast-fail机制
transient int modCount;
//跨容临界值 当实际大小(容量*负载因子)超过临界值时,会进行扩容
int threshold;
//实际负载因子
final float loadFactor;
Node内部类
static class Node<K,V> implements Map.Entry<K,V> {
    final int hash;//hash值
    final K key;//key
    V value;//value
    Node<K,V> next;//一个桶中的链表相同hash值下一个元素

    Node(int hash, K key, V value, Node<K,V> next) {
        this.hash = hash;
        this.key = key;
        this.value = value;
        this.next = next;
    }

    public final K getKey()        { return key; }
    public final V getValue()      { return value; }
    public final String toString() { return key + "=" + value; }

    public final int hashCode() {
        return Objects.hashCode(key) ^ Objects.hashCode(value);
    }

    public final V setValue(V newValue) {
        V oldValue = value;
        value = newValue;
        return oldValue;
    }

    public final boolean equals(Object o) {
        if (o == this)
            return true;
        if (o instanceof Map.Entry) {
            Map.Entry<?,?> e = (Map.Entry<?,?>)o;
            if (Objects.equals(key, e.getKey()) &&
                Objects.equals(value, e.getValue()))
                return true;
        }
        return false;
    }
}
红黑树,链表长度超过8时转成红黑树,红黑树个数小于6时转成链表
static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> {
    TreeNode<K,V> parent;  // red-black tree links
    TreeNode<K,V> left;
    TreeNode<K,V> right;
    TreeNode<K,V> prev;    // needed to unlink next upon deletion
    boolean red;
    TreeNode(int hash, K key, V val, Node<K,V> next) {
        super(hash, key, val, next);
    }

    /**
     * Returns root of tree containing this node.
     */
    final TreeNode<K,V> root() {
        for (TreeNode<K,V> r = this, p;;) {
            if ((p = r.parent) == null)
                return r;
            r = p;
        }
    }
}
构造方法:HashMap的构造方法有四个,可以从构造方法看出,HashMap是懒加载,只有第一次使用时才初始化
/**
 * 指定初始大小和负载因子的构造方法
 */
public HashMap(int initialCapacity, float loadFactor) {
    //判断指定的初始大小
    if (initialCapacity < 0)
        throw new IllegalArgumentException("Illegal initial capacity: " +
                                           initialCapacity);
    if (initialCapacity > MAXIMUM_CAPACITY)
        initialCapacity = MAXIMUM_CAPACITY;
    //判断负载因子
    if (loadFactor <= 0 || Float.isNaN(loadFactor))
        throw new IllegalArgumentException("Illegal load factor: " +
                                           loadFactor);
    //设置新的负载因子
    this.loadFactor = loadFactor;
    //设置新的扩容临界值
    this.threshold = tableSizeFor(initialCapacity);
}

/**
 * 指定初始大小
 */
public HashMap(int initialCapacity) {
    this(initialCapacity, DEFAULT_LOAD_FACTOR);
}

/**
 * 无参构造方法,默认长度16  负载因子0.75
 */
public HashMap() {
    this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted
}

/**
 * 用其他HashMap初始化
 */
public HashMap(Map<? extends K, ? extends V> m) {
    this.loadFactor = DEFAULT_LOAD_FACTOR;
    putMapEntries(m, false);
}
主要方法
put方法
public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}
//确定hash桶索引位置
static final int hash(Object key) {
     int h;
     // h = key.hashCode() 为第一步 取hashCode值
     // h ^ (h >>> 16)  为第二步 高位参与运算
     return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
boolean evict) {
//判断table是否为空,如果是空的就创建一个table,并获取他的长度
Node<K,V>[] tab; Node<K,V> p; int n, i;
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
//如果计算出来的索引位置之前没有放过数据,就创建一个Node放入
if ((p = tab[i = (n - 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);
else {
//进入这里说明索引位置已经放入过数据了 有Hash冲突
Node<K,V> e; K k;
//判断put的数据和之前的数据是否重复
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k)))) //key的地址或key的equals()只要有一个相等就认为key重复了,就直接覆盖原来key的value
e = p;
//判断是否是红黑树,如果是红黑树就遍历树中的key 判断hash值 更新或插入树中
else if (p instanceof TreeNode)
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
else {
//如果不是红黑树,就遍历每个节点,判断链表长度是否大于8,如果大于就转换为红黑树
for (int binCount = 0; ; ++binCount) {
if ((e = p.next) == null) {
//将当前元素插入链表的尾部
p.next = newNode(hash, key, value, null);
if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
//treeifyBin首先会判断HashMap长度是否已经到64
//如果到了会进行转换红黑树的操作
//如果长度未到则进行resize() 跨容table操作
treeifyBin(tab, hash);
break;
}
//判断索引每个元素的key是否可要插入的key相同,如果相同就直接覆盖
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
break;
p = e;
}
}
//如果e不是null,说明没有迭代到最后就跳出了循环,
//说明链表中有相同的key,因此只需要将value覆盖,并将oldValue返回即可
if (e != null) { // existing mapping for key
V oldValue = e.value;
if (!onlyIfAbsent || oldValue == null)
e.value = value;
afterNodeAccess(e);
//返回老的值
return oldValue;
}
}
//说明没有key相同,因此要插入一个key-value,并记录内部结构变化次数
++modCount;
//如果当前大小大于临界值,临界值原本是初始容量*0.75
if (++size > threshold)
//跨容两倍 每次跨容的长度都是2的N次方
resize();
afterNodeInsertion(evict);
return null;
}跨容方法
final Node<K,V>[] resize() {
    Node<K,V>[] oldTab = table;
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    int oldThr = threshold;
    int newCap, newThr = 0;
    //判断旧表的长度不是空
    if (oldCap > 0) {
        //如果旧表长度已经超出最大长度 则直接返回旧表
        if (oldCap >= MAXIMUM_CAPACITY) {
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }
        //把新表的长度设置为旧表长度的两倍,newCap=oldCap << 1(2*oldCap)
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                 oldCap >= DEFAULT_INITIAL_CAPACITY)
            /*把新表的临界值设置为旧表临界值的两倍,newThr=oldThr*2*/
            newThr = oldThr << 1; // double threshold
    }
    //如果旧表的长度的是0,就是说第一次初始化表
    //并且初始化Hash数组和临界值
    else if (oldThr > 0) // initial capacity was placed in threshold
        newCap = oldThr;
    else {               // zero initial threshold signifies using defaults
        newCap = DEFAULT_INITIAL_CAPACITY;
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }
    //如果新临界值为0  重新计算新临界值
    if (newThr == 0) {
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                  (int)ft : Integer.MAX_VALUE);
    }
    //设置新node数组的临界值
    threshold = newThr;
    @SuppressWarnings({"rawtypes","unchecked"})
    //下面开始构造新表,初始化表中的数据
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
    //把新表赋值给table
    table = newTab;
    //原表不是空要把原表中数据移动到新表中
    if (oldTab != null) {
        //遍历原来的旧表
        for (int j = 0; j < oldCap; ++j) {
            Node<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;
                //说明这个node没有链表直接放在新表的e.hash & (newCap - 1)位置
                if (e.next == null)
                    newTab[e.hash & (newCap - 1)] = e;
                //处理旧表中红黑树的数据放入新表的各桶索引位置中
                //如果到新表中长度还是超过8 则继续转换成红黑树
                //如果到新表中的长度低于6 则转换成链表
                else if (e instanceof TreeNode)
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                else { // preserve order
                    //如果e后边有链表,到这里表示e后面带着个单链表,需要遍历单链表,将链表中的元素重新

                    //新计算在新表的位置,并进行搬运
                    Node<K,V> loHead = null, loTail = null;
                    Node<K,V> hiHead = null, hiTail = null;
                    Node<K,V> next;

                    do {
                        //记录下一个结点
                        next = e.next;
                        //新表是旧表的两倍容量,实例上就把单链表拆分为两队,
                        //e.hash&oldCap为偶数一队,e.hash&oldCap为奇数一队
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                loTail.next = e;
                            loTail = e;
                        }
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);
                    //偶数lo队不为null,放在新表原位置
                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    //奇数hi队不为null,放在新表j+oldCap位置
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
get方法
public V get(Object key) {
    Node<K,V> e;
    //根据key计算hash桶的索引位置
    return (e = getNode(hash(key), key)) == null ? null : e.value;
}

final Node<K,V> getNode(int hash, Object key) {
        Node<K,V>[] tab; Node<K,V> first, e; int n; K k;
    	//找到插入的第一个Node,方法是hash值和n-1相与,tab[(n - 1) & hash]
    	//也就是说在一条链上的hash值相同的
        if ((tab = table) != null && (n = tab.length) > 0 &&
            (first = tab[(n - 1) & hash]) != null) {
            //检查第一个Node是否是要找的Node
            //hash值要相同,key值要相同
            if (first.hash == hash && // always check first node
                ((k = first.key) == key || (key != null && key.equals(k))))
                return first;
            //检查后续的Node
            if ((e = first.next) != null) {
                //如果是红黑树 则遍历红黑树得到想要的Node
                if (first instanceof TreeNode)
                    return ((TreeNode<K,V>)first).getTreeNode(hash, key);
                //遍历后面的链表,找到key值和hash值都相同的Node
                do {
                    if (e.hash == hash &&
                        ((k = e.key) == key || (key != null && key.equals(k))))
                        return e;
                } while ((e = e.next) != null);
            }
        }
        return null;
    }
ConcurrentHashMap
HashMap是线程不安全的,因此在老版本JDK中提供了HashTable来实现多线程级别的,改变之处重要有以下几点。
HashTable的put,get,remove等方法是通过synchronized来修饰保证其线程安全性的。HashTable是 不允许key跟value为null的。- 问题是
synchronized是个关键字级别的重量锁,在get数据的时候任何写入操作都不允许。相对来说性能不好。因此目前主要用的ConcurrentHashMap来保证线程安全性。
ConcurrentHashMap主要分为JDK<=7跟JDK>=8的两个版本,ConcurrentHashMap的空间利用率更低一般只有10%~20%,接下来分别介绍。
JDK7
先宏观说下JDK7中的大致组成,ConcurrentHashMap由Segment数组结构和HashEntry数组组成。Segment是一种可重入锁,是一种数组和链表的结构,一个Segment中包含一个HashEntry数组,每个HashEntry又是一个链表结构。正是通过Segment分段锁,ConcurrentHashMap实现了高效率的并发。缺点是并发程度是有segment数组来决定的,并发度一旦初始化无法扩容。先绘制个ConcurrentHashMap的形象直观图。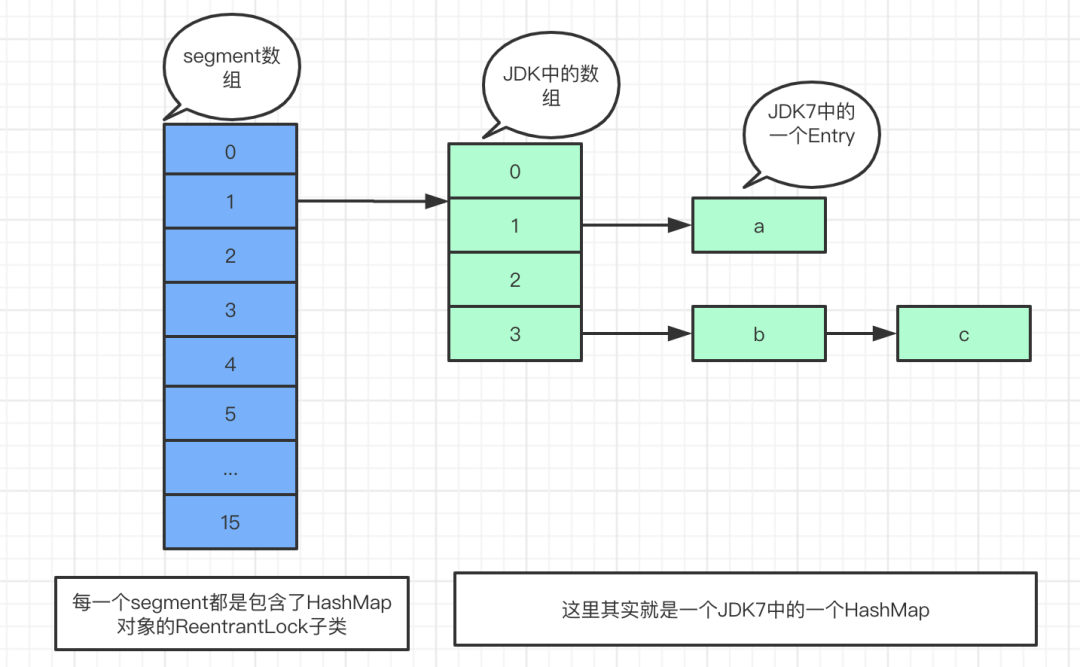 要想理解
currentHashMap,可以简单的理解为将数据**「分表分库」**。ConcurrentHashMap是由 Segment 数组 结构和HashEntry 数组 结构组成。
- Segment 是一种可重入锁
ReentrantLock的子类 ,在ConcurrentHashMap里扮演锁的角色,HashEntry则用于存储键值对数据。 ConcurrentHashMap里包含一个Segment数组来实现锁分离,Segment的结构和HashMap类似,一个Segment里包含一个HashEntry数组,每个HashEntry是一个链表结构的元素, 每个Segment守护者一个HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得它对应的Segment锁。
- 我们先看下segment类:
static final class Segment<K,V> extends ReentrantLock implements Serializable {
     transient volatile HashEntry<K,V>[] table; //包含一个HashMap 可以理解为
}可以理解为我们的每个segment都是实现了Lock功能的HashMap。如果我们同时有多个segment形成了segment数组那我们就可以实现并发咯。
我们看下currentHashMap的构造函数,先总结几点。
1. 每一个segment里面包含的table(HashEntry数组)初始化大小也一定是2的次幂
2. 这里设置了若干个用于位计算的参数。
3. initialCapacity:初始容量大小 ,默认16。
4. loadFactor: 扩容因子,默认0.75,当一个Segment存储的元素数量大于initialCapacity* loadFactor时,该Segment会进行一次扩容。
5. concurrencyLevel:并发度,默认16。并发度可以理解为程序运行时能够**「同时更新」**ConccurentHashMap且不产生锁竞争的最大线程数,实际上就是ConcurrentHashMap中的**分段锁**个数,即Segment[]的数组长度。如果并发度设置的过小,会带来严重的锁竞争问题;如果并发度设置的过大,原本位于同一个Segment内的访问会扩散到不同的Segment中,CPU cache命中率会下降,从而引起程序性能下降。
6. segment的数组大小最终一定是2的次幂
构造函数详解:
//initialCapacity 是我们保存所以KV数据的初始值
   //loadFactor这个就是HashMap的负载因子
   // 我们segment数组的初始化大小
      @SuppressWarnings("unchecked")
       public ConcurrentHashMap(int initialCapacity,
                                float loadFactor, int concurrencyLevel) {
           if (!(loadFactor > 0) || initialCapacity < 0 || concurrencyLevel <= 0)
               throw new IllegalArgumentException();
           if (concurrencyLevel > MAX_SEGMENTS) // 最大允许segment的个数,不能超过 1< 24
               concurrencyLevel = MAX_SEGMENTS;
           int sshift = 0; // 类似扰动函数
           int ssize = 1;
           while (ssize < concurrencyLevel) {
               ++sshift;
               ssize <<= 1; // 确保segment一定是2次幂
           }
           this.segmentShift = 32 - sshift;
           //有点类似与扰动函数,跟下面的参数配合使用实现 当前元素落到那个segment上面。
           this.segmentMask = ssize - 1; // 为了 取模 专用
           if (initialCapacity > MAXIMUM_CAPACITY) //不能大于 1< 30
               initialCapacity = MAXIMUM_CAPACITY;

           int c = initialCapacity / ssize; //总的数组大小 被 segment 分散后 需要多少个table
           if (c * ssize < initialCapacity)
               ++c; //确保向上取值
           int cap = MIN_SEGMENT_TABLE_CAPACITY;
           // 每个table初始化大小为2
           while (cap < c) // 单独的一个segment[i] 对应的table 容量大小。
               cap <<= 1;
           // 将table的容量初始化为2的次幂
           Segment<K,V> s0 =
               new Segment<K,V>(loadFactor, (int)(cap * loadFactor), (HashEntry<K,V>[])new HashEntry[cap]);
               // 负载因子,阈值,每个segment的初始化大小。跟hashmap 初始值类似。
               // 并且segment的初始化是懒加载模式,刚开始只有一个s0,其余的在需要的时候才会增加。
           Segment<K,V>[] ss = (Segment<K,V>[])new Segment[ssize];
           UNSAFE.putOrderedObject(ss, SBASE, s0); // ordered write of segments[0]
           this.segments = ss;
}- hash 不管是我们的get操作还是put操作要需要通过hash来对数据进行定位。
//  整体思想就是通过多次不同方式的位运算来努力将数据均匀的分不到目标table中,都是些扰动函数
   private int hash(Object k) {
       int h = hashSeed;
       if ((0 != h) && (k instanceof String)) {
           return sun.misc.Hashing.stringHash32((String) k);
       }
       h ^= k.hashCode();
       // single-word Wang/Jenkins hash.
       h += (h <<  15) ^ 0xffffcd7d;
       h ^= (h >>> 10);
       h += (h <<   3);
       h ^= (h >>>  6);
       h += (h <<   2) + (h << 14);
       return h ^ (h >>> 16);
}- get 相对来说比较简单,无非就是通过
hash找到对应的segment,继续通过hash找到对应的table,然后就是遍历这个链表看是否可以找到,并且要注意get的时候是没有加锁的。
public V get(Object key) {
       Segment<K,V> s;
       HashEntry<K,V>[] tab;
       int h = hash(key); // JDK7中标准的hash值获取算法
       long u = (((h >>> segmentShift) & segmentMask) << SSHIFT) + SBASE; // hash值如何映射到对应的segment上
       if ((s = (Segment<K,V>)UNSAFE.getObjectVolatile(segments, u)) != null && (tab = s.table) != null) {
           //  无非就是获得hash值对应的segment 是否存在,
           for (HashEntry<K,V> e = (HashEntry<K,V>) UNSAFE.getObjectVolatile
                    (tab, ((long)(((tab.length - 1) & h)) << TSHIFT) + TBASE);
                e != null; e = e.next) {
               // 看下这个hash值对应的是segment(HashEntry)中的具体位置。然后遍历查询该链表
               K k;
               if ((k = e.key)  key || (e.hash  h && key.equals(k)))
                   return e.value;
           }
       }
       return null;
}- put 相同的思路,先找到
hash值对应的segment位置,然后看该segment位置是否初始化了(因为segment是懒加载模式)。选择性初始化,最终执行put操作。
@SuppressWarnings("unchecked")
   public V put(K key, V value) {
       Segment<K,V> s;
       if (value  null)
           throw new NullPointerException();
       int hash = hash(key);// 还是获得最终hash值
       int j = (hash >>> segmentShift) & segmentMask; // hash值位操作对应的segment数组位置
       if ((s = (Segment<K,V>)UNSAFE.getObject
            (segments, (j << SSHIFT) + SBASE))  null)
           s = ensureSegment(j);
       // 初始化时候因为只有第一个segment,如果落在了其余的segment中 则需要现初始化。
       return s.put(key, hash, value, false);
       // 直接在数据中执行put操作。
}其中put操作基本思路跟HashMap几乎一样,只是在开始跟结束进行了加锁的操作tryLock and unlock,然后JDK7中都是先扩容再添加数据的,并且获得不到锁也会进行自旋的tryLock或者lock阻塞排队进行等待(同时获得锁前提前new出新数据)。
final V put(K key, int hash, V value, boolean onlyIfAbsent) {
    // 在往该 segment 写入前,需要先获取该 segment 的独占锁,获取失败尝试获取自旋锁
    HashEntry<K,V> node = tryLock() ? null :
        scanAndLockForPut(key, hash, value);
    V oldValue;
    try {
        // segment 内部的数组
        HashEntry<K,V>[] tab = table;
        // 利用 hash 值,求应该放置的数组下标
        int index = (tab.length - 1) & hash;
        // first 是数组该位置处的链表的表头
        HashEntry<K,V> first = entryAt(tab, index);

        for (HashEntry<K,V> e = first;;) {
            if (e != null) {
                K k;
                if ((k = e.key)  key ||
                    (e.hash  hash && key.equals(k))) {
                    oldValue = e.value;
                    if (!onlyIfAbsent) {
                        // 覆盖旧值
                        e.value = value;
                        ++modCount;
                    }
                    break;
                }
                // 继续顺着链表走
                e = e.next;
            }
            else {
                // node 是不是 null,这个要看获取锁的过程。没获得锁的线程帮我们创建好了节点,直接头插法
                // 如果不为 null,那就直接将它设置为链表表头;如果是 null,初始化并设置为链表表头。
                if (node != null)
                    node.setNext(first);
                else
                    node = new HashEntry<K,V>(hash, key, value, first);

                int c = count + 1;
                // 如果超过了该 segment 的阈值,这个 segment 需要扩容
                if (c > threshold && tab.length < MAXIMUM_CAPACITY)
                    rehash(node); // 扩容
                else
                    // 没有达到阈值,将 node 放到数组 tab 的 index 位置,
                    // 将新的结点设置成原链表的表头
                    setEntryAt(tab, index, node);
                ++modCount;
                count = c;
                oldValue = null;
                break;
            }
        }
    } finally {
        // 解锁
        unlock();
    }
    return oldValue;
}如果加锁失败了调用scanAndLockForPut,完成查找或新建节点的工作。当获取到锁后直接将该节点加入链表即可,**「提升」**了put操作的性能,这里涉及到自旋。大致过程:
- 在我获取不到锁的时候我进行tryLock,准备好new的数据,同时还有一定的次数限制,还要考虑别的已经获得线程的节点修改该头节点。
private HashEntry<K,V> scanAndLockForPut(K key, int hash, V value) {
    HashEntry<K,V> first = entryForHash(this, hash);
    HashEntry<K,V> e = first;
    HashEntry<K,V> node = null;
    int retries = -1; // negative while locating node

    // 循环获取锁
    while (!tryLock()) {
        HashEntry<K,V> f; // to recheck first below
        if (retries < 0) {
            if (e  null) {
                if (node  null) // speculatively create node
              // 进到这里说明数组该位置的链表是空的,没有任何元素
             // 当然,进到这里的另一个原因是 tryLock() 失败,所以该槽存在并发,不一定是该位置
                    node = new HashEntry<K,V>(hash, key, value, null);
                retries = 0;
            }
            else if (key.equals(e.key))
                retries = 0;
            else
                // 顺着链表往下走
                e = e.next;
        }
    // 重试次数如果超过 MAX_SCAN_RETRIES(单核 1 次多核 64 次),那么不抢了,进入到阻塞队列等待锁
    //    lock() 是阻塞方法,直到获取锁后返回
        else if (++retries > MAX_SCAN_RETRIES) {
            lock();
            break;
        }
        else if ((retries & 1)  0 &&
                 // 进入这里,说明有新的元素进到了链表,并且成为了新的表头
                 // 这边的策略是,重新执行 scanAndLockForPut 方法
                 (f = entryForHash(this, hash)) != first) {
            e = first = f; // re-traverse if entry changed
            retries = -1;
        }
    }
    return node;
}- Size
这个size方法比较有趣,他是先无锁的统计下所有的数据量看下前后两次是否数据一样,如果一样则返回数据,如果不一样则要把全部的segment进行加锁,统计,解锁。并且size方法只是返回一个统计性的数字,因此size谨慎使用哦。
public int size() {
       // Try a few times to get accurate count. On failure due to
       // continuous async changes in table, resort to locking.
       final Segment<K,V>[] segments = this.segments;
       int size;
       boolean overflow; // true if size overflows 32 bits
       long sum;         // sum of modCounts
       long last = 0L;   // previous sum
       int retries = -1; // first iteration isn't retry
       try {
           for (;;) {
               if (retries++  RETRIES_BEFORE_LOCK) {  //  超过2次则全部加锁
                   for (int j = 0; j < segments.length; ++j)
                       ensureSegment(j).lock(); // 直接对全部segment加锁消耗性太大
               }
               sum = 0L;
               size = 0;
               overflow = false;
               for (int j = 0; j < segments.length; ++j) {
                   Segment<K,V> seg = segmentAt(segments, j);
                   if (seg != null) {
                       sum += seg.modCount; // 统计的是modCount,涉及到增删该都会加1
                       int c = seg.count;
                       if (c < 0 || (size += c) < 0)
                           overflow = true;
                   }
               }
               if (sum  last) // 每一个前后的修改次数一样 则认为一样,但凡有一个不一样则直接break。
                   break;
               last = sum;
           }
       } finally {
           if (retries > RETRIES_BEFORE_LOCK) {
               for (int j = 0; j < segments.length; ++j)
                   segmentAt(segments, j).unlock();
           }
       }
       return overflow ? Integer.MAX_VALUE : size;
}- rehash
segment数组初始化后就不可变了,也就是说**「并发性不可变」**,不过segment里的table可以扩容为2倍,该方法没有考虑并发,因为执行该方法之前已经获取了锁。其中JDK7中的rehash思路跟JDK8 中扩容后处理链表的思路一样,个人不过感觉没有8写的精髓好看。
// 方法参数上的 node 是这次扩容后,需要添加到新的数组中的数据。
private void rehash(HashEntry<K,V> node) {
    HashEntry<K,V>[] oldTable = table;
    int oldCapacity = oldTable.length;
    // 2 倍
    int newCapacity = oldCapacity << 1;
    threshold = (int)(newCapacity * loadFactor);
    // 创建新数组
    HashEntry<K,V>[] newTable =
        (HashEntry<K,V>[]) new HashEntry[newCapacity];
    // 新的掩码,如从 16 扩容到 32,那么 sizeMask 为 31,对应二进制 ‘000...00011111’
    int sizeMask = newCapacity - 1;
    // 遍历原数组,将原数组位置 i 处的链表拆分到 新数组位置 i 和 i+oldCap 两个位置
    for (int i = 0; i < oldCapacity ; i++) {
        // e 是链表的第一个元素
        HashEntry<K,V> e = oldTable[i];
        if (e != null) {
            HashEntry<K,V> next = e.next;
            // 计算应该放置在新数组中的位置,
            // 假设原数组长度为 16,e 在 oldTable[3] 处,那么 idx 只可能是 3 或者是 3 + 16 = 19
            int idx = e.hash & sizeMask; // 新位置
            if (next  null)   // 该位置处只有一个元素
                newTable[idx] = e;
            else { // Reuse consecutive sequence at same slot
                // e 是链表表头
                HashEntry<K,V> lastRun = e;
                // idx 是当前链表的头结点 e 的新位置
                int lastIdx = idx;
                // for 循环找到一个 lastRun 结点,这个结点之后的所有元素是将要放到一起的
                for (HashEntry<K,V> last = next;
                     last != null;
                     last = last.next) {
                    int k = last.hash & sizeMask;
                    if (k != lastIdx) {
                        lastIdx = k;
                        lastRun = last;
                    }
                }
                // 将 lastRun 及其之后的所有结点组成的这个链表放到 lastIdx 这个位置
                newTable[lastIdx] = lastRun;
                // 下面的操作是处理 lastRun 之前的结点,
                //这些结点可能分配在另一个链表中,也可能分配到上面的那个链表中
                for (HashEntry<K,V> p = e; p != lastRun; p = p.next) {
                    V v = p.value;
                    int h = p.hash;
                    int k = h & sizeMask;
                    HashEntry<K,V> n = newTable[k];
                    newTable[k] = new HashEntry<K,V>(h, p.key, v, n);
                }
            }
        }
    }
    // 将新来的 node 放到新数组中刚刚的 两个链表之一 的 头部
    int nodeIndex = node.hash & sizeMask; // add the new node
    node.setNext(newTable[nodeIndex]);
    newTable[nodeIndex] = node;
    table = newTable;
}- CAS操作 在JDK7里在
ConcurrentHashMap中通过原子操作sun.misc.Unsafe查找元素、替换元素和设置元素。通过这样的硬件级别获得数据可以保证及时是多线程我也每次获得的数据是最新的。这些原子操作起着非常关键的作用,你可以在所有ConcurrentHashMap的基本功能中看到,随机距离如下:
final void setNext(HashEntry<K,V> n) {
            UNSAFE.putOrderedObject(this, nextOffset, n);
        }
    static final <K,V> HashEntry<K,V> entryAt(HashEntry<K,V>[] tab, int i) {
        return (tab  null) ? null :
            (HashEntry<K,V>) UNSAFE.getObjectVolatile
            (tab, ((long)i << TSHIFT) + TBASE);
    }
   static final <K,V> void setEntryAt(HashEntry<K,V>[] tab, int i,
                                       HashEntry<K,V> e) {
        UNSAFE.putOrderedObject(tab, ((long)i << TSHIFT) + TBASE, e);
    }
- ConcurrentHashMap实现原理是怎么样的或者ConcurrentHashMap如何在保证高并发下线程安全的同时实现了性能提升?
ConcurrentHashMap允许多个修改操作并发进行,其关键在于使用了锁分离技术。它使用了多个锁来控制对hash表的不同部分进行的修改。内部使用段(Segment)来表示这些不同的部分,每个段其实就是一个小的HashTable,只要多个修改操作发生在不同的段上,它们就可以并发进行。
- 在高并发下的情况下如何保证取得的元素是最新的?
用于存储键值对数据的
HashEntry,在设计上它的成员变量value跟next都是volatile类型的,这样就保证别的线程对value值的修改,get方法可以马上看到。
ConcurrentHashMap的弱一致性体现在迭代器,clear和get方法,原因在于没有加锁。
- 比如迭代器在遍历数据的时候是一个Segment一个Segment去遍历的,如果在遍历完一个Segment时正好有一个线程在刚遍历完的Segment上插入数据,就会体现出不一致性。clear也是一样。
- get方法和containsKey方法都是遍历对应索引位上所有节点,都是不加锁来判断的,如果是修改性质的因为可见性的存在可以直接获得最新值,不过如果是新添加值则无法保持一致性。
JDK8
JDK8相比与JDK7主要区别如下:
- 取消了segment数组,直接用table保存数据,锁的粒度更小,减少并发冲突的概率。采用table数组元素作为锁,从而实现了对每一行数据进行加锁,进一步减少并发冲突的概率,并发控制使用Synchronized和CAS来操作。
- 存储数据时采用了数组+ 链表+红黑树的形式。
CurrentHashMap重要参数:
private static final int MAXIMUM_CAPACITY = 1 << 30; // 数组的最大值
private static final int DEFAULT_CAPACITY = 16; // 默认数组长度
static final int TREEIFY_THRESHOLD = 8; // 链表转红黑树的一个条件
static final int UNTREEIFY_THRESHOLD = 6; // 红黑树转链表的一个条件
static final int MIN_TREEIFY_CAPACITY = 64; // 链表转红黑树的另一个条件
static final int MOVED = -1; // 表示正在扩容转移
static final int TREEBIN = -2; // 表示已经转换成树
static final int RESERVED = -3; // hash for transient reservations
static final int HASH_BITS = 0x7fffffff; // 获得hash值的辅助参数
transient volatile Node<K,V>[] table;// 默认没初始化的数组,用来保存元素
private transient volatile Node<K,V>[] nextTable; // 转移的时候用的数组
static final int NCPU = Runtime.getRuntime().availableProcessors();// 获取可用的CPU个数
private transient volatile Node<K,V>[] nextTable; // 连接表,用于哈希表扩容,扩容完成后会被重置为 null
private transient volatile long baseCount;保存着整个哈希表中存储的所有的结点的个数总和,有点类似于 HashMap 的 size 属性。private transient volatile int
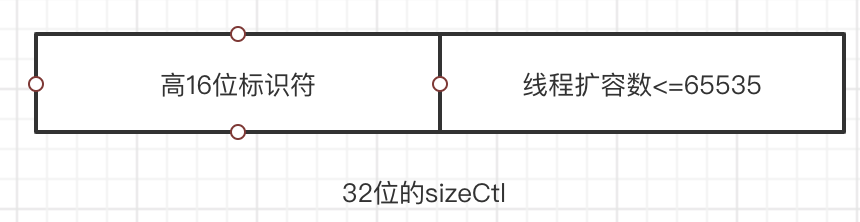
sizeCtl;负数:表示进行初始化或者扩容,-1:表示正在初始化,-N:表示有 N-1 个线程正在进行扩容 正数:0 表示还没有被初始化,> 0的数:初始化或者是下一次进行扩容的阈值,有点类似HashMap中的
threshold,不过功能**「更强大」**。
若干重要类
- 构成每个元素的基本类
Node
static class Node<K,V> implements Map.Entry<K,V> {
              final int hash;    // key的hash值
              final K key;       // key
              volatile V val;    // value
              volatile Node<K,V> next;
               //表示链表中的下一个节点
}- TreeNode继承于Node,用来存储红黑树节点
static final class TreeNode<K,V> extends Node<K,V> {
              TreeNode<K,V> parent;
              // 红黑树的父亲节点
              TreeNode<K,V> left;
              // 左节点
              TreeNode<K,V> right;
             // 右节点
              TreeNode<K,V> prev;
             // 前节点
              boolean red;
             // 是否为红点
}- ForwardingNode 在 Node 的子类
ForwardingNode的构造方法中,可以看到此变量的hash = 「-1」 ,类中还存储nextTable的引用。该初始化方法只在transfer方法被调用,如果一个类被设置成此种情况并且hash = -1 则说明该节点不需要resize了。
static final class ForwardingNode<K,V> extends Node<K,V> {
        final Node<K,V>[] nextTable;
        ForwardingNode(Node<K,V>[] tab) {
            //注意这里
            super(MOVED, null, null, null);
            this.nextTable = tab;
        }
 //.....
}- TreeBin TreeBin从字面含义中可以理解为存储树形结构的容器,而树形结构就是指TreeNode,所以TreeBin就是封装TreeNode的容器,它提供转换黑红树的一些条件和锁的控制.
static final class TreeBin<K,V> extends Node<K,V> {
        TreeNode<K,V> root;
        volatile TreeNode<K,V> first;
        volatile Thread waiter;
        volatile int lockState;
        // values for lockState
        static final int WRITER = 1; // set while holding write lock
        static final int WAITER = 2; // set when waiting for write lock
        static final int READER = 4; // increment value for setting read lock
}
整体的构造情况基本跟HashMap类似,并且为了跟原来的JDK7中的兼容性还可以传入并发度。不过JDK8中并发度已经有table的具体长度来控制了。
- ConcurrentHashMap():创建一个带有默认初始容量 (16)、加载因子 (0.75) 和 concurrencyLevel (16) 的新的空映射
- ConcurrentHashMap(int):创建一个带有指定初始容量
tableSizeFor、默认加载因子 (0.75) 和 concurrencyLevel (16) 的新的空映射 - ConcurrentHashMap(Map<? extends K, ? extends V> m):构造一个与给定映射具有相同映射关系的新映射
- ConcurrentHashMap(int initialCapacity, float loadFactor):创建一个带有指定初始容量、加载因子和默认 concurrencyLevel (1) 的新的空映射
- ConcurrentHashMap(int, float, int):创建一个带有指定初始容量、加载因子和并发级别的新的空映射。
假设table已经初始化完成,put操作采用 CAS + synchronized 实现并发插入或更新操作,具体实现如下。
- 做一些边界处理,然后获得hash值。
- 没初始化就初始化,初始化后看下对应的桶是否为空,为空就原子性的尝试插入。
- 如果当前节点正在扩容还要去帮忙扩容,骚操作。
- 用
syn来加锁当前节点,然后操作几乎跟就跟hashmap一样了。
// Node 节点的 hash值在HashMap中存储的就是hash值,在currenthashmap中可能有多种情况哦!
final V putVal(K key, V value, boolean onlyIfAbsent) {
    if (key  null || value  null) throw new NullPointerException(); //边界处理
    int hash = spread(key.hashCode());// 最终hash值计算
    int binCount = 0;
    for (Node<K,V>[] tab = table;;) { //循环表
        Node<K,V> f; int n, i, fh;
        if (tab  null || (n = tab.length)  0)
            tab = initTable(); // 初始化表 如果为空,懒汉式
        else if ((f = tabAt(tab, i = (n - 1) & hash))  null) {
        // 如果对应桶位置为空
            if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null)))
                         // CAS 原子性的尝试插入
                break;
        }
        else if ((fh = f.hash)  MOVED)
        // 如果当前节点正在扩容。还要帮着去扩容。
            tab = helpTransfer(tab, f);
        else {
            V oldVal = null;
            synchronized (f) { //  桶存在数据 加锁操作进行处理
                if (tabAt(tab, i)  f) {
                    if (fh >= 0) { // 如果存储的是链表 存储的是节点的hash值
                        binCount = 1;
                        for (Node<K,V> e = f;; ++binCount) {
                            K ek;
                            // 遍历链表去查找,如果找到key一样则选择性
                            if (e.hash  hash &&
                                ((ek = e.key)  key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            Node<K,V> pred = e;
                            if ((e = e.next)  null) {// 找到尾部插入
                                pred.next = new Node<K,V>(hash, key,
                                                          value, null);
                                break;
                            }
                        }
                    }
                    else if (f instanceof TreeBin) {// 如果桶节点类型为TreeBin
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                                       value)) != null) {
                             // 尝试红黑树插入,同时也要防止节点本来就有,选择性覆盖
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                }
            }
            if (binCount != 0) { // 如果链表数量
                if (binCount >= TREEIFY_THRESHOLD)
                    treeifyBin(tab, i); //  链表转红黑树哦!
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount); // 统计大小 并且检查是否要扩容。
    return null;
}涉及到重要函数initTable、tabAt、casTabAt、helpTransfer、putTreeVal、treeifyBin、addCount函数。
**「只允许一个线程」**对表进行初始化,如果不巧有其他线程进来了,那么会让其他线程交出 CPU 等待下次系统调度Thread.yield。这样,保证了表同时只会被一个线程初始化,对于table的大小,会根据sizeCtl的值进行设置,如果没有设置szieCtl的值,那么默认生成的table大小为16,否则,会根据sizeCtl的大小设置table大小。
// 容器初始化 操作
private final Node<K,V>[] initTable() {
    Node<K,V>[] tab; int sc;
    while ((tab = table)  null || tab.length  0) {
        if ((sc = sizeCtl) < 0) // 如果正在初始化-1,-N 正在扩容。
            Thread.yield(); // 进行线程让步等待
     // 让掉当前线程 CPU 的时间片,使正在运行中的线程重新变成就绪状态,并重新竞争 CPU 的调度权。
     // 它可能会获取到,也有可能被其他线程获取到。
        else if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {
          //  比较sizeCtl的值与sc是否相等,相等则用 -1 替换,这表明我这个线程在进行初始化了!
            try {
                if ((tab = table)  null || tab.length  0) {
                    int n = (sc > 0) ? sc : DEFAULT_CAPACITY; // 默认为16
                    @SuppressWarnings("unchecked")
                    Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                    table = tab = nt;
                    sc = n - (n >>> 2); // sc = 0.75n
                }
            } finally {
                sizeCtl = sc; //设置sizeCtl 类似threshold
            }
            break;
        }
    }
    return tab;
}
在ConcurrentHashMap中使用了unSafe方法,通过直接操作内存的方式来保证并发处理的安全性,使用的是硬件的安全机制。
// 用来返回节点数组的指定位置的节点的原子操作
@SuppressWarnings("unchecked")
static final <K,V> Node<K,V> tabAt(Node<K,V>[] tab, int i) {
    return (Node<K,V>)U.getObjectVolatile(tab, ((long)i << ASHIFT) + ABASE);
}
// cas原子操作,在指定位置设定值
static final <K,V> boolean casTabAt(Node<K,V>[] tab, int i,
                                    Node<K,V> c, Node<K,V> v) {
    return U.compareAndSwapObject(tab, ((long)i << ASHIFT) + ABASE, c, v);
}
// 原子操作,在指定位置设定值
static final <K,V> void setTabAt(Node<K,V>[] tab, int i, Node<K,V> v) {
    U.putObjectVolatile(tab, ((long)i << ASHIFT) + ABASE, v);
}
// 比较table数组下标为i的结点是否为c,若为c,则用v交换操作。否则,不进行交换操作。
static final <K,V> boolean casTabAt(Node<K,V>[] tab, int i,
                                    Node<K,V> c, Node<K,V> v) {
    return U.compareAndSwapObject(tab, ((long)i << ASHIFT) + ABASE, c, v);
}可以看到获得table[i]数据是通过Unsafe对象通过反射获取的,取数据直接table[index]不可以么,为什么要这么复杂?在java内存模型中,我们已经知道每个线程都有一个工作内存,里面存储着table的**「副本」,虽然table是volatile修饰的,但不能保证线程每次都拿到table中的最新元素,Unsafe.getObjectVolatile可以直接获取指定内存的数据,「保证了每次拿到数据都是最新的」**。
// 可能有多个线程在同时帮忙运行helpTransfer
final Node<K,V>[] helpTransfer(Node<K,V>[] tab, Node<K,V> f) {
    Node<K,V>[] nextTab; int sc;
    if (tab != null && (f instanceof ForwardingNode) && (nextTab = ((ForwardingNode<K,V>)f).nextTable) != null) {
        // table不是空  且 node节点是转移类型,并且转移类型的nextTable 不是空 说明还在扩容ing
        int rs = resizeStamp(tab.length);
        // 根据 length 得到一个前16位的标识符,数组容量大小。
        // 确定新table指向没有变,老table数据也没变,并且此时 sizeCtl小于0 还在扩容ing
        while (nextTab  nextTable && table  tab && (sc = sizeCtl) < 0) {
            if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc  rs + 1 || sc  rs + MAX_RESIZERS || transferIndex <= 0)
            // 1. sizeCtl 无符号右移16位获得高16位如果不等 rs 标识符变了
            // 2. 如果扩容结束了 这里可以看 trePresize 函数第一次扩容操作:
            // 默认第一个线程设置 sc = rs 左移 16 位 + 2,当第一个线程结束扩容了,
            // 就会将 sc 减一。这个时候,sc 就等于 rs + 1。
            // 3. 如果达到了最大帮助线程个数 65535个
            // 4. 如果转移下标调整ing 扩容已经结束了
                break;
            if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1)) {
            // 如果以上都不是, 将 sizeCtl + 1,增加一个线程来扩容
                transfer(tab, nextTab); // 进行转移
                break;// 结束循环
            }
        }
        return nextTab;
    }
    return table;
}- Integer.numberOfLeadingZeros(n)
该方法的作用是**「返回无符号整型i的最高非零位前面的0的个数」**,包括符号位在内;如果i为负数,这个方法将会返回0,符号位为1. 比如说,10的二进制表示为 0000 0000 0000 0000 0000 0000 0000 1010 java的整型长度为32位。那么这个方法返回的就是28
- resizeStamp 主要用来获得标识符,可以简单理解是对当前系统容量大小的一种监控。
static final int resizeStamp(int n) {
   return Integer.numberOfLeadingZeros(n) | (1 << (RESIZE_STAMP_BITS - 1));
   //RESIZE_STAMP_BITS = 16
}
主要就2件事:一是更新 baseCount,二是判断是否需要扩容。
private final void addCount(long x, int check) {
 CounterCell[] as; long b, s;
 // 首先如果没有并发 此时countCells is null, 此时尝试CAS设置数据值。
 if ((as = counterCells) != null || !U.compareAndSwapLong(this, BASECOUNT, b = baseCount, s = b + x)) {
     // 如果 counterCells不为空以为此时有并发的设置 或者 CAS设置 baseCount 失败了
     CounterCell a; long v; int m;
     boolean uncontended = true;
     if (as  null || (m = as.length - 1) < 0 || (a = as[ThreadLocalRandom.getProbe() & m])  null ||
         !(uncontended = U.compareAndSwapLong(a, CELLVALUE, v = a.value, v + x))) {
         // 1. 如果没出现并发 此时计数盒子为 null
         // 2. 随机取出一个数组位置发现为空
         // 3. 出现并发后修改这个cellvalue 失败了
         // 执行funAddCount
         fullAddCount(x, uncontended);// 死循环操作
         return;
     }
     if (check <= 1)
         return;
     s = sumCount(); // 吧counterCells数组中的每一个数据进行累加给baseCount。
 }
 // 如果需要扩容
 if (check >= 0) {
  Node<K,V>[] tab, nt; int n, sc;
  while (s >= (long)(sc = sizeCtl) && (tab = table) != null && (n = tab.length) < MAXIMUM_CAPACITY) {
   int rs = resizeStamp(n);// 获得高位标识符
   if (sc < 0) { // 是否需要帮忙去扩容
    if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc  rs + 1 ||
     sc  rs + MAX_RESIZERS || (nt = nextTable)  null || transferIndex <= 0)
     break;
    if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1))
     transfer(tab, nt);
   } // 第一次扩容
   else if (U.compareAndSwapInt(this, SIZECTL, sc, (rs << RESIZE_STAMP_SHIFT) + 2))
    transfer(tab, null);
   s = sumCount();
  }
 }
}- baseCount添加
ConcurrentHashMap提供了baseCount、counterCells两个辅助变量和一个CounterCell辅助内部类。sumCount() 就是迭代counterCells来统计 sum 的过程。put 操作时,肯定会影响size(),在put()方法最后会调用addCount()方法。整体的思维方法跟LongAdder类似,用的思维就是借鉴的ConcurrentHashMap。每一个Cell都用Contended修饰来避免伪共享。
- JDK1.7 和 JDK1.8 对 size 的计算是不一样的。1.7 中是先不加锁计算三次,如果三次结果不一样在加锁。
- JDK1.8 size 是通过对 baseCount 和 counterCell 进行 CAS 计算,最终通过 baseCount 和 遍历 CounterCell 数组得出 size。
- JDK 8 推荐使用mappingCount 方法,因为这个方法的返回值是 long 类型,不会因为 size 方法是 int 类型限制最大值。
- 关于扩容
 在
addCount第一次扩容时候会有骚操作sc=rs << RESIZE_STAMP_SHIFT) + 2)其中rs = resizeStamp(n)。这里需要核心说一点,
 如果不是第一次扩容则直接将低16位的数字 +1 即可。
这个操作几乎跟HashMap的操作完全一样,核心思想就是一定要决定向左还是向右然后最终尝试放置新数据,然后balance。不同点就是有锁的考虑。
这里的基本思路跟HashMap几乎一样,不同点就是先变成TreeNode,然后是**「单向链表」**串联。
private final void treeifyBin(Node<K,V>[] tab, int index) {
    Node<K,V> b; int n, sc;
    if (tab != null) {
        //如果整个table的数量小于64,就扩容至原来的一倍,不转红黑树了
        //因为这个阈值扩容可以减少hash冲突,不必要去转红黑树
        if ((n = tab.length) < MIN_TREEIFY_CAPACITY)
            tryPresize(n << 1);
        else if ((b = tabAt(tab, index)) != null && b.hash >= 0) {
            synchronized (b) { //锁定当前桶
                if (tabAt(tab, index)  b) {
                    TreeNode<K,V> hd = null, tl = null;
                    for (Node<K,V> e = b; e != null; e = e.next) {
                        //遍历这个链表然后将每个节点封装成TreeNode,最终单链表串联起来,
                        // 最终 调用setTabAt 放置红黑树
                        TreeNode<K,V> p =
                            new TreeNode<K,V>(e.hash, e.key, e.val,
                                              null, null);
                        if ((p.prev = tl)  null)
                            hd = p;
                        else
                            tl.next = p;
                        tl = p;
                    }
                    //通过TreeBin对象对TreeNode转换成红黑树
                    setTabAt(tab, index, new TreeBin<K,V>(hd));
                }
            }
        }
    }
}
主要功能就是链表变化为红黑树,这个红黑树用TreeBin来包装。并且要注意 转成红黑树以后以前链表的结构信息还是有的,最终信息如下:
- TreeBin.first = 链表中第一个节点。
- TreeBin.root = 红黑树中的root节点。
TreeBin(TreeNode<K,V> b) {
            super(TREEBIN, null, null, null);
            //创建空节点 hash = -2
            this.first = b;
            TreeNode<K,V> r = null; // root 节点
            for (TreeNode<K,V> x = b, next; x != null; x = next) {
                next = (TreeNode<K,V>)x.next;
                x.left = x.right = null;
                if (r  null) {
                    x.parent = null;
                    x.red = false;
                    r = x; // root 节点设置为x
                }
                else {
                    K k = x.key;
                    int h = x.hash;
                    Class<?> kc = null;
                    for (TreeNode<K,V> p = r;;) {
                   // x代表的是转换为树之前的顺序遍历到链表的位置的节点,r代表的是根节点
                        int dir, ph;
                        K pk = p.key;
                        if ((ph = p.hash) > h)
                            dir = -1;
                        else if (ph < h)
                            dir = 1;
                        else if ((kc  null &&
                                  (kc = comparableClassFor(k))  null) ||
                                 (dir = compareComparables(kc, k, pk))  0)
                            dir = tieBreakOrder(k, pk);
                            // 当key不可以比较,或者相等的时候采取的一种排序措施
                            TreeNode<K,V> xp = p;
                        // 放一定是放在叶子节点上,如果还没找到叶子节点则进行循环往下找。
                        // 找到了目前叶子节点才会进入 再放置数据
                        if ((p = (dir <= 0) ? p.left : p.right)  null) {
                            x.parent = xp;
                            if (dir <= 0)
                                xp.left = x;
                            else
                                xp.right = x;
                            r = balanceInsertion(r, x);
                     // 每次插入一个元素的时候都调用 balanceInsertion 来保持红黑树的平衡
                            break;
                        }
                    }
                }
            }
            this.root = r;
            assert checkInvariants(root);
        }
当数组长度小于64的时候,扩张数组长度一倍,调用此函数。扩容后容量大小的核对,可能涉及到初始化容器大小。并且扩容的时候又跟2的次幂联系上了!,其中初始化时候传入map会调用putAll方法直接put一个map的话,在**「putAll」**方法中没有调用initTable方法去初始化table,而是直接调用了tryPresize方法,所以这里需要做一个是不是需要初始化table的判断。
PS:默认第一个线程设置 sc = rs 左移 16 位 + 2,当第一个线程结束扩容了,就会将 sc 减一。这个时候,sc 就等于 rs + 1,这个时候说明扩容完毕了。
/**
     * 扩容表为指可以容纳指定个数的大小(总是2的N次方)
     * 假设原来的数组长度为16,则在调用tryPresize的时候,size参数的值为16<<1(32),此时sizeCtl的值为12
     * 计算出来c的值为64, 则要扩容到 sizeCtl ≥ c
     *  第一次扩容之后 数组长:32 sizeCtl:24
     *  第三次扩容之后 数组长:128  sizeCtl:96 退出
     */
    private final void tryPresize(int size) {
        int c = (size >= (MAXIMUM_CAPACITY >>> 1)) ? MAXIMUM_CAPACITY :
            tableSizeFor(size + (size >>> 1) + 1); // 合理范围
        int sc;
        while ((sc = sizeCtl) >= 0) {
            Node<K,V>[] tab = table; int n;
                if (tab  null || (n = tab.length)  0) {
                // 初始化传入map,今天putAll会直接调用这个。
                n = (sc > c) ? sc : c;
                if (U.compareAndSwapInt(this, SIZECTL, sc, -1)) {
                //初始化tab的时候,把 sizeCtl 设为 -1
                    try {
                        if (table  tab) {
                            @SuppressWarnings("unchecked")
                            Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n];
                            table = nt;
                            sc = n - (n >>> 2); // sc=sizeCtl = 0.75n
                        }
                    } finally {
                        sizeCtl = sc;
                    }
                }
            }
             // 初始化时候如果  数组容量<=sizeCtl 或 容量已经最大化了则退出
            else if (c <= sc || n >= MAXIMUM_CAPACITY) {
                    break;//退出扩张
            }
            else if (tab  table) {
                int rs = resizeStamp(n);
                if (sc < 0) { // sc = siztCtl 如果正在扩容Table的话,则帮助扩容
                    Node<K,V>[] nt;
                    if ((sc >>> RESIZE_STAMP_SHIFT) != rs || sc  rs + 1 ||
                        sc  rs + MAX_RESIZERS || (nt = nextTable)  null ||
                        transferIndex <= 0)
                        break; // 各种条件判断是否需要加入扩容工作。
                     // 帮助转移数据的线程数 + 1
                    if (U.compareAndSwapInt(this, SIZECTL, sc, sc + 1))
                        transfer(tab, nt);
                }
                 // 没有在初始化或扩容,则开始扩容
                 // 此处切记第一次扩容 直接 +2
                else if (U.compareAndSwapInt(this, SIZECTL, sc,
                      (rs << RESIZE_STAMP_SHIFT) + 2)) {
                        transfer(tab, null);
                }
            }
        }
    }
这里代码量比较大主要分文三部分,并且感觉思路很精髓,尤其**「是其他线程帮着去扩容的骚操作」**。
- 主要是 单个线程能处理的最少桶结点个数的计算和一些属性的初始化操作。
- 每个线程进来会先领取自己的任务区间
[bound,i],然后开始 --i 来遍历自己的任务区间,对每个桶进行处理。如果遇到桶的头结点是空的,那么使用ForwardingNode标识旧table中该桶已经被处理完成了。如果遇到已经处理完成的桶,直接跳过进行下一个桶的处理。如果是正常的桶,对桶首节点加锁,正常的迁移即可(跟HashMap第三部分一样思路),迁移结束后依然会将原表的该位置标识位已经处理。
该函数中的finish= true 则说明整张表的迁移操作已经**「全部」**完成了,我们只需要重置 table的引用并将 nextTable 赋为空即可。否则,CAS 式的将 sizeCtl减一,表示当前线程已经完成了任务,退出扩容操作。如果退出成功,那么需要进一步判断当前线程是否就是最后一个在执行扩容的。
f ((sc - 2) != resizeStamp(n) << RESIZE_STAMP_SHIFT)
return;第一次扩容时在addCount中有写到(resizeStamp(n) << RESIZE_STAMP_SHIFT) + 2 表示当前只有一个线程正在工作,「相对应的」,如果 (sc - 2) resizeStamp(n) << RESIZE_STAMP_SHIFT,说明当前线程就是最后一个还在扩容的线程,那么会将 finishing 标识为 true,并在下一次循环中退出扩容方法。
- 几乎跟
HashMap大致思路类似的遍历链表/红黑树然后扩容操作。
private final void transfer(Node<K,V>[] tab, Node<K,V>[] nextTab) {
    int n = tab.length, stride;
    if ((stride = (NCPU > 1) ? (n >>> 3) / NCPU : n) < MIN_TRANSFER_STRIDE)    //MIN_TRANSFER_STRIDE 用来控制不要占用太多CPU
        stride = MIN_TRANSFER_STRIDE; // subdivide range    //MIN_TRANSFER_STRIDE=16 每个CPU处理最小长度个数
    if (nextTab  null) { // 新表格为空则直接新建二倍,别的辅助线程来帮忙扩容则不会进入此if条件
        try {
            @SuppressWarnings("unchecked")
            Node<K,V>[] nt = (Node<K,V>[])new Node<?,?>[n << 1];
            nextTab = nt;
        } catch (Throwable ex) {      // try to cope with OOME
            sizeCtl = Integer.MAX_VALUE;
            return;
        }
        nextTable = nextTab;
        transferIndex = n; // transferIndex 指向最后一个桶,方便从后向前遍历
    }
    int nextn = nextTab.length; // 新表长度
    ForwardingNode<K,V> fwd = new ForwardingNode<K,V>(nextTab); // 创建一个fwd节点,这个是用来控制并发的,当一个节点为空或已经被转移之后,就设置为fwd节点
    boolean advance = true;    //是否继续向前查找的标志位
    boolean finishing = false; // to ensure sweep(清扫) before committing nextTab,在完成之前重新在扫描一遍数组,看看有没完成的没
     // 第一部分
    // i 指向当前桶, bound 指向当前线程需要处理的桶结点的区间下限【bound,i】 这样来跟线程划分任务。
    for (int i = 0, bound = 0;;) {
        Node<K,V> f; int fh;
       // 这个 while 循环的目的就是通过 --i 遍历当前线程所分配到的桶结点
       // 一个桶一个桶的处理
        while (advance) {//  每一次成功处理操作都会将advance设置为true,然里来处理区间的上一个数据
            int nextIndex, nextBound;
            if (--i >= bound || finishing) { //通过此处进行任务区间的遍历
                advance = false;
            }
            else if ((nextIndex = transferIndex) <= 0) {
                i = -1;// 任务分配完了
                advance = false;
            }
            // 更新 transferIndex
           // 为当前线程分配任务,处理的桶结点区间为(nextBound,nextIndex)
            else if (U.compareAndSwapInt(this, TRANSFERINDEX, nextIndex,nextBound = (nextIndex > stride ? nextIndex - stride : 0))) {
               // nextIndex本来等于末尾数字,
                bound = nextBound;
                i = nextIndex - 1;
                advance = false;
            }
        }
        // 当前线程所有任务完成
        if (i < 0 || i >= n || i + n >= nextn) {
            int sc;
            if (finishing) {  // 已经完成转移 则直接赋值操作
                nextTable = null;
                table = nextTab;
                sizeCtl = (n << 1) - (n >>> 1);    //设置sizeCtl为扩容后的0.75
                return;
            }
            if (U.compareAndSwapInt(this, SIZECTL, sc = sizeCtl, sc - 1)) { // sizeCtl-1 表示当前线程任务完成。
                if ((sc - 2) != resizeStamp(n) << RESIZE_STAMP_SHIFT) {
                // 判断当前线程完成的线程是不是最后一个在扩容的,思路精髓
                        return;
                }
                finishing = advance = true;// 如果是则相应的设置参数
                i = n;
            }
        }
        else if ((f = tabAt(tab, i))  null) // 数组中把null的元素设置为ForwardingNode节点(hash值为MOVED[-1])
            advance = casTabAt(tab, i, null, fwd); // 如果老节点数据是空的则直接进行CAS设置为fwd
        else if ((fh = f.hash)  MOVED) //已经是个fwd了,因为是多线程操作 可能别人已经给你弄好了,
            advance = true; // already processed
        else {
            synchronized (f) { //加锁操作
                if (tabAt(tab, i)  f) {
                    Node<K,V> ln, hn;
                    if (fh >= 0) { //该节点的hash值大于等于0,说明是一个Node节点
                    // 关于链表的操作整体跟HashMap类似不过 感觉好像更扰一些。
                        int runBit = fh & n; // fh= f.hash first hash的意思,看第一个点 放老位置还是新位置
                        Node<K,V> lastRun = f;
                        for (Node<K,V> p = f.next; p != null; p = p.next) {
                            int b = p.hash & n;    //n的值为扩张前的数组的长度
                            if (b != runBit) {
                                runBit = b;
                                lastRun = p;//最后导致发生变化的节点
                            }
                        }
                        if (runBit  0) { //看最后一个变化点是新还是旧 旧
                            ln = lastRun;
                            hn = null;
                        }
                        else {
                            hn = lastRun; //看最后一个变化点是新还是旧 旧
                            ln = null;
                        }
                        /*
                         * 构造两个链表,顺序大部分和原来是反的,不过顺序也有差异
                         * 分别放到原来的位置和新增加的长度的相同位置(i/n+i)
                         */
                        for (Node<K,V> p = f; p != lastRun; p = p.next) {
                            int ph = p.hash; K pk = p.key; V pv = p.val;
                            if ((ph & n)  0)
                                    /*
                                     * 假设runBit的值为0,
                                     * 则第一次进入这个设置的时候相当于把旧的序列的最后一次发生hash变化的节点(该节点后面可能还有hash计算后同为0的节点)设置到旧的table的第一个hash计算后为0的节点下一个节点
                                     * 并且把自己返回,然后在下次进来的时候把它自己设置为后面节点的下一个节点
                                     */
                                ln = new Node<K,V>(ph, pk, pv, ln);
                            else
                                    /*
                                     * 假设runBit的值不为0,
                                     * 则第一次进入这个设置的时候相当于把旧的序列的最后一次发生hash变化的节点(该节点后面可能还有hash计算后同不为0的节点)设置到旧的table的第一个hash计算后不为0的节点下一个节点
                                     * 并且把自己返回,然后在下次进来的时候把它自己设置为后面节点的下一个节点
                                     */
                                hn = new Node<K,V>(ph, pk, pv, hn);
                        }
                        setTabAt(nextTab, i, ln);
                        setTabAt(nextTab, i + n, hn);
                        setTabAt(tab, i, fwd);
                        advance = true;
                    }
                    else if (f instanceof TreeBin) { // 该节点hash值是个负数否则的话是一个树节点
                        TreeBin<K,V> t = (TreeBin<K,V>)f;
                        TreeNode<K,V> lo = null, loTail = null; // 旧 头尾
                        TreeNode<K,V> hi = null, hiTail = null; //新头围
                        int lc = 0, hc = 0;
                        for (Node<K,V> e = t.first; e != null; e = e.next) {
                            int h = e.hash;
                            TreeNode<K,V> p = new TreeNode<K,V>
                                (h, e.key, e.val, null, null);
                            if ((h & n)  0) {
                                if ((p.prev = loTail)  null)
                                    lo = p;
                                else
                                    loTail.next = p; //旧头尾设置
                                loTail = p;
                                ++lc;
                            }
                            else { // 新头围设置
                                if ((p.prev = hiTail)  null)
                                    hi = p;
                                else
                                    hiTail.next = p;
                                hiTail = p;
                                ++hc;
                            }
                        }
                         //ln  如果老位置数字<=6 则要对老位置链表进行红黑树降级到链表,否则就看是否还需要对老位置数据进行新建红黑树
                        ln = (lc <= UNTREEIFY_THRESHOLD) ? untreeify(lo) :
                            (hc != 0) ? new TreeBin<K,V>(lo) : t;
                        hn = (hc <= UNTREEIFY_THRESHOLD) ? untreeify(hi) :
                            (lc != 0) ? new TreeBin<K,V>(hi) : t;
                        setTabAt(nextTab, i, ln);
                        setTabAt(nextTab, i + n, hn);
                        setTabAt(tab, i, fwd); //老表中i位置节点设置下
                        advance = true;
                    }
                }
            }
        }
    }
}
这个就很简单了,获得hash值,然后判断存在与否,遍历链表即可,注意get没有任何锁操作!
public V get(Object key) {
        Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek;
        // 计算key的hash值
        int h = spread(key.hashCode());
        if ((tab = table) != null && (n = tab.length) > 0 &&
            (e = tabAt(tab, (n - 1) & h)) != null) { // 表不为空并且表的长度大于0并且key所在的桶不为空
            if ((eh = e.hash)  h) { // 表中的元素的hash值与key的hash值相等
                if ((ek = e.key)  key || (ek != null && key.equals(ek))) // 键相等
                    // 返回值
                    return e.val;
            }
            else if (eh < 0) // 是个TreeBin hash = -2
                // 在红黑树中查找,因为红黑树中也保存这一个链表顺序
                return (p = e.find(h, key)) != null ? p.val : null;
            while ((e = e.next) != null) { // 对于结点hash值大于0的情况链表
                if (e.hash  h &&
                    ((ek = e.key)  key || (ek != null && key.equals(ek))))
                    return e.val;
            }
        }
        return null;
    }
关于清空也相对简单 ,无非就是遍历桶数组,然后通过CAS来置空。
public void clear() {
    long delta = 0L;
    int i = 0;
    Node<K,V>[] tab = table;
    while (tab != null && i < tab.length) {
        int fh;
        Node<K,V> f = tabAt(tab, i);
        if (f  null)
            ++i; //这个桶是空的直接跳过
        else if ((fh = f.hash)  MOVED) { // 这个桶的数据还在扩容中,要去扩容同时等待。
            tab = helpTransfer(tab, f);
            i = 0; // restart
        }
        else {
            synchronized (f) { // 真正的删除
                if (tabAt(tab, i)  f) {
                    Node<K,V> p = (fh >= 0 ? f :(f instanceof TreeBin) ?((TreeBin<K,V>)f).first : null);
                        //循环到链表/者红黑树的尾部
                        while (p != null) {
                            --delta; // 记录删除了多少个
                            p = p.next;
                        }
                        //利用CAS无锁置null
                        setTabAt(tab, i++, null);
                    }
                }
            }
        }
        if (delta != 0L)
            addCount(delta, -1); //调整count
    }
end
ConcurrentHashMap是如果来做到**「并发安全」,又是如何做到「高效」**的并发的呢?
- 首先是读操作,读源码发现get方法中根本没有使用同步机制,也没有使用
unsafe方法,所以读操作是支持并发操作的。 - 写操作
数据扩容函数是
transfer,该方法的只有addCount,helpTransfer和tryPresize这三个方法来调用。
- addCount是在当对数组进行操作,使得数组中存储的元素个数发生了变化的时候会调用的方法。
helpTransfer是在当一个线程要对table中元素进行操作的时候,如果检测到节点的·hash·= MOVED 的时候,就会调用helpTransfer方法,在helpTransfer中再调用transfer方法来帮助完成数组的扩容**tryPresize**是在**treeIfybin**和**putAll**方法中调用,**treeIfybin**主要是在**put**添加元素完之后,判断该数组节点相关元素是不是已经超过8个的时候,如果超过则会调用这个方法来扩容数组或者把链表转为树。注意**putAll**在初始化传入一个大map的时候会调用。·
总结扩容情况发生:
- 在往map中添加元素的时候,在某一个节点的数目已经超过了8个,同时数组的长度又小于64的时候,才会触发数组的扩容。
- 当数组中元素达到了sizeCtl的数量的时候,则会调用transfer方法来进行扩容
- 扩容时候是否可以进行读写。
对于读操作,因为是没有加锁的所以可以的. 对于写操作,JDK8中已经将锁的范围细腻到
table[i]l了,当在进行数组扩容的时候,如果当前节点还没有被处理(也就是说还没有设置为fwd节点),那就可以进行设置操作。如果该节点已经被处理了,则当前线程也会加入到扩容的操作中去。
- 多个线程又是如何同步处理的 在
ConcurrentHashMap中,同步处理主要是通过Synchronized和unsafe的硬件级别原子性 这两种方式来完成的。
- 在取得sizeCtl跟某个位置的Node的时候,使用的都是
unsafe的方法,来达到并发安全的目的- 当需要在某个位置设置节点的时候,则会通过
Synchronized的同步机制来锁定该位置的节点。- 在数组扩容的时候,则通过处理的
步长和fwd节点来达到并发安全的目的,通过设置hash值为MOVED=-1。- 当把某个位置的节点复制到扩张后的table的时候,也通过
Synchronized的同步机制来保证线程安全